TO、MPC与WBC在机器人控制中的作用与区别对比文档
本文目录 展开章节导航
TO、MPC 和 WBC 不是三种互斥算法:TO 描述如何优化一段轨迹,MPC 描述如何滚动求解并利用反馈执行,WBC 描述如何协调全身多个任务。一个 MPC 内部可以求解 TO 问题,WBC 也可以采用不同形式的控制器。
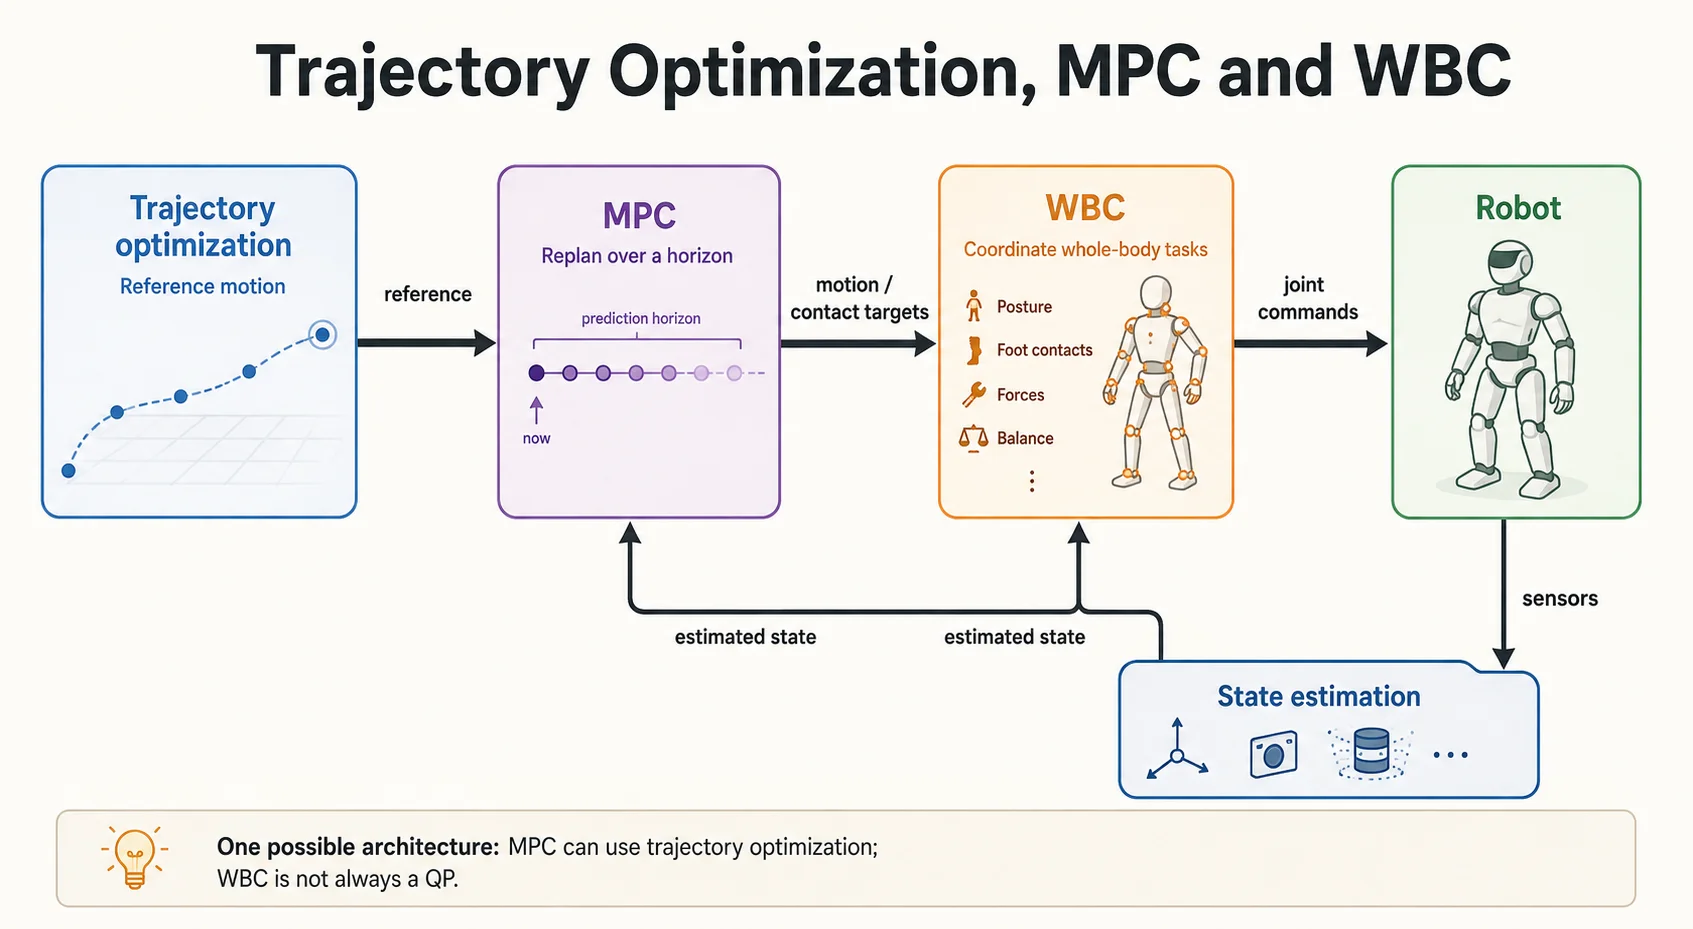
第一次读可以按三轮推进:先读第 1–4 节画出闭环,再读第 6–8 节把模型写成优化问题,最后跟着第 8.2–9 节运行 Python。本文的最小实验只需要矩阵乘法和 NumPy;动力学 WBC 部分还需要了解雅可比与刚体动力学。
| 学习目标 | 阅读与操作入口 | 完成后应能解释 |
|---|---|---|
| 看懂分层 | MPC、WBC | 未来序列和当前拍命令的区别 |
| 手算优化问题 | 矩阵推导、逐步教程 | H、g、A 和边界从哪里来 |
| 独立运行 | NumPy 原子实验、双关节 WBC | 为什么约束会改变速度与任务分配 |
| 接通两个模块 | WholeBodyX 对照 | 参考插值、速度前馈与执行反馈 |
| 排错与扩展 | 参数实验 | 怎样区分任务残差、约束违约与模型缺失 |
| 验证闭环边界 | 扰动对照、短时域反例、参考失效 | 有反馈、有解、可持续执行分别意味着什么 |
第一次运行时,建议先完成只依赖 NumPy 的两项实验,再进入 WholeBodyX。下载实验包后,在终端所在目录执行下列命令;需要 Python 3.11+,激活命令适用于 Bash:
python3 -m zipfile -e control-lab.zip .
cd control-lab
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python atomic_control.py
python feedback_demo.py两项脚本正常结束后,用结果索引核对输出,再回到公式推导。不安装 WholeBodyX,也能完成 MPC 原子问题、加权与层级 WBC、不可达目标和扰动对照;涉及源码集成的步骤在第 9 节另行说明。
1. 从输入与输出理解职责
| 模块 | 典型输入 | 典型输出 | 主要问题 |
|---|---|---|---|
| TO:轨迹优化 | 初末状态、动力学、约束、代价 | 一段状态与控制轨迹 | 这段运动是否可行,代价有多大? |
| MPC:模型预测控制 | 当前状态、参考、预测模型 | 当前控制量及预测轨迹 | 执行后状态变了,接下来如何调整? |
| WBC:全身控制 | 任务目标、接触状态、机器人模型 | 关节力矩、速度或加速度等指令 | 多个任务如何共享关节和接触能力? |
TO 可以处理动力学、接触和时变约束,也可以在线求解。机器人 TO 往往是非凸问题,求解器得到的通常是局部解,不能笼统保证全局最优。
MPC 在每个周期更新状态,求解有限时域问题,执行当前一小段控制,再滚动向前。它可以采用简化模型,也可以使用更完整的模型。
WBC 常使用加权 QP 或任务优先级优化,但 WBC 本身不等于 QP;基于零空间投影等方法也可以实现全身协调。
2. 为什么需要不同时间尺度
长时域规划需要预见未来运动;关节层还需及时响应测量和接触变化。把问题分层,能让每层使用合适的模型与计算预算。
各层频率取决于问题规模、求解器、机器人硬件和稳定性要求。“TO 秒级、MPC 毫秒级、WBC 更快”只能作为某类系统的例子,不能作为定义。MPC 与 WBC 也不一定需要 GPU。
3. 以足式机器人为例
- 规划层产生落足、质心或末端参考。
- MPC 根据当前状态与接触计划,预测未来运动并调整控制目标。
- WBC 综合平衡、姿态、足端与操作任务,求解满足约束的关节指令。
- 状态估计器融合编码器、IMU 等信息,为下一轮规划和控制提供反馈。
对动力学 WBC,常见决策变量包括广义加速度、关节力矩和接触力。应同时检查浮动基动力学、摩擦约束、接触运动约束和执行器限制。高层目标不可行时,底层不能凭空保证精确跟踪。
4. 接口比模块名称更值得检查
| 接口问题 | 常见后果 | 检查方式 |
|---|---|---|
| 坐标系或力的正负号不一致 | 运动方向或接触力错误 | 单轴、静态场景验证 |
| 接触计划与实际接触不同 | 约束不成立、力矩突变 | 对比计划接触与传感器反馈 |
| 高层输出超过执行器能力 | WBC 不可行或长期饱和 | 记录约束余量与求解状态 |
| 状态估计或控制消息过期 | 跟踪抖动、稳定性下降 | 测量时间戳与完整控制延迟 |
5. 延伸阅读与工具
- MIT Underactuated Robotics:Trajectory Optimization:理解直接配点、约束和非凸优化。
- OCS2:用于最优控制与 MPC 的工具箱,需要用户定义或接入系统模型。
- TinyMPC:关注资源受限平台上的 MPC 求解。
- OpenLoong Dynamics Control:查看具体人形机器人中的 MPC 与 WBC 组合。
评估实现时,记录求解耗时分布、最坏控制周期、约束违反和失败恢复;只报告平均频率无法说明控制链路是否可靠。
6. MPC:优化未来序列,闭环执行当前一段
从当前估计状态 出发,通用有限时域问题可以写成:
是预测节点索引,N 是预测步数;、 分别为状态与控制, 表示接触模式。这里先把接触日程视为已知;若把接触时刻或接触集合一起优化,问题结构和求解难度也会改变。
代价表示偏好,约束表示允许范围。跟踪误差小的解如果要求地面提供向下拉脚的法向力,仍然不满足单侧接触条件。求解后采用当前第一项或第一小段,获得新测量后重新预测;旧轨迹可以用于 warm start,但不应脱离有效期与状态偏差检查一直播放。MIT 轨迹优化与 MPC
| 预测模型 | 常见决策量或输出 | 需要继续核对 |
|---|---|---|
| 质心/动量或单刚体模型 | 质心运动、接触力、动量变化 | 是否覆盖关节限位、运动学可达性和执行器力矩 |
| 带落脚变量的降阶模型 | 落脚点、接触日程、受力参考 | 接触日程是给定还是优化变量 |
| 全身模型 | 全身状态、力矩、接触力、反馈增益 | 与下游 WBC 的职责是否重叠 |
| WholeBodyX 当前关节积分模型 | 关节位置与速度参考 | 没有浮动基、接触力或惯性预测 |
状态估计与目标命令是两个入口:估计告诉控制器“现在在哪里”,目标说明“希望去哪里”。当前状态还应直接进入 WBC;低层伺服和真实执行器位于 WBC 输出之后,优化结果不能等同于已经实现的动作。
7. WBC:当前拍协调任务与物理约束
7.1 动力学 WBC 的决策变量
常见浮动基动力学方程为:
是构型, 是广义速度, 是广义加速度;、 分别为质量矩阵和偏置项。 选择执行器自由度, 为关节力矩。, 是环境施加于机器人的接触力或 wrench,二者必须使用一致的坐标与排列。
浮动基的六个速度自由度没有直接电机驱动;若姿态用四元数存储,构型维数 与速度维数 还可能不同,不能直接用逐元素相加更新构型。单点接触常用三维力,面接触可用六维 wrench 或多个接触点表达。
以 为决策变量,可以构造当前拍的加权 QP:
这里 ,,。任务残差可以来自摆动脚、躯干或姿态的期望加速度;对普通运动学任务有 。姿态误差需要使用旋转的局部表示,不能直接相减四元数。
保持静止的刚性支撑接触常写成 ;动力学、单侧法向力、摩擦边界和执行器限位分别进入等式或不等式约束。线性化摩擦锥可得到 QP;保留非线性锥或接触互补关系时,求解问题可能不再是同一种 QP。TSID 官方实现
7.2 权重、层级与求解失败
有限权重允许任务之间折中,不能把“大权重”称为严格优先级;第 8.5 节提供了相同任务下的数值对照。层级逆动力学或级联 QP 会约束低层不能破坏高层已经达到的最优结果。两者都还要处理不可行、数值误差与执行延迟。Herzog 等:层级逆动力学与动量控制
右脚离地时,如果它已经不再接触地面,相应接触力应被移除或约束为零;左脚仍承担支撑。若目标超出摩擦或力矩范围,应调整软任务、上层参考或接触计划。只有优化器报告成功还不够:错误的接触判断、质量惯量、状态估计或伺服带宽,都会使“模型可行”与“物理可行”分离。
7.3 从任务误差构造优化器的每一块
先看速度级控制。任务坐标由 给出,局部变化满足 。如果希望任务向参考位置移动,可以构造速度目标 。对普通位置任务,;旋转任务需要换成与雅可比坐标系一致的局部旋转误差。
将各任务堆入同一个决策向量 u,目标可以写为:
这里 的列数都是关节速度维度,行数由任务维度决定。即使两个任务没有使用相同的名称,只要其雅可比涉及相同的关节列,它们就可能发生耦合。H 的非对角元素记录这种耦合;它通常不能被解释为“每个关节单独选一个速度”。位置任务和姿态任务的单位不同,权重还承担误差尺度的协调作用,不能只根据权重数值大小判断物理重要性。
再回到动力学 WBC。以 排列变量后,一项加速度跟踪任务对应:
由于 才是任务实际加速度,漏掉 会改变跟踪问题。动力学与静止接触则能拼成硬等式:
这给出了第 7.1 节中 E 和 e 的具体来源。力矩边界选择 z 的力矩块,摩擦约束选择接触力块;运动学任务主要作用于加速度块。求解后仍需验证状态、约束残差和接口有效性,再由运行层消费对应输出。接触切换会改变活动雅可比和力变量,不能只改软任务权重而继续保留已经离地脚的刚性支撑约束。
8. WholeBodyX:把概念逐项映射到源码
以下结论来自 2026-09-08 检查的本地 WholeBodyX 工作树。该目录没有可解析的 Git HEAD,本仓库在 docs/wholebodyx-blog-reference.json 保存了所读文件的 SHA-256,用于识别具体源码快照。它目前是固定基座运动学验证框架,不能把其中的 H1 展示解释为动态行走或平衡验证。
| 源文件与接口 | 实际职责 | 输出/限制 |
|---|---|---|
mpc.py: JointMPC.solve | 有限时域关节速度 QP | JointPlan 包含 N+1 个位置、N 个速度、起始时间及步长 |
runtime.py: MPCReferenceManager.update | 校验参考并决定重规划或复用 | 当前参考位置、速度、原因;失败清除旧计划 |
tasks.py: PostureTask.linearize | 位置误差反馈与速度前馈 | 实际是速度目标:gain*(qref-q)+vref,不是加速度任务 |
wbc.py: KinematicWBC.step | 加权速度级最小二乘与硬关节边界 | VelocityCommand,不输出力矩或接触力 |
types.py: JointLimits.velocity_bounds | 组合速度、下一步位置及速度变化率限制 | 在积分模型与离散步长下约束指令 |
simulation.py: JointIntegrator | 执行速度积分 | 无质量、惯量、碰撞和接触动力学 |
WholeBodyX 的预测模型为:
代价对未来 跟踪关节目标,并惩罚速度;终端节点使用 terminal weight。约束包括关节位置、速度,以及可选的 。首个速度差相对当前测量速度计算。速度变化率限制不等于浮动基动力学或力矩可行性。
速度级 WBC 的任务为 ,加权残差与正则、平滑项进入目标。它同时限制:
若没有配置加速度限值,去掉对应两项。这里使用逐元素上下界,只对当前固定基座积分模型成立。它与第 7 节中同时求 的动力学 WBC 是不同层级的模型。
参考管理器会检查起点、时间戳、有效期、积分关系和限位。默认每 0.1 s 周期重规划,目标改变或关节位置预测偏差超过 0.03 rad 可提前触发;控制步长由调用方提供。刷新失败时返回失败并清除旧参考,而不是自动继续执行旧计划;真机停机/降级仍由硬件运行层负责。该同步调度没有硬实时保证。
8.1 从积分模型展开成求解器矩阵
将未来速度按时间堆成 ,未来位置堆成 。对 n 个关节有:
均有 Nn 个元素,B 为 矩阵。消去位置变量后,优化器只需求 Nn 个速度。对目标序列 ,令位置权重为 W、速度权重为 R,目标为:
因此,构造 Hessian 时不能漏掉速度代价 R,梯度也应使用“当前位置减目标”的方向。WholeBodyX 默认 W 的最后一个节点用 30 替换普通节点的 10,R 为 ,并非再给终端叠加一次普通权重。
约束可堆成 :I 对应速度边界,B 对应平移后的位置边界,差分矩阵 D 对应相邻速度变化。单关节两步时 ,第一行上下界必须加上当前速度 ,其余行以零为中心。这与 OSQP 使用的 QP 形式一致;正定目标给出唯一最优解的前提是约束可行。
8.2 仅用 NumPy 跑通原子算例
希望完整复现后续教程,可以下载实验包 control-lab.zip,其中含实验脚本、求解器回归测试、运行说明和基础依赖清单。解压后在 control-lab 目录执行下方步骤;只运行原子算例时,也可以单独下载脚本。WholeBodyX 源码不包含在实验包中,只有第 9 节的集成与参考失效实验需要另外安装它。
下载 atomic_control.py,在有 NumPy 的环境运行即可,不需要 WholeBodyX 源码:
python3 -m venv .venv-atomic
source .venv-atomic/bin/activate
python -m pip install numpy==2.3.5
python atomic_control.py该固定版本要求 Python 3.11 或更高版本。算例取一个关节、两个预测步骤, s,,目标位置 0.3 rad,位置边界 ±0.5 rad、速度边界 ±1 rad/s、速度变化率边界 ±2 rad/s²。此时:
最优速度为 rad/s,预测位置为 rad。两步末端尚未到达目标,因为速度变化率的硬边界限制了推进速度;增大目标权重不会消除这条约束。这次调用展示的是一次规划窗口,脚本的 rollout() 还会重复求解 100 次,形成积分模型上的滚动闭环;下一节再接入 WholeBodyX 的 WBC。
脚本枚举最多两个独立活动约束,求解对应线性方程,并检查可行性、乘子非负与驻点条件。这是可逐行阅读的微型 QP 求解方式,组合数量随约束增长,不适合替代生产求解器,也不是 OSQP 的 ADMM 实现。正向、反向和零目标均有预期结果断言,另有一个上下界矛盾的案例确认失败不会产生命令。
最后一个单自由度算例展示 WBC 任务冲突:两个速度目标分别为 0.8 和 −0.4 rad/s,权重为 4 和 1,正则系数为 0.1。无约束最优值约为 0.5490 rad/s;加入 ±0.2 rad/s 的硬边界后,输出为 0.2 rad/s,两个任务都留下残差。这里标量问题可以用截断得到同样答案;一般耦合 QP 不能靠逐关节截断无约束解代替求解。
该算例解释加权任务与边界,不含全身雅可比或接触动力学。可核对实际运行结果,其中 KKT 驻点残差最大约为 ;这个数反映微型问题的数值求解精度,不代表机器人跟踪精度。
8.3 跟着一次求解逐行理解代码
第一步:选定状态、控制和单位
这里位置 q 的单位为 rad,控制 u 是 rad/s,而不是力矩。当前速度 v 仅用于约束首个速度变化;预测位置由积分模型决定。每个节点相隔 0.1 s,两个节点只预测 0.2 s。目标 0.3 rad 是软跟踪目标,没有添加“必须在第二步到达”的终端等式。
展开两个节点就能看懂下三角矩阵的来源:
第一行只受第一个速度影响,第二行同时受两个速度影响。若把 B 写成对角矩阵,就会丢掉第一步对后续位置的累积贡献。
第二步:把代价展开成 H 与 g
本例完整目标是:
代入位置表达式,收集二次项和一次项,得到上一节的 H 和 g。常数项不影响最优速度,可以丢弃; 则要与求解器约定保持一致。代码中这三行对应整个展开过程:
weights = np.diag([10., 30.])
h = prediction.T @ weights @ prediction + .1 * np.eye(2)
g = prediction.T @ weights @ np.full(2, q0 - goal)
若忽略约束,可以解线性方程 。但这个解未必满足关节边界,因此它只是活动集为空时的候选,不能直接作为执行指令。
第三步:逐行解释约束,而不是只看矩阵尺寸
| A 的行块 | 本例表达式 | 物理或离散含义 |
|---|---|---|
| 单位矩阵 I | 速度上限 | |
| 预测矩阵 B | 两个未来位置均在关节范围内 | |
| 差分矩阵 D 的首行 | 第一个控制相对当前速度变化有限 | |
| 差分矩阵 D 的次行 | 预测内部相邻速度变化有限 |
0.2 来自 ,单位仍是 rad/s。将步长减半却保持这项不变,会把允许的速度变化率加倍;这是一类容易被“优化成功”掩盖的建模错误。
第四步:用 KKT 条件确认候选解
脚本将双侧边界改写为 ,其中 、。假设某组约束恰好取等号,记为 ,求解:
随后检查所有约束可行、活动乘子 ,以及驻点残差 足够小。非活动约束乘子取零,活动约束取等号,便满足互补条件。对这里的严格凸问题,这些条件共同证明候选是唯一最优解;只检查“位置没越界”不能证明最优性。
正向目标下,起作用的两个边界是 和 ,相应乘子为 1.66、0.68,均非负。因此最优速度为 0.2、0.4。solve_tiny_qp() 枚举空集、单行和双行组合,跳过奇异系统;如果找不到通过检查的候选,会抛出异常,调用方不能继续使用一个不存在的解。
第五步:从一次规划变成滚动闭环
rollout() 每次调用 mpc(goal, q, v),只执行第一个速度,然后读回积分后的新位置和速度:
plan = mpc(goal, q, v)
command = plan["velocity"][0]
next_q = q + .1 * command
q, v = next_q, command
第一拍后位置为 0.02 rad、速度为 0.2 rad/s。下一拍必须用这份新状态重新构造 g、位置边界和首行速度变化边界,而不是再次从零出发求解。后半段预测可以成为下一次求解的初值;本微型枚举器没有 warm start,WholeBodyX 的求解器则会利用旧计划。
运行后当前目录生成 results-atomic/report.json 和 results-atomic/rollout.csv。默认的 100 步运行结束于 10 s,位置在本次数值运行中达到 0.3 rad,误差为零;验收实际采用 rad 阈值。每一拍还检查速度、位置和速度变化边界。这里的 10 s 是模拟时间,不是程序耗时,更不是计算实时性的证明。可下载本次完整闭环 CSV。
8.4 双关节 WBC:为什么逐关节截断不够
前面的标量任务只有一个自由度,无约束最优值截断到区间后恰好就是约束最优解。现在增加第二个自由度,让两个任务同时使用两个关节:
第一项希望两个关节速度之和为 1 rad/s,权重为 4;第二项希望二者速度之差为零,权重为 1。这是关节线性组合的教学任务,不是由具体人形机器人几何推导的末端雅可比。两个任务共享 u 的两列,因此任何一个关节改变都会同时影响两项残差。
加入 正则后,目标与矩阵为:
令第一关节速度边界为 ±0.2 rad/s,第二关节为 ±0.8 rad/s。三种结果如下;代价列均使用上面的完整目标,包含相同的常数项:
| 求解方式 | 结果 | ||
|---|---|---|---|
| 无约束解 | 0.493827 | 0.493827 | 第一关节越界 |
| 对无约束解逐元素截断 | 0.2 | 0.493827 | 可行,代价约 0.244844 |
| 在边界内重新求 QP | 0.2 | 0.666667 | 可行,最小代价约 0.168667 |
固定第一关节在上界 0.2 后,对第二关节求导:。令其为零,得到 ,仍在第二关节边界内。QP 允许第二关节重新分担第一关节被限幅后留下的任务误差,而逐元素截断把第二关节留在旧值上。
最优解的两项任务残差约为 −0.133333 与 −0.466667,都没有变成零。权重较大的速度和任务获得了更好的满足程度,但这仍是加权折中,不是严格层级控制。对第一个关节,上界乘子为 0.98;对第二个关节,驻点导数为零,与活动约束条件一致。
运行 python atomic_control.py 会自动执行 coupled_wbc(),检查最优速度是否为 [0.2, 2/3],并确认约束 QP 的代价小于截断方案。结果保存在报告的 coupled_wbc 字段,也可以单独查看:
from atomic_control import coupled_wbc

result = coupled_wbc()
print(result["command"])
print(result["clipped_objective"], result["optimal_objective"])
该实验把“任务共享自由度”的含义落到了数值上。换成真实机器人后,J 随构型变化,关节限位也可能产生状态相关的速度边界,但关于耦合优化与逐元素截断的区别仍然成立。
8.5 大权重与严格优先级:用同一组任务对照
上一节展示两个任务如何折中,但没有实现“先保证任务一,再优化任务二”。本节沿用相同关节边界,将速度和目标从 1 改为 0.6 rad/s,让高层任务存在多个可行最优解,观察低层如何使用剩余自由度。
设高优先级任务为 ,低优先级任务为 ,边界仍为 、。两个任务同时精确满足需要 ,这会使第一关节越界,因此控制器必须处理冲突。
先看有限权重的结果
加权版本在同一个目标中计算:
在本例的三个权重下,第一关节均达到上界 0.2,第二关节为 。因此高层残差为:
增大 w 会减小残差,但对这些有限权重,残差仍不为零。优化器愿意牺牲少量速度和跟踪精度,换取更小的速度差与正则代价。
再看真正的两级求解
第一级仅最小化 ,并保留关节硬边界。速度和在边界内能覆盖 [−1, 1],所以目标 0.6 可达,第一级的最优残差为零;例如 [0.2, 0.4] 就能实现。
第二级将已经达到的高层结果保留下来,在 上优化速度差与小正则。写成 后,高层等式自动成立。由两关节边界得到:
即 。第二级变成一个标量 QP:
它的无约束最优点为 t=0.3,约束最优点为 t=0.2,最终命令是 [0.2, 0.4]。低层速度差仍为 −0.2,但它没有改变高层已经达到的零残差。
| 方法 | (rad/s) | 高层残差(rad/s) | 低层残差(rad/s) |
|---|---|---|---|
| 权重 4 | 0.352941 | −0.047059 | −0.152941 |
| 权重 40 | 0.394161 | −0.005839 | −0.194161 |
| 权重 400 | 0.399402 | −0.000598 | −0.199402 |
| 两级任务优化 | 0.400000 | 0 | −0.200000 |
所有行都满足相同硬边界,表格比较的是任务冲突处理方式。严格层级会接受更差的低层残差;是否采用它,应由任务之间是否允许交换误差决定。把 w 不断调大并不能替代层级建模,还可能增大数值尺度差异。
代码如何保证低层不破坏高层
priority_wbc() 中,第一级通过可达区间和可行解证明零残差最优。第二级使用 anchor=[0,0.6] 与 null=[1,-1]^T,令 ;因为 [1,1] @ null = 0,调整 t 不会改变速度和。将低层 Hessian 与梯度变换到 t 上,再调用同一个微型 QP 求解器。
这个实现是特定两任务问题的解析降维,不是可直接接入任意机器人任务的通用层级 QP。第一级没有加入任意正则去预先选定唯一解;正则放在第二级,因而不会提前占用低层可利用的自由度。
运行 python atomic_control.py 后,报告的 priority_wbc 字段包含全部对照。脚本用闭式解检查加权结果,并检查两级结果和高层残差;也可单独调用:
from atomic_control import priority_wbc

result = priority_wbc()
for row in result["weighted"]:
    print(row["weight"], row["high_residual"])
print(result["hierarchical"])
最后要区分“高优先级软任务”与“硬约束”:若高层目标本身不可达,层级优化应先找到它在硬边界内能达到的最优残差,再要求低层不使该结果变差,不能直接把不可达目标强行写成等式。本例能用速度和等式消元,是因为第一级零残差已经得到证明。
8.6 高层目标不可达:保留最优残差,而不是强行等于目标
上一节的高层速度和 0.6 rad/s 可以实现。现在仅把目标改为 1.2 rad/s,保留 、,低层仍希望两个关节速度相同。这时高层任务自身已经无法精确实现。
第一级应求什么
设高层目标为 s,实际速度和为 y。关节边界允许的速度和区间是 [−1, 1],所以第一级等价于:
对 s=1.2,最优值出现在 ,最优残差是 ,代价为 0.02。零残差不可达,但这个带边界的优化问题本身可行;求解器正常返回非零任务残差,并不代表它求解失败。
若反过来把 u1 + u2 = 1.2 当成硬等式,关节上界又要求 u1 + u2 <= 1.0,两者直接矛盾。这里应拒绝产生命令,而不是用软任务的残差解释硬约束违约。
第二级应保留什么
第二级必须保留已经求出的最优高层结果 ,而不是继续要求原始目标 1.2。由于两关节都必须达到上界才能实现速度和 1,唯一可行命令为 [0.2, 0.8]。
使用上一节的降维方式,令 ,边界给出:
即 t 只能为 0.2。低层已经没有可利用的自由度,只能接受速度差 −0.6 rad/s。它无法在不破坏高层结果或关节边界的前提下继续改善。正向与反向的实际结果如下:
| 高层目标(rad/s) | 命令(rad/s) | 高层残差 | 低层残差 |
|---|---|---|---|
| +1.2 | [+0.2, +0.8] | −0.2 | −0.6 |
| −1.2 | [−0.2, −0.8] | +0.2 | +0.6 |
这里的“残差”始终定义为实际任务值减去目标值,两列单位均为 rad/s。正向目标的高层残差为负,是因为实际速度和小于目标;反向目标则相反。
运行与验证
atomic_control.py 的 unreachable_priority() 先根据区间得到最优速度和,再检查保持该速度和的可行区间是否退化为单点。此例无需再次调用优化器选择低层结果,因为已经没有选择空间。脚本同时把原始目标写成硬等式交给微型 QP,检查这组相互矛盾的硬约束确实被拒绝。
from atomic_control import unreachable_priority

for case in unreachable_priority():
    print(case["target"], case["command"], case["high_residual"])
    print("硬等式被拒绝:", case["hard_target_rejected"])
完整运行 python atomic_control.py 时,这些结果自动写入报告的 unreachable_priority 字段。代码分别检查正反向命令、0.2 rad/s 的最优残差绝对值和硬等式拒绝结果。remaining_interval 的两端可能相差浮点舍入量,判定单点时使用 容差,不要求十进制字符串完全相同。
这个例子的区间投影与单点判断依赖于“两个关节的标量速度和、独立盒边界”。一般多维任务需要先实际求解高层,再通过适当的约束保留其最优结果;不能对所有任务目标逐元素截断,就称为层级控制。教学求解器的通用异常仍可能表示数值未解决,本例之所以能明确判定硬等式不可行,是因为速度和上界已经提供了独立证明。
读控制日志时,应分别查看硬约束可行性、求解器状态、高层最优残差与低层残差。持续存在的高层残差提示需要检查目标可达性或上层规划;它不应被自动归因于求解器错误,也不应通过放松原本必须满足的物理边界来掩盖。
9. 可运行 Python 对照:相同 WBC,不同参考
9.1 环境、执行命令与结果
下载 wholebodyx_demo.py。两组都使用同样的六关节模型、初始状态、目标、PostureTask 和 WBC;一组直接跟踪目标,另一组跟踪 MPC 管理器提供的位置与速度参考。这避免把不同任务配置的差异误算成 MPC 收益。
先安装你自己的 WholeBodyX 源码,以下路径是本次参考目录,应按实际位置替换:
python3 -m venv .venv-control
source .venv-control/bin/activate
python -m pip install /home/ubuntu/workspace/chase/WholeBodyX
python -B wholebodyx_demo.py --output results-control
安装后,示例不需要 PyTorch、预训练模型、URDF 或可视化组件;核心依赖是 NumPy、SciPy 和 OSQP。本文实际使用 WholeBodyX 已有环境运行,版本为 NumPy 2.3.5、SciPy 1.17.1、OSQP 1.1.3;新建环境若解析到其他依赖版本,应记录后再比较。
250 个 0.02 s 控制步骤后,两组关节误差二范数分别约为 rad 与 rad,初始均为 0.52915 rad。MPC 组实际规划 50 次、复用参考 200 次。可下载运行报告、直接 WBC CSV 与 MPC→WBC CSV。
脚本逐步检查积分关系和执行速度的组合边界,违约容差为 ;运行中的最大速度边界违约分别约为 和 rad/s。这是数值容差内的运动学验证,不是两种方案速度、鲁棒性或真机安全性的排行榜。简单可达的姿态目标本来就不要求 MPC 才能完成。
如果使用仓库现有 h1_mpc_wbc.py,还需要相应 URDF 与可选依赖。其固定骨盆原地踏步、运动学支撑脚对齐和虚拟物体附着,不等于浮动基动力学、刚性抓取接触或物理碰撞仿真。
9.2 一条参考怎样经过 WBC 变成运动
沿 wholebodyx_demo.py 的循环看四个步骤:
plant.read()读取当前 q、v 和时间戳。此处是仿真状态读取,真机应来自状态估计与关节测量。manager.update(state, goal, dt)返回当前参考位置与速度;失败立即报错。直接 WBC 组则使用固定目标位置和零速度前馈。PostureTask(...).linearize(model, state)生成速度任务,controller.step(...)在边界内协调并求解命令。plant.write(...)执行积分,随后重新读取状态,检查实际执行结果,并进入下一拍。
对姿态任务,雅可比就是单位矩阵,目标速度为:
第一项纠正位置误差,第二项提供参考轨迹本身的运动速度。当 MPC 刚从当前状态启动时,,位置反馈为零,但速度前馈仍可让机器人开始移动。若遗漏前馈,初始这一拍就没有该项驱动力,后续主要依赖位置误差追赶。对末端任务,雅可比不再是 I,多个末端可能争用同一关节自由度。
这与动力学 WBC 的加速度任务相对应,但不能混用单位。动力学版本通常构造 ,再用 跟踪;速度级版本直接用 跟踪速度目标。
本例的三个时间量应分开理解:
| 参数 | 数值 | 决定什么 |
|---|---|---|
| MPC 预测节点间隔 | 0.1 s | N=15 时覆盖 1.5 s 未来 |
| 参考管理器默认重规划周期 | 0.1 s | 周期刷新计划的触发条件之一 |
| WBC/积分步长 | 0.02 s | 每拍消费参考与执行的模拟间隔 |
计划内部位置做分段线性插值,速度在每个预测区间内保持常值,因此 WBC 可以在较密的时刻取参考。预测间隔与重规划周期在这里恰好相等,两者不是同一个参数,也不要求永远相等。
9.3 参数实验与排错
先保留默认输出,再一次只改一个条件。atomic_control.py 中的断言针对默认配置;改变模型参数后,应同步重新推导预期结果,保留硬约束检查。
| 实验 | 修改位置 | 应观察什么 |
|---|---|---|
| 反向目标 | 调用 mpc(-0.3) | 初始速度应为 −0.2、−0.4,检查符号与边界对称性 |
| 位置已经到达目标 | 调用 mpc(0.3, q0=0.3, v0=0.) | 最优速度为零;常数位置不需要额外控制代价 |
| 初始速度非零 | 调用 mpc(0.3, q0=0., v0=0.1) | 首步速度变化相对 0.1 而非零约束 |
| WBC 交换两项权重 | wbc() 中改成 [1., 4.] | 输出由正方向转为负方向,任务权重影响折中 |
| 减小速度变化边界 | MPC 的末两行上下界同步缩小 | 初始运动变缓;不能只修改一侧边界 |
可以在下载脚本的同一目录运行一个额外调用:
from atomic_control import mpc

result = mpc(0.3, q0=0.0, v0=0.1)
print(result["velocity"])  # 约 [0.3, 0.5]
print(result["kkt"])
QP 输入与错误类型
修改 QP 数据时,先确认下面的输入约定。solve_tiny_qp() 接受实数列表或 NumPy 数组,并统一转换为浮点数组:
| 输入 | 要求 |
|---|---|
| g | 一维向量,长度 n 为 1 或 2 |
| H | n×n,对称且正定;对称误差绝对容差为 |
| A | m×n,至少一行约束 |
| lower / upper | 两个一维向量,各有 m 个元素 |
| 全部数据 | 有限实数,不接受 NaN、Inf 或复数 |
例如列向量 g.shape == (2, 1) 不能当作 (2,) 使用。形状不匹配会先抛出 InvalidQPInput,不会等到矩阵广播或线性求解时才报错。近似对称且在容差内的 H 会先取对称部分;这里要求 H 正定,是微型求解器的教学范围,并不意味着所有凸 QP 都必须严格正定。
QPSolveError 则表示没有得到有效命令。若明确发现 lower > upper,边界本身已经矛盾;若所有候选都未通过检查,原因可能是约束不可行,也可能是数值未解决。后者不能仅凭异常类型断言“物理任务不可能完成”。这两个异常都继承 ValueError,原有示例的失败处理仍然适用。
求解器现在先检查线性方程解和残差数组是否有限,再计算最大违约量。NaN 不能参与普通大小比较后被当成零残差,Inf 也不能成为关节命令。下载包包含专门的回归测试:
python -m unittest -v test_atomic_control.py默认应通过九项测试,覆盖合法列表输入、形状错误、非有限/复数输入、非正定或不对称 H、约束矛盾,以及模拟线性求解返回 NaN/Inf 的情况。其中非有限解测试检查的是故障返回路径,不是在模拟真实机器人。新增测试还覆盖 MPC 标量输入、初始状态、不可达软目标,以及错误类型的传播。之后再运行 python atomic_control.py 与 python feedback_demo.py,检查正常实验结果是否仍然符合预期。
MPC 入口:当前状态与软目标分开检查
mpc(goal, q0, v0) 是单关节示例,三个参数均应为有限的实数标量。goal=[0.3, 0.4] 不会被解释为两步参考轨迹,布尔值和字符串也不作为目标接受。若要预测时变参考,应显式扩展目标序列接口与梯度构造,不能依赖数组广播碰巧生成一个可求解的问题。
该教学入口要求初始位置在 [−0.5, 0.5] rad、初始速度在 [−1, 1] rad/s。规划约束只描述未来节点,不能用未来回到范围内的计划来隐含证明当前状态已经满足边界。超范围初态会先抛出 InvalidQPInput;如果要研究从越界状态恢复,需要另行定义初态与恢复约束。
软目标不受相同的输入范围限制。例如 mpc(2.0) 可以正常求解:第一条计划仍给出约 [0.2, 0.4] rad/s,未来位置遵守关节边界,代价函数接受较大的跟踪误差。这里没有把目标 2.0 强行等同于某个未来状态。
可以用三次调用区分不同层次:
mpc(2.0):输入合法,软目标超出可达位置范围,允许返回有跟踪误差的计划。mpc(0.3, q0=0.51):违反本例的初态接口,属于InvalidQPInput。mpc(0.5, q0=0.46, v0=0.6):逐项初态边界满足,但制动余量不足,属于本例已推导的QPSolveError。
短时域反例现在只捕获 QPSolveError。如果传入错误形状或其他无效状态,InvalidQPInput 会继续向外报告,避免测试把“输入构造错了”计为预期的无解结果。两类错误虽然都兼容 ValueError,调用方需要分类诊断时,应优先捕获更具体的类型。
若 import wholebodyx 失败,先确认运行脚本的解释器与安装源码使用的是同一个环境;NumPy 原子实验不需要该依赖。若求解失败,先检查初始状态、边界交集和步长,再检查目标与任务配置。软目标太远并不必然不可行:优化器可以留下跟踪误差;互相矛盾的硬边界才会直接排除所有可行解。
若命令持续贴住边界而任务误差不降,应查看哪些边界激活、目标是否可达、坐标系是否一致。若模型中没有力矩、摩擦或碰撞约束,即使所有 CSV 检查通过,也不能推导出这些物理量满足要求。扩展到浮动基人形机器人时,需要更换预测/执行模型,并补上接触、动力学和状态估计,而不是只把六关节数组改成更长的数组。
9.4 扰动实验:执行旧指令与重新规划有何不同
先下载 feedback_demo.py,与 atomic_control.py 放在同一目录,在已有 NumPy 环境执行:
python feedback_demo.py --output results-feedback实验先生成无扰动的名义闭环速度序列,再让两组从相同初值出发。到模拟时间 3 s 时,将位置状态减去 0.08 rad,随后立即向反馈组提供改变后的状态。回放组继续执行记录的名义速度;反馈组每拍重新求解 MPC。两组的积分模型、目标、边界、步长和注入偏移均相同。
这次偏移是人为的位置状态跳变,速度状态保持不变;它用于检查反馈的数据流,不是刚体受推冲量,也不表示模型已经模拟了接触或传感器噪声。回放组使用的是完整名义运行中记录的命令,不能误读成最初一个两步预测窗口覆盖了整段 10 s。
| 时刻或指标 | 回放名义命令 | 根据新状态重规划 |
|---|---|---|
| 3 s 偏移后的测量位置 | 约 0.22 rad | 约 0.22 rad |
| 偏移后第一拍命令 | 约 0 rad/s | 约 0.2 rad/s |
| 执行到 3.1 s 的位置 | 约 0.22 rad | 约 0.24 rad |
| 10 s 时绝对位置误差 | 约 0.08 rad | 本次运行中为 0 |
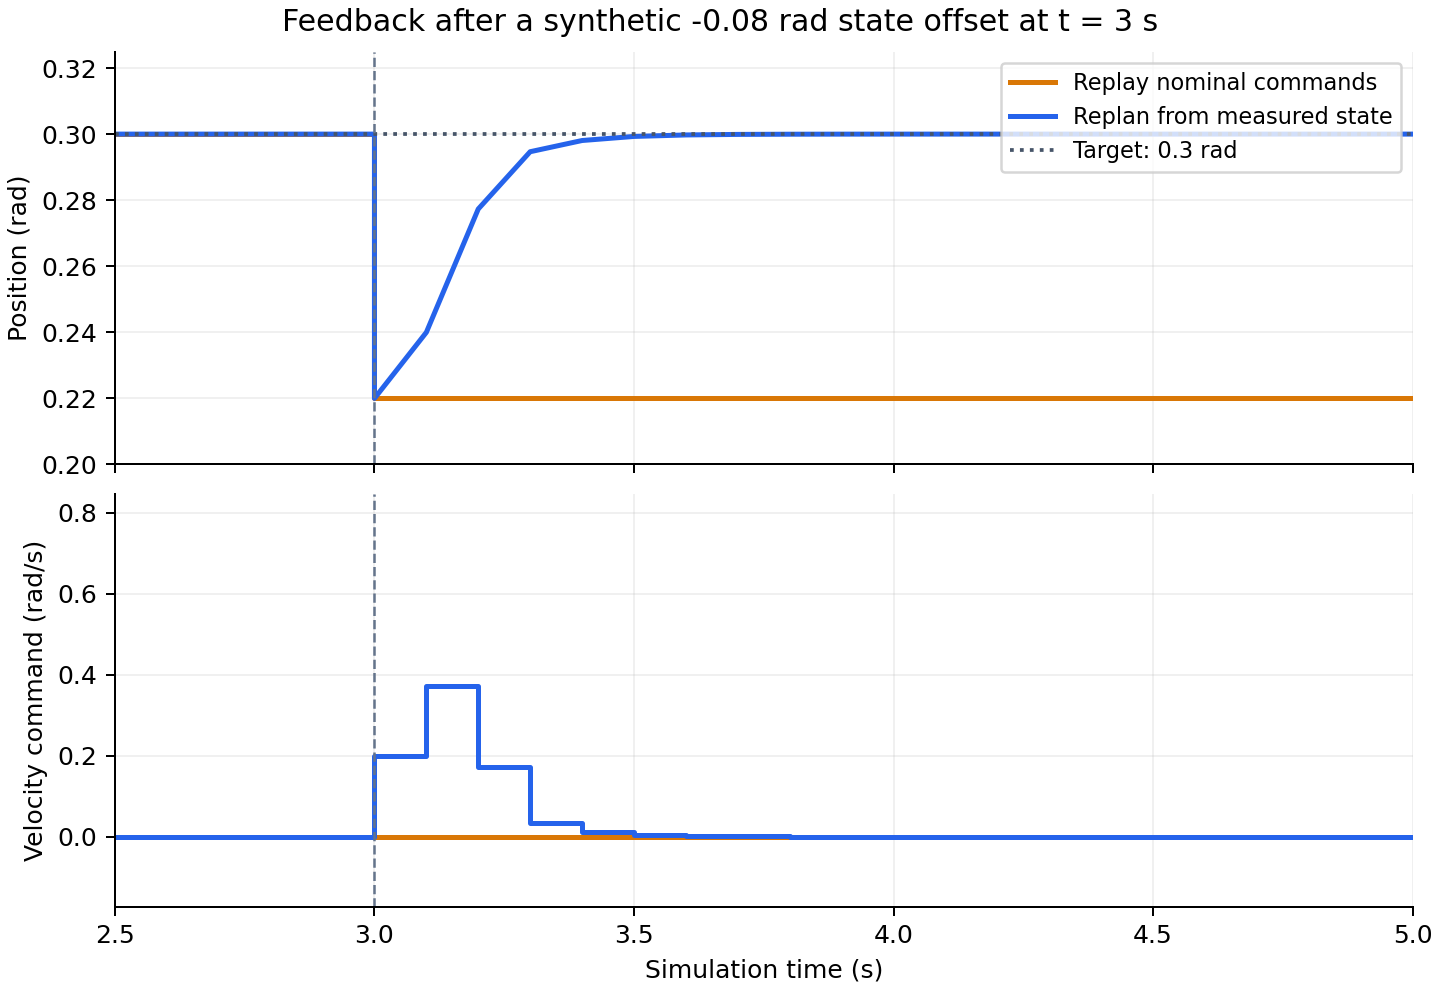
为什么反馈组第一拍只恢复 0.02 rad?偏移之前速度约为零,速度变化率边界允许新命令最多增加 0.2 rad/s;再乘以 0.1 s,只能前进 0.02 rad。偏差进入新初值后,MPC 改变后续序列,但仍要遵守硬边界。
两组都逐拍检查位置、速度和速度变化约束;脚本也检查最终误差是否符合预期。这个对照说明重新使用测量值能修正该积分模型中的偏移,不能据此认定 MPC 比其他反馈控制器更强。位置反馈、LQR 或其他控制器也可能纠正这种简单误差,本文没有进行这些比较。
下载运行报告、回放组 CSV、反馈组 CSV。报告中的 first_after_offset 是第 31 拍,time=3.1 表示执行结束时刻;该行 measured_position 对应 3 s 时注入后、执行前的测量。需要自己重画图时,将 plot_feedback.py 放在同一目录:
python -m pip install matplotlib==3.10.6
python plot_feedback.py --input results-feedback --output results-feedback/feedback-comparison.png
绘图依赖是可选项,控制实验本身仍只需要 NumPy。
9.5 当前窗口有解,下一拍为什么仍可能无解
feedback_demo.py 还运行一个容易被忽视的边界案例:初始位置 0.4 rad、初始速度 0.8 rad/s,目标 0.5 rad。两步 MPC 给出速度 0.6、0.4 rad/s,位置依次为 0.46、0.50 rad,预测窗口内每个节点都满足约束。
执行第一步后,以位置 0.46、速度 0.6 重新规划。此时最快也只能每拍减速 0.2 rad/s,因此未来两个速度至少为 0.4、0.2 rad/s,对应位置至少为 0.50、0.52 rad。第二个位置越过 0.5 rad 上限,新问题已经无解。
这个例子中的初始状态虽然位于位置和速度的逐项边界内,却已来不及在上界之前停下。原来的短窗口只看到了到达边界,没有看到到达时仍有正速度。加入终端位置代价、提高其权重,都不能自动证明“之后总能继续满足约束”。
对当前离散积分与速度变化模型,向正方向最快制动时,未来指令依次为 ,。从 0.8 rad/s 开始,指令为 0.6、0.4、0.2、0,对应最短前进距离 rad;剩余位置空间只有 0.10 rad,二者已经矛盾。这里依据的是离散指令模型,不能直接当成真实执行器的连续制动距离。
工程中需要考虑初始状态是否允许后续持续可行、终端集合、可持续执行的局部控制策略,以及模型误差和扰动余量。延长时域能让这个案例更早暴露矛盾,但不会让一个已经无法及时制动的状态重新变得可行。相关有限时域建模背景见 MIT 轨迹优化课程。
教学求解器的异常文本同时涵盖“不可行或数值未解决”;本例能判定不可行,是因为上述边界推导已经排除了全部解,而不是因为任意异常都能被当作不可行证明。下载报告中的 horizon_trap 字段记录第一条有效计划与下一次拒绝结果。
9.6 参考失效实验:过期、刷新失败与时间回退
在安装 WholeBodyX 源码的环境中运行 reference_failures.py:
python -B reference_failures.py这个脚本只调用参考管理器,不执行机器人或积分器。为了把失败行为和真实求解器性能分开,它用一个适配器在指定的一次调用中返回错误;其余调用仍交给实际 JointMPC。测试按以下顺序推进:
| 序号 | 操作 | 应看到的结果 |
|---|---|---|
| 1 | 时间戳 0,正常求解 | success=true,存在计划 |
| 2 | 在 valid_until 恰好取样 | 抛出异常,终点不属于可取样区间 |
| 3 | 时间戳 0.02,改变目标并注入错误 | success=false,参考位置/速度均为空,旧计划清除 |
| 4 | 时间戳 0.04,恢复正常求解 | 新计划生成 |
| 5 | 从 0.04 回退到 0.03 | clock_rollback,计划清除 |
| 6 | 时间戳增加到 0.06 | 仍拒绝输出 |
| 7 | manager.reset() 后重新更新 | 可重新生成初始计划 |
刷新失败时,旧计划在时间上仍覆盖当前控制间隔;脚本刻意使用这种情况,确认“尚未过期”不意味着管理器会自动回退执行旧目标。reason 表示为什么触发更新,例如 goal_changed;它不是求解器成功与否的替代字段,应同时检查 success 和求解器状态。
时间回退会使当前时间轴失效,在此实现中需要显式重置。测试里的重置只是验证 API 状态迁移;真机遇到时钟问题时,还需要重新建立一致的状态、目标与执行时间轴。返回空参考同样不意味着硬件自动停止,运行层必须定义适合执行接口的处理方式,不能无条件把速度或力矩设为零就宣称安全。
可对照实际运行报告。这组验证覆盖参考生命周期和错误传播;不覆盖真实求解超时、通信断线、落脚冲击或动态平衡。
10. 与策略学习怎样组合
PPO、DPO、GRPO 是训练目标或训练方法,MPC/WBC 是在线规划控制模块,两者不是互斥选项。策略可以输出速度命令、目标姿态、任务参考或有界残差,再由控制器处理当前模型中的约束;也可以用优化控制器产生示范,训练策略近似其行为。
若策略动作先经过 WBC/QP 修正,训练时应保存原始采样动作及其概率,同时单独记录实际执行命令;不能拿修正后的命令去匹配原动作分布的 old logp。把控制器作为环境的一部分时,回报应来自整个组合闭环。训练与部署的控制器、限幅和观测协议发生变化,就可能引入分布偏移。更详细的训练衔接见 PPO、DPO 与 GRPO 的控制章节。
具体 WholeBodyX 能力以所核对源码为准。进一步研究全身最优控制与反馈增益,可阅读 Crocoddyl 官方项目。
实验完成后,按结果复盘
下面的路径均相对解压后的 control-lab 目录。先确认命令正常退出,再检查报告字段;输出目录已经存在,不代表本次运行一定成功,也不代表里面的文件已经被更新。
- MPC 原子问题与滚动运行:打开
results-atomic/report.json。mpc中速度应为 ±[0.2, 0.4] 或零;rollout最终误差应通过阈值检查。 - 耦合任务如何分配速度:查看同一报告的
coupled_wbc。QP 代价应小于逐关节截断方案,约束均满足。 - 加权与严格层级有何区别:查看
priority_wbc。有限权重仍留下高层残差,两级求解保留最优高层结果。 - 高层目标不可达怎么办:查看
unreachable_priority。软任务最优残差绝对值为 0.2,相同目标作为硬等式被拒绝。 - 反馈是否使用了新状态:打开
results-feedback/report.json。回放组最终误差约 0.08,反馈组恢复目标。 - 短窗口是否保证后续可行:查看反馈报告的
horizon_trap。第一条计划可行,下一拍因制动余量不足被拒绝。
读懂一行 CSV:时间、状态与命令怎样对齐
最终误差只描述终点,不能证明中途满足约束。对本文的默认 NumPy 实验,CSV 中第 k 行记录一次执行后的结果:time 是该拍结束时刻,velocity 是这一拍采用的命令,position 是执行后位置。第一拍从位置零开始,以 0.2 rad/s 执行 0.1 s,因此记录的位置为 0.02 rad,误差为 rad。
检查相邻行时,使用以下关系;没有偏移的普通运行取 :
这里 k 是 CSV 的执行行索引,从 1 开始,与 MPC 窗口内从 0 开始的预测索引不同。feedback.csv 和 replay.csv 的 offset 就是 ,measured_position 应等于 。偏移发生在 3 s,而含偏移的那一行结束于 3.1 s,两者描述的是同一拍的开始与结束。
还应检查每行位置绝对值不超过 0.5 rad、命令绝对值不超过 1 rad/s、相邻命令差绝对值不超过 0.2 rad/s;第一拍命令差相对初始速度零计算。absolute_error 应等于实际位置到 0.3 rad 目标的距离,不能用预测窗口末端的位置代替它。最后再把 CSV 末行与报告的 final 字段对照。
如果仅检查 JSON 中最终误差,删掉中间行、写错时间戳或把预测状态误写成执行状态,都可能未被发现。完整轨迹核对能帮助定位记录与模型的不一致,但它验证的是当前积分实验;一份内部自洽的日志仍不等于真实机器人模型准确。
默认实验的误差阈值、步长和参数已写入对应章节与脚本。不要把某个浮点输出恰好为零当成通用精度保证;改变模型或参数后,要重新核对预期结果。若 JSON 中缺少本文所述字段,先确认下载包是否为当前版本,以及运行的是哪个目录下的脚本。
三个迁移问题:先手算,再展开核对
高层速度和改成 0.9 rad/s,严格层级能否精确满足?
能。速度和仍在可达区间 [−1, 1] 内,高层最优残差为零。保留 后,低层希望速度相同,对应无约束解 [0.45, 0.45],第一关节越界;最终取 [0.2, 0.7],高层残差为零,低层速度差为 −0.5 rad/s。这里沿用第 8.5 节的硬边界和第二级正则。
与目标 1.2 的区别在于:0.9 本身可达,低层只是无法实现速度相等;1.2 则连高层零残差都无法达到。
步长从 0.1 s 改成 0.02 s,速度变化边界还能保持 0.2 rad/s 吗?
若保持速度变化率上限为 2 rad/s²,新的每拍速度变化边界应为 rad/s。继续使用 0.2 rad/s,相当于允许 10 rad/s²,已经改变了模型。
还要同步检查预测矩阵、积分执行与时域长度。N=2 不变时,预测未来从 0.2 s 缩短为 0.04 s;要维持 0.2 s 的时域,需要 N=10。但本文的枚举求解器只支持最多两个决策变量,不能仅修改 N 就继续使用它,需要换成能处理更大问题的求解器。
扰动对照恢复了位置,能否证明 WBC 或动态平衡有效?
不能。该对照直接将 MPC 第一个速度送入单关节积分器,没有经过 WBC,也没有接触力或浮动基动力学。它验证的是这个模型下“重新使用测量状态”与“回放名义命令”的区别。
要评价 WBC,应查看六关节同任务对照及其约束;要评价动态平衡,则需具备对应动力学、接触、估计与执行模型的实验。不同实验回答不同问题,不能将一个层面的通过结果替代另一个层面的证据。
阅读自测与验收
- 给每一条模块接口写清传递的是状态、轨迹、接触计划还是关节命令,并注明时间戳和坐标系。
- 模拟估计延迟、优化超时或接触变化,确认下层如何处理过期参考;模块频率高不等于闭环一定稳定。
展开核对:控制接口与验证边界
- MPC 参考应说明状态/控制含义、时间戳、有效期和坐标系;WBC 输出还需匹配低层伺服接口。
- 过期参考、求解失败和接触变化必须有运行层处理;平均求解速度无法代替时延与失败恢复检查。
- WholeBodyX 本文示例只验证固定基座积分关系和关节速度边界;动态平衡、接触摩擦和力矩可行性不在该模型中。