RynnBrain 深度解析:从时空 Grounding、Chain-of-Point 到 1.1 跨本体 VLA
本文目录 展开章节导航
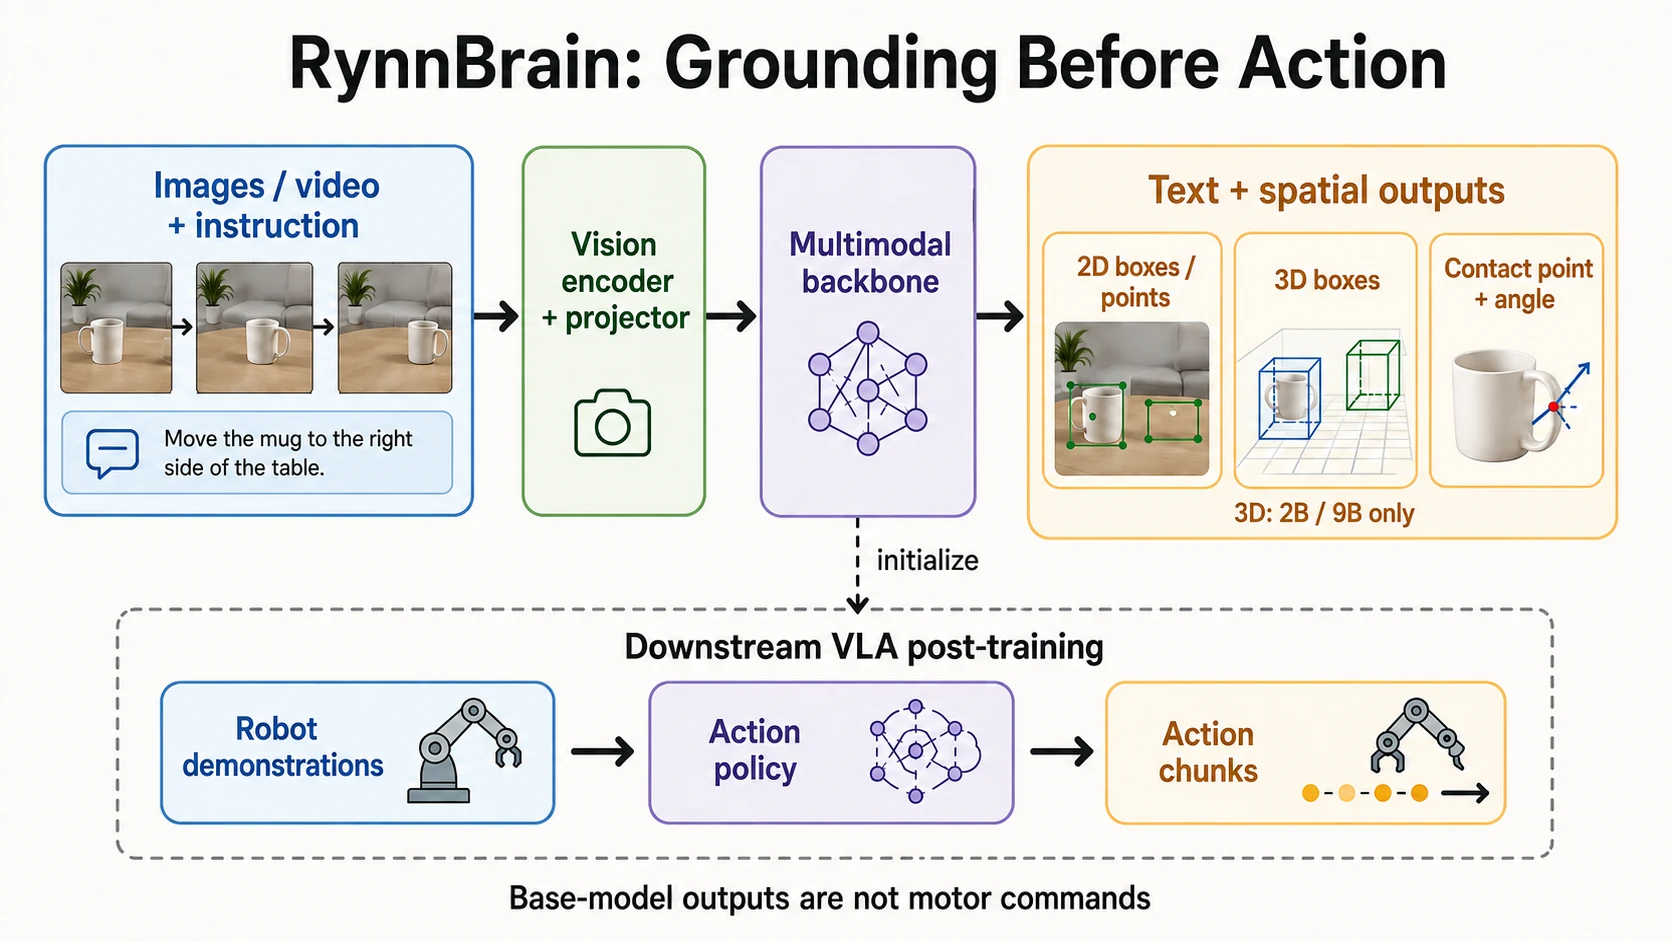
“拿起杯子”包含一串需要分别解决的问题:是哪一个杯子、出现在哪一帧、接触哪里、当前还能否看见,以及机器人怎样执行。RynnBrain 的研究主线,是把视觉与语言理解推进到时空定位,再通过 VLA 后训练连接动作策略。 理解这条链,才能判断模型输出能直接用在哪里,还缺哪些系统组件。
本文以 RynnBrain 1.1 为主线,结合 1.0 解释 CoP 的来源。1.0 代码位于历史分支,1.1 的模型、空间任务与 VLA 实验分别核对;具体 commit、权重 revision 和论文版本列在文末。官方版本入口
文中有三类内容:官方材料直接支持的事实、基于接口与数学的个人分析、本文提供的离线教学实验。没有在本地复现大模型训练、权重推理或真实机器人成功率;文中的实验指标均标明出处。
1. 阅读路线与核心结论
| 阅读目标 | 建议路线 | 读完应能回答 |
|---|---|---|
| 理解模型 | 第 2~6 节:版本、架构、空间任务与训练 | 模型接受什么监督,生成什么表示? |
| 接入机器人 | 第 7~9 节:接触点、三维坐标、动作策略 | 哪些输出仍需标定、适配与控制? |
| 动手验证 | 第 10~12 节:评测、示例与源码核对 | 什么算接口跑通,什么才算能力复现? |
第一次阅读,先完成“接触点算例 → 三维框投影 → CPU 输入检查”这条短路线,再回看训练细节。
先记住四个区别:
- 具身 VLM 不等于动作策略。 输出位置和计划,与输出可执行动作块,是不同接口。
- 图像坐标不等于机器人坐标。 归一化点、像素点、相机三维点、基座三维点之间需要不同的转换。
- 视觉历史不等于永久记忆。 输入了哪些帧、如何采样、上下文是否截断,决定模型实际能利用什么信息。
- 基础模型能力提升不等于任意平台零样本成功。 动作表示、示教分布、执行控制器和任务评价都需要单独核对。
2. 版本、模型与开源内容:先确定你在研究哪一个 RynnBrain
2.1 1.0 与 1.1 的对应关系
| 维度 | RynnBrain 1.0 | RynnBrain 1.1 |
|---|---|---|
| 基础模型家族 | Qwen3-VL | Qwen3.5 |
| 首篇报告的主要规模 | 2B、8B、30B-A3B | 2B、9B、122B-A10B |
| 空间输出主线 | 物体、区域、可供性、轨迹 | 保留基础任务,增加接触点与三维定位 |
| 下游研究方向 | CoP、Nav、Plan、VLA | 强调跨本体动作建模及真实机器人迁移 |
| 阅读入口 | rynnbrain1.0 分支 | 当前主分支与 RynnScale |
这些是版本定位,不是完整权重清单;例如 1.0 后续还发布了 4B。完整发布状态应分别查1.0 分支、1.1 HF 集合与当前 Model Zoo,不能用首篇论文的表格代替当前模型仓库。
122B-A10B 中的两个数字分别描述总规模与激活规模。即使每个 token 只路由到一部分专家,大多数部署方式仍需存放完整专家权重,因此不能按“10B 模型”计算全部显存。
2.2 原生 3D 能力的范围要单独注明
1.1 报告将原生 3D Grounding 的明确训练与评估范围限定在 2B 和 9B;接触点预测则是该系列新增能力。不能因为 122B 更大,就自行给它补上相同的三维监督与评估结论。来源:1.1 报告
这是一个很有启发性的例子:模型规模、数据覆盖和任务接口是三个独立维度。选模型时应先问“有没有针对这个任务训练和验证”,再看参数量。
2.3 开源仓库并不只有一个入口
| 入口 | 适合检查什么 | 不应据此假定什么 |
|---|---|---|
| RynnBrain 主仓库 | 推理入口、Cookbook、模型链接 | 每一种机器人策略都已附完整权重与驱动 |
| Hugging Face 模型仓库 | 权重、配置、Processor、许可证标注 | 论文全部训练数据都包含在模型仓库 |
| RynnScale | VLM 训练、数据处理、评测框架 | README 的占位路径能够直接执行 |
1.0 的 reasoning/navigation/planning | 历史任务配方 | 换成 1.1 权重后所有脚本无需适配 |
| RynnBrain-Bench | 数据格式、任务分类与评估输入 | 数据下载分片名称就是训练/验证隔离策略 |
核对的 RynnScale 项目 README 中,RynnBrain-VLA 小节仍是 TBD...。因此本文不会给出一个虚构的“训练全部 1.1 VLA 并部署所有机器人”的一键命令。固定版本源码
3. 架构:为什么它首先仍是一个多模态基础模型
3.1 一条输入链,多个输出任务
从接口上,可将基础模型抽象为:
其中 是输入图像或采样帧, 是任务指令, 可以混合语言与空间表示。
视觉编码器把像素转为特征;视觉—语言投影模块对齐特征维度;语言骨干在任务指令条件下生成目标序列。模型并不是每遇到一种任务就必须增加一个独立的传统检测头。架构入口:官方 README
用工程语言理解,这种设计把“输出什么”更多地交给了数据和任务格式。但它也带来一个代价:语法合法性、数值范围和物理可行性不会因为输出经过 softmax 就自动成立。
例如,模型可能生成一个看起来合理、实际越界的点;也可能输出合法坐标,却指向错误对象。两种错误需要不同的检查。
3.2 不能把 1.1 的每一层都画成普通全注意力
核对 RynnBrain1.1-2B 的配置,可见:
| 配置项 | 2B 检查点的值 | 阅读含义 |
|---|---|---|
model_type | qwen3_5 | 必须使用支持这一架构的加载实现 |
num_hidden_layers | 24 | 这是该检查点的文本骨干配置 |
hidden_size | 2048 | 不是所有 RynnBrain 的统一维度 |
layer_types | 每组三层 linear_attention,一层 full_attention | 不能套用全层普通 Attention 的缓存模型 |
spatial_merge_size | 2 | 视觉侧有空间合并配置 |
deepstack_visual_indexes | 空列表 | 不应仅凭论文的家族描述宣称这个文件启用了指定 DeepStack 注入层 |
这里的重点不是记参数,而是学会交叉验证:论文解释设计思路,配置描述具体检查点,运行实现决定实际行为。 三者有出入时,要记录差异,而不是选择最容易讲故事的一份。
3.3 “记住刚才看到的杯子”具体需要什么
考虑一个自拟例子:第一帧看见杯子在柜子上,随后相机转向桌面,最后用户问“刚才的杯子在哪里”。
系统至少要保留:
- 帧的先后关系及其对应时间;
- 同一对象跨视角的身份线索;
- 回答中坐标究竟属于哪一帧;
- 当前视图是否仍包含可以执行的目标。
因此,历史帧中的正确定位只能回答“过去在哪里”。如果要现在抓取,还需要重新观测或把历史观测纳入可信的状态估计。这是由输入输出接口推导出的工程要求,不是模型已经实现 SLAM 或永久记忆的证据。
4. 空间输出:比“说对物体名字”多了哪些约束
4.1 五类任务不能合并为一个“检测”
官方训练格式为不同任务使用带标签的空间序列,且视频输出可能带帧索引。数据格式来源
| 任务 | 自拟问题 | 需要验证的输出 |
|---|---|---|
| Object grounding | 哪一个是蓝色杯子? | 目标身份与二维框 |
| Area localization | 桌上哪里可以放杯子? | 满足条件的区域,而不只是任意空白像素 |
| Affordance localization | 应该从哪里拿起杯子? | 与操作意图相关的点 |
| Trajectory localization | 手刚才怎样移动? | 对应时序与图像参考系的路径点 |
| Contact prediction | 接触哪里、平面内朝向如何? | 接触点及角度协议 |
“检测杯子”与“找到杯柄”不是同一个标注问题。前者可由整物体框表达;后者与部件、物体姿态和指令有关。训练数据如果只覆盖前者,不能期待模型自动获得可靠的操作接口。
4.2 为什么用 [0,1000],又为什么不能乱乘图像宽度
归一化坐标降低了输出与图像分辨率的直接耦合。下面采用官方接触点 Cookbook 的像素中心索引约定:
这样 对应最后一个像素中心 ,而不是数组越界的 。接触点可视化源码
不要把这个约定无条件套用到所有检测器。某些框协议描述的是连续图像边界,使用 也有合理含义。点和框、像素中心和图像边界,必须在接口契约里写清。
还有一个容易遗漏的顺序:先确定模型看到的是原图、缩放图还是裁剪图,再恢复坐标。若先裁剪了左上角偏移 的区域,恢复到原图时还要加回偏移;若做了填充,则先去除 padding。
4.3 量化误差与模型误差不是一回事
在上述约定下,归一化坐标每增加 1,水平位置变化为 像素。这是表示分辨率,不是模型定位精度。
以宽度 1920 为例,一格约为 1.919 像素。即使模型始终输出整数,真正误差也可能远大于这一格:目标识别错、遮挡、透视、裁剪恢复错,都不是多保留一位小数能解决的。
5. 1.0 的 Chain-of-Point:把语言推理与空间证据连接起来
1.0 的 CoP(Chain-of-Point)把语言判断与空间定位交织组织;配套历史代码提供 SFT 与 RL 流程,RL 示例使用 GRPO。这里不能把 InternVL 3.5 的 GSPO 配方挪过来当成 RynnBrain-CoP 的实现。CoP 代码与训练流程(固定提交)
5.1 官方任务类型给出的空间输出格式
固定提交的 reasoning README 列出六类任务及其输出格式。坐标同样归一化到 0–1000,并且视频类回答可以带帧索引 <frame i>,把空间证据固定到具体时间上:
trajectory → <trajectory><frame i> (X_1, Y_1), ..., (X_N, Y_N)</trajectory>
affordance → <affordance><frame i> (X, Y)</affordance>
area       → <area><frame i> (X_1, Y_1), ...</area>
counting   → <counting>N</counting>
segment    → <object><frame i> (X_min, Y_min), (X_max, Y_max)</object>
general    → 自由文本
这与第 4.1 节的 1.1 任务并不完全重合:例如 1.1 新增的接触点预测,在这个 1.0 分支中还没有对应标签。两版的空间格式不能互相替代。
5.2 数据管线:SFT 在前,RL 在后
下面是 1.0 数据管线的接口事实,不是对论文结果的复述:
- 对话中允许出现独立的
Thinking角色;preprocess_cot.py的--keep_images决定思考过程是否保留图像,--simple则生成不含 Thinking 角色的简化格式。 - 训练顺序是 SFT 在前:
preprocess_cot.py→format_data.py统一为 ChatML 风格 → 交给 RynnScale 的 SFT 入口。 - RL 在后:
preprocess_rl.py输出 parquet → verl 的main_ppo。 - README 的 RL 示例使用
algorithm.adv_estimator=grpo,每个提示采样n=5个回答,max_response_length=2048,并带 KL 损失项(系数 0.02)。
5.3 概念例子:证据要落点,落点要可查
下面是为理解接口写的概念例子,不是模型实测输出,也不是必须逐字使用的官方模板:
任务:找到上一次被放回抽屉的工具。
证据一:定位历史帧中的工具。
证据二:定位放置动作结束时的抽屉区域。
检查:工具身份与帧顺序是否一致。
回答:给出对应帧及空间位置;若当前不可见,要求重新观测。
它的价值在于给推理建立可检查的中间落点。但“写出了坐标”不保证证据真实。一个错误点如果被后续步骤当成事实,可能产生比纯语言回答更难察觉的连锁错误。
5.4 三组消融:检查历史、时序与空间证据
我会用三组消融来判断这种设计是否真正起作用:
- 保留问题与当前帧,移除历史帧,看历史任务是否退化。
- 保留所有帧但打乱顺序,检查时间敏感问题是否受到影响。
- 保留语言判断但替换定位结果,检查后续回答是否真正依赖空间证据。
这三组是本文建议的实验,不是官方已经报告的新增结果。它们分别检查“有没有用历史”“有没有用时序”“有没有用空间证据”。
6. 训练:任务格式与数据组织可能比模块名更重要
6.1 学习目标并不神秘
基础模型的语言与离散空间输出都可以纳入自回归目标。对第 个样本,定义需要监督的位置集合 ,一个便于理解的样本归一化表达是:
这里的集合不能简单设为全部输入 token:视觉占位符、问题前缀与答案监督位置要区分。1.0 报告讨论了 per-sample loss reduction 与按序列长度平衡工作负载。1.0 训练基础设施
个人理解是:一个十几个 token 的坐标答案,与一个几百 token 的说明答案,若按 token 总量混在一起归一化,实际训练权重可能与“样本采样比例”完全不同。讨论配方时,只写“某任务占 20%”是不够的,还要问损失如何归约。
6.2 具身数据应该教会哪些区别
与其背一长串数据集名字,不如检查训练集能否区分以下情况:
| 数据能力 | 正例应体现什么 | 特别需要的难例 |
|---|---|---|
| 对象理解 | 类别、属性、计数 | 外观相似的多个实例 |
| 空间理解 | 左右、前后、支撑与相对位置 | 相机改变后关系的参考系变化 |
| 时空定位 | 哪一帧、哪个点、哪条路径 | 短暂出现、遮挡、重新出现 |
| 交互部位 | 杯柄、把手、可操作区域 | 倒置物体与指令改变 |
| 三维定位 | 位置、尺寸、朝向与内参 | 同类物体不同真实尺寸 |
| 规划 | 子任务、目标与状态变化 | 前置条件不成立与执行失败 |
这是面向数据审查的个人分类,不代表官方每一项都提供了完整公开训练集。尤其不能把自动生成的标注数量当成独立真实场景数量:同一段视频产生多个问题,会扩大样本数,却不一定增加环境多样性。
6.3 从公开脚本核对训练配置
核对的 1.1-2B 训练脚本设置了:
model_max_length=16384,mm_max_length=10240;fps=2,max_frames=512;- 主学习率
5e-6,视觉部分学习率1e-6; - BF16、梯度检查点、序列负载均衡和 sequence 级 loss reduction。
这些值是该脚本快照的配置,不是所有 RynnBrain 训练与推理的统一上限。max_frames=512 与视觉长度限制同时存在,也不意味着任何 512 张高分辨率图像都能完整放进一次输入。
脚本中的模型路径、数据路径和分布式环境变量需要用户提供。论文里的 global batch size 还必须结合实际数据并行度、micro batch 与梯度累积计算,不能只从一个启动脚本的 micro_batch_size 推断。
7. 1.1 接触点:为什么“一个点加一个角度”仍不是抓取姿态
当前接触点 Cookbook 使用历史标签 grasp pose 序列化结果,但将其解释为二维接触点和图像平面内的无向朝向;角度按 180° 周期显示。图中的定长朝向线不是夹爪开度。官方接触点示例
为了说明协议,可构造以下人工示例:
<grasp pose> (500, 250), 190 </grasp pose>在该可视化约定下,190° 与 10° 描述同一条无向轴。但这不意味着真实夹爪在三维空间绕任意轴旋转 180° 都等价:电缆、手腕姿态、障碍物、非对称手指都可能破坏这种等价性。
把这一输出接到机器人前,还缺少:
- 深度或可信三维估计;
- 相机到基座的外参;
- 末端姿态与工具坐标约定;
- 夹爪尺寸、接近方向与碰撞余量;
- 逆运动学、关节限制及路径可行性;
- 接触后的力、滑移与成功反馈。
因此,“模型在杯柄上画了一个点”可以作为一个感知结果,不能直接作为抓取成功率,更不应被描述成完整六自由度抓取解。
7.1 算例:从接触点走到相机三维坐标
假设收到下列人工构造的接触点回答,图像为 1920×1080,且已完成畸变矫正。把附带的 grounding_contracts.py 下载到同一目录,即可运行:
from grounding_contracts import (
    parse_contact, normalized_to_pixels, backproject,
)

response = "<grasp pose> (500, 250), 190 </grasp pose>"
xn, yn, angle = parse_contact(response)
u, v = normalized_to_pixels(xn, yn, width=1920, height=1080)

# 独立给定的相机 Z 深度,单位米;不是模型接触点输出中的字段。
p_camera = backproject(
    u, v, depth=2.0, fx=1000, fy=1000, cx=960, cy=540,
)
print((u, v), angle)  # (959.5, 269.75) 10.0
print(tuple(round(x, 4) for x in p_camera))
# (-0.001, -0.5405, 2.0)
逐层看结果,能明确每一步补充了什么信息:
| 步骤 | 已得到的信息 | 仍未得到的信息 |
|---|---|---|
| 解析回答 | 归一化点和图像平面内朝向 | 目标是否识别正确 |
| 恢复像素 | 原图上的接触位置 | 距离相机多远 |
| 加入内参和 Z 深度 | 相机坐标系中的三维点 | 基座坐标、工具姿态和可达性 |
| 接入几何与控制模块 | 可进一步构造工具目标 | 真实接触与任务是否成功 |
这里的 depth 是沿相机光轴的 Z 坐标。若传感器给的是到相机中心的欧氏距离 ,应先换算:
深度必须与 RGB 对齐,并对应同一观测时刻。接入深度图时,还应把连续坐标与数组索引分开:
- 几何点写作
(u,v),分别表示列、行;形状为(H,W)的深度数组用depth[v_index,u_index]访问。 - 本例像素点
(959.5,269.75)若采用“最近邻,半整数向较大索引取整”,对应列 960、行 270。先验证坐标在图内,再用floor(x+0.5);直接int(x)会截断,改变采样规则。 - 取出的深度应转换为米,并检查是否有限、是否有效;零值或无效标记不能当成表面距离。物体边缘的前景和背景深度不应直接平均。
最近邻取值表示用邻近像素的深度近似该连续点的深度;反投影仍使用原来的 (u,v)。若选择把点本身也移动到整数像素中心,则应同时记录新的二维点。示例中的 2 米是独立给定值,不是对某张真实深度图的测量。
这个链条也能估算误差量级:固定深度时,。在 2 米距离、1000 像素焦距下,水平偏差 5 像素就对应 1 厘米横向误差,尚未计入深度、外参和时间同步误差。这解释了为什么像素定位分数还需要结合具体操作容差评价。
8. 1.1 的 3D Grounding:最容易出错的是单位和坐标协议
8.1 从单目图像到三维框,增加了什么输入
官方 3D Cookbook 以 RGB 图像和相机内参为条件,输出三维中心、局部尺寸与姿态。相机坐标约定为 向右、 向下、 向前。固定版本 3D 示例
用标准针孔关系解释为什么内参重要:
若已知可信深度 ,才可以反投影为:
但 RGB 模型并没有直接获得真实深度传感器读数。它预测的米制尺度包含学习到的场景和物体先验;单幅图像仍存在尺度歧义。输入真实内参有助于约束问题,不会让所有单目预测变成几何真值。
8.2 本次核对发现的角度说明冲突
在上述固定提交的 Notebook 中,提示词一方面称角度是 radians,另一方面又把 [-1,1] 对应到 [-180°,180°];可视化函数实际按后者转换。
两种解释在数学上不同:
例如输出 ,两种解释分别得到约 28.65° 和 90°。因此,解析器必须显式选择角度编码,并保留原始值供核查。
如果目标是复现该 Notebook 的投影图,应明确采用其实际可视化约定,并记录转换;如果目标是接机器人,应先通过数据标注、评测实现和已知姿态样本确认单位,不能直接把原始三个角度传入机器人驱动。
该示例还保留了开发机路径与 RynnBrain-8B 模型名,同时选择了 qwen3_5 wrapper。它们都需要按实际检查点修改。这也是本文提供独立最小推理脚本、而不声称原 Notebook 可原样运行的原因。
8.3 三维框不等于可用的末端目标
模型预测的是物体框;机器人需要的是工具目标。两者至少还相差一个任务相关的变换:
这里 分别表示基座、相机和物体坐标系, 表示把相机坐标转换到基座坐标。物体到工具的相对变换取决于抓取策略,需要在物体检测之后确定。
对于对称物体,三维框的朝向还可能不唯一。比较姿态误差时应考虑物体对称性,否则“框看起来一样”与“欧拉角逐项接近”可能给出不同结论。
8.4 把三维框重新投影回图像
一个实用的调试闭环是:中心、尺寸、角度 → 八个角点 → 像素投影 → 对照原图。它能检查投影是否自洽;米制尺度还需要独立证据。
固定版本 Cookbook 的 euler_to_rotation_matrix 将三个输出依次用于绕 轴旋转,再组合为 。虽然变量叫 pitch,yaw,roll,它们的轴对应关系不能套用另一个机器人库对同名变量的解释;box3d_corners_from_params 则使用完整边长的一半构造局部角点。对应源码
本文统一写成绕各坐标轴的欧拉角参数 ,采用列向量、主动旋转:
按这个乘法顺序,最右侧的 先作用;如果代码存的是行向量,则等价写法是 local @ R.T + center,不是 local @ R + center。
设完整尺寸为 ,八个局部角点来自:
下面是独立构造的几何算例,没有调用模型。中心在相机前方 2 米,尺寸为 0.6×0.2×0.4 米:
from grounding_contracts import box_corners, project_point

corners = box_corners(
    center=(0, 0, 2), dimensions=(0.6, 0.2, 0.4),
    angles=(0, 0, 0), encoding="radians",
)
uv = project_point(corners[0], fx=1000, fy=1000, cx=960, cy=540)
print(corners[0])                        # (-0.3, -0.1, 1.8)
print(tuple(round(value, 2) for value in uv))  # (793.33, 484.44)
若改成 angles=(0,0,0.5), encoding="normalized_pi",表示按本文协议绕 轴转 90°,第一个角点变为约 (0.1,-0.3,1.8)。如果把同样的 0.5 当成弧度,就不会得到这个结果。
再做一个尺度反例:保持朝向不变,把相机坐标中的中心和三条边长同时乘 2,所有角点也变成原来的两倍。由于 ,八个角点的像素投影完全相同,物体却被放到了两倍远处。
接着上面的代码运行:
from math import isclose

scaled_corners = box_corners(
    center=(0, 0, 4), dimensions=(1.2, 0.4, 0.8),
    angles=(0, 0, 0), encoding="radians",
)
for original, scaled in zip(corners, scaled_corners):
    a = project_point(original, fx=1000, fy=1000, cx=960, cy=540)
    b = project_point(scaled, fx=1000, fy=1000, cx=960, cy=540)
    assert all(isclose(x, y) for x, y in zip(a, b))
print("8 corner projections match; metric scale differs by 2x.")
因此,叠加图检查与米制误差检查应分别验收。深度传感器、已知尺寸标靶或带可信尺度的多视角参考,可以提供单张叠加图缺少的尺度约束。整体把毫米误当成米,也可能逃过这个投影检查。
附带代码检查正边长和有限数;投影时拒绝 的点,而不是除以一个很小的正数把它“修好”。真正绘制跨越相机近裁剪面的边,还需要线段裁剪;本例只验证角点几何,不实现完整渲染器。
8.5 缩放、裁剪和相机内参必须属于同一张图
假设你在模型输入之前明确执行了一个已知像素变换:
把第 8.1 节的针孔关系代入,可得对应内参:
例如先从原图左侧裁去 100 像素,再按原点对齐的坐标约定缩小一半,则 。原 fx=1000,cx=960 应对应 fx'=500,cx'=430;只修改焦距、不移动主点是不完整的。
这个例子先声明了坐标变换。真实缩放器若采用 half-pixel 采样,还会有半像素偏移;畸变矫正和旋转也不能概括成随意乘一个比例。不要仅凭输出图尺寸反猜完整变换,更不要自行把 Processor 内部 tile 的局部坐标当成模型协议中的全图坐标。
最小脚本只接受没有 EXIF 方向标签或方向值为 1 的图片,保留文件存储的像素方向,不静默旋转。手机图片若需要转正,应先统一图像、像素标注与相机约定。Notebook 在缺少内参时还有假设视场角的回退示例;这适合演示接口,不等于完成了相机标定。官方自定义输入示例
8.6 从相机到基座:外参方向与观测时间
接着第 7.1 节的三维点 米,构造一个顶视相机例子:相机位于基座的 米处,光轴朝下,相机 轴与基座 轴同向。声明:
这是一个行列式为 的旋转,等价于绕 轴转 180°。使用列向量:
该点在基座上方 0.5 米处,与本例的相机高度和观测深度相符。若标定文件保存的是反方向 ,应先求逆:
只转置旋转、却保留原平移,会得到错误结果。这里变换的是点;方向向量只乘旋转,不加平移。完整工具姿态还需按第 8.3 节组合变换。
对于装在腕部的相机,外参随机器人状态变化,应使用图像采集时刻 的关节状态:
其中 是末端坐标系, 来自手眼标定。把推理完成时刻的末端位姿套到旧图像上,即使所有单位都正确,也会产生空间偏移。模型原始输出、图像时间戳和机器人状态时间戳应一并保存。
9. RynnBrain-VLA:动作建模与基础 VLM 的分界线
9.1 从文本生成切换到动作块预测
1.1 的 VLA 描述采用 single-stream DiT 与 flow matching,将语言、视觉、机器人状态和带噪动作块放入一个交互模型;动作块位于序列末端以支持前缀缓存。这属于下游动作策略,不是基础模型 .generate() 多输出几行文本。1.1 报告,第 4 节
下面用一般 flow matching 写法解释它在学什么,不是逐行复刻官方实现。设 是示教动作块, 是噪声,取:
模型在观测条件 下拟合速度场:
推理时从噪声出发积分得到动作块。这与离散语言 token 的逐个采样不同;工程上需要额外确认噪声路径、时间方向、动作归一化和求解步数,不能只凭这一公式猜官方超参数。
9.2 81 维统一动作空间的含义
报告将统一空间分为以下语义组:
| 组 | 维数 |
|---|---|
| Arm-Joint | 14 |
| Arm-EEF | 18 |
| Gripper | 2 |
| Hand | 40 |
| Torso | 4 |
| Head | 3 |
| 合计 | 81 |
具体机器人只激活可用部分。报告图 3 附近给出的评估本体激活情况是:
| 本体 | 在 81 维中激活的组 | 说明 |
|---|---|---|
| Unitree G1 | Hand(14 维,每手 7 维) | 另有一个独立预测的 64 维 SONIC latent,不在 81 维中 |
| Astribot S1 | Arm-Joint(14)、Gripper(2)、Head(3)、Torso(4) | 合计 23 维 |
| Tianji-Wuji | Arm-Joint(14)与 Hand(40) | 灵巧手平台 |
G1 的独立 64 维 SONIC latent 与 81 维统一空间是并行输出,不能把二者相加后说成每个平台都输出同样的关节向量。动作空间出处:报告图 3 与第 4.2 节
理解 mask 的关键:不存在的自由度不应被当作“目标值恰好为零”的有效训练标签。一个教学损失可以写为:
这里 是动作块长度。实际系统还可能有时间步 mask、不同动作组的权重及各本体的归一化统计,不能把这个简式当成完整训练配方。
9.3 统一向量不等于统一驱动
即使两个机器人都有“左臂关节”字段,关节数量、方向、零位、可动范围、控制模式仍然可能不同。动作组按语义对齐后,还需要适配层把策略输出变成平台的合法输入。
我会在适配层强制记录:关节顺序、单位、绝对/增量模式、时间戳、执行时长、归一化统计版本,以及缺失动作组的处理规则。任何一项不匹配,都可能让形状完全正确的张量产生错误动作。
9.4 动作块能减轻调用开销,也会带来延迟问题
假设推理耗时 秒,策略动作的采样间隔为 ,在结果返回时已有约 个动作步过去。例如人工设定 秒、 秒,就对应 6 个动作步;仍从新块第 0 步执行,相当于忽略了这段时间。这里的间隔属于动作块的时间轴,要与底层伺服周期分别记录。
因此应区分策略推理频率、动作块覆盖时长与底层伺服频率。不能由“模型能够一次预测多个动作”推出它能够直接替代底层实时控制与安全监控;1.1 给出的实时衔接方案是下一节的 RTC。
9.5 三层部署框架与 RTC:动作块怎样变成连续控制
1.1 报告给出的跨本体部署框架分三层:框架出处:第 4.3 节
- Model layer:运行 VLA 策略,在标准动作空间中产出 32 步动作块;
- Control layer:两个独立循环——30 Hz 的低频环负责推理时机、交互界面与动作源切换,200 Hz 的高频环把动作块插值到目标控制频率并下发命令,二者通过共享内存通信;
- Embodiment layer:把标准格式动作分发给对应执行器,并把机器人状态与多相机图像(字典键与训练时的命名一致)格式化回模型层。
报告将新增本体的软件接入集中在 Embodiment layer,使模型与控制层可以复用。这里描述的是部署接口的模块化:新平台仍需核对动作组、归一化统计、观测分布和策略适用性,不能据此推断已有权重无需适配便能完成任务。
RTC(Real-Time Chunking)解决的是动作块之间的衔接:RTC 出处:第 4.4 节
- 触发时机:模型预测 32 步动作块,但不等待整块执行完——每执行 5 步就触发一次新推理;
- action-guidance:新块去噪时,上一块尚未执行的部分按 action-guidance 公式引导去噪,强度 ;
- 引导权重分三段:前 5 步以及推理期间会被消耗的步(用最近 10 次推理耗时的滑动平均估计)权重为 1,随后平滑过渡到 0,块尾不施加一致性约束。
这种引导鼓励新旧动作块在衔接段保持一致,同时给后续动作保留调整空间;它是生成过程中的约束,实际连续性仍需检查相邻命令的位置、速度和加速度。
这正好回应第 9.4 节的延迟问题:RTC 让“旧块还在执行、新块已在计算”成为常态,而不是等整块结束再切换。但它处理的是策略层的实时衔接;200 Hz 插值、限位与急停仍属于底层控制,不能由 RTC 替代。
10. 实验怎么读:离线空间能力与机器人完成率要分开
10.1 RynnBrain-Bench 在测什么
官方数据卡介绍该基准包含 3,616 段视频、12,000 道开放式问题、21 项子能力,覆盖对象认知、空间认知、Grounding 与 Pointing。它是具身理解评测,不是 12,000 次机器人抓取试验。基准数据卡
建议分别看答案正确性、空间误差、格式有效率和跨帧一致性。若一个模型经常不按格式回答,应同时报告格式失败率;不能把无法解析的样本全部丢弃后,只评价剩余样本。
此外,视频级隔离通常比问答行级随机切分更有意义。同一视频中的多个问题如果分别进入训练和测试,模型可能利用场景重叠获得过于乐观的成绩。
10.2 报告中的真实机器人对照
下面只摘录 1.1 报告表 6 的最终成功率,单位为百分比,不混入过程得分:
| 模型 | 撒花瓣 | 倒酒 | 取锅铲 | 三任务平均 |
|---|---|---|---|---|
| Qwen-Based-VLA | 65 | 65 | 50 | 60.00 |
| RynnBrain-VLA | 85 | 80 | 95 | 86.67 |
| RynnBrain-VLA Generalist | 85 | 95 | 95 | 91.67 |
每个任务进行 20 次尝试,初始物体摆放随机;前两个任务在 Astribot,第三个在 Tianji-Wuji。表中前两种模型采用相同 VLA 后训练配方与 32 步动作块长度,因而比跨不同完整系统的比较更接近“更换基础模型”的研究问题。原始表还包含 GR00T N1.7 与 π0.5 两个完整基线,它们使用各自更长的动作块(40 与 50 步)。原始协议与完整对照表
报告同时给出过程得分:三个任务分别有 4、5、3 个子任务,过程得分是 20 次试验中完成的子任务比例。三个模型的过程得分平均为 68.33、91.28 与 94.14,与成功率同方向但不重合。部署侧还有一个容易漏掉的事实:这些实验的推理在一台配备单张 RTX 4090 的工作站上完成,数字不能直接推广到其他硬件组合。
个人解读有四点:
- 20 次试验中,一次成败对应 5 个百分点,因此不应把小差异解释为极其精确的总体概率差。
- 过程得分衡量子任务完成比例,不表示整项任务成功。
- Generalist 的改进支持在这些设置下联合训练的价值,不证明任意新机器人都能零样本迁移。
- 若比较完整基线,应保留动作块、控制器和数据设置;不能只拎出一个平均数做“全面领先”的结论。
10.3 自建定位评测:分母与误差协议先确定
将任务输出拆成“解析成功”和“定位正确”两层,才能看出错误发生在哪里。以下是人工计数例子:100 个请求中,90 个符合输出协议,其中 72 个同时满足目标身份与预先设定的定位阈值。
| 指标 | 分母 | 本例结果 |
|---|---|---|
| 格式有效率 | 全部请求 | 90/100 = 90% |
| 有效输出中的定位正确率 | 可解析输出 | 72/90 = 80% |
| 端到端定位正确率 | 全部请求 | 72/100 = 72% |
80% 描述解析成功后的条件表现;评估完整输入到输出链时,10 个格式失败也应计入分母。如果允许重试,应另报首次结果、最终结果与平均调用次数。
“定位正确”还需要任务协议。对于接触点,至少明确:
- 参考图像:统一原图、裁剪图与像素中心约定,再计算像素距离;跨分辨率比较可除以图像对角线,同时保留原始像素误差。
- 有效区域:若多个接触位置都合理,应使用预定义的可接触区域或多个参考点,避免只认一个任意标注点。
- 周期角度:图像平面中的无向轴按 180° 周期比较。1° 与 179° 的轴向误差是 2°,不是 178°。
- 时间与身份:视频中先检查帧索引和对象身份;坐标接近但落在错误帧、错误实例上,仍是任务失败。
这里建议的是自建评测协议,与官方基准的打分实现分别记录。相邻视频帧高度相关,统计误差或划分训练/测试集时,应以视频或独立场景为分组单位。
11. 可运行的入门材料:先离线验证协议,再尝试模型
11.1 不下载权重的坐标与接口练习
本文附带 grounding_contracts.py,仅使用 Python 标准库,包含:归一化接触点解析、像素映射、针孔投影与反投影、显式角度编解码、旋转矩阵、三维框角点及 mask 损失检查。
在本文页面包目录运行:
python3 grounding_contracts.py它验证的是自拟数值和错误输入的处理,不是 RynnBrain 模型精度。程序会拒绝越界坐标、非有限数、未知角度编码、非正深度和空动作 mask。
例如,接触点 (500,250) 在 1920×1080 图像上应映射到 (959.5,269.75);若 fx=fy=1000、主点为 (960,540)、输入像素为 (1060,540) 且深度为 2 米,则反投影结果为 (0.2,0,2) 米。
11.2 单图最小推理,不直接控制硬件
下载 infer_image.py 并进入文件所在目录。脚本固定使用 RynnBrain1.1-2B 及文末记录的权重 revision,沿官方 AutoProcessor 与 AutoModelForImageTextToText 路线读取本地图像并打印回答。官方推理入口
建议单独建环境,避免与 InternVL 的研究环境混装:
python3 -m venv .venv-rynnbrain
source .venv-rynnbrain/bin/activate
python -m pip install --upgrade pip
# 先按本机 CUDA/驱动选择兼容的 PyTorch 与匹配的 torchvision。
python -m pip install "transformers==5.2.0" pillow
python infer_image.py --image /absolute/path/to/scene.jpg --prepare-only
先用 --prepare-only 检查图像、模板与输入预算;各字段的含义见第 11.4 节。确认输入后,在兼容的 CUDA 设备上去掉该参数即可加载权重并生成回答。脚本优先使用 BF16,否则使用 FP16;首次权重推理需要下载模型。
此前的 CPU 检查覆盖固定 revision 的原生模型类解析与输入构造:使用本站 Transformer 文章的结构图和提示词 Describe the diagram.,生成 1526 个输入 token,浮点图像张量均为有限值,并核对了关闭 Thinking 时的模板前缀。这验证 Processor 与输入接口可以对接,不验证模型是否答对。脚本先渲染聊天模板,再处理图片,避免 Transformers 5.2.0 把 enable_thinking 同时转发给图像处理器所产生的无效参数警告。
从 2B 模型文件元数据可核对约 22.13 亿个 BF16 参数。仅参数存储约为 字节,即约 4.43 GB;这不是所需显存,还需输入、激活、缓存和运行时余量。
11.3 推理成功后的建议顺序
| 验证阶段 | 保留的证据 | 通过条件 |
|---|---|---|
| 场景描述 | 原图、提示、原始回答 | 能识别任务相关对象 |
| 二维定位 | 原始空间序列、解析结果、叠加图 | 格式、对象身份与位置同时正确 |
| 三维定位 | 内外参、时间戳、独立几何参考 | 单位与变换一致,误差满足任务要求 |
| 动作策略 | 观测、动作块、实际状态、任务结果 | 在回放或仿真中验证,再进入真实平台 |
二维阶段按第 10.3 节统计格式与定位指标;三维阶段用尺寸、距离已知的静态场景交叉验证。真实执行另需独立限位、碰撞检查和急停,不能从叠加图看起来正确直接跳到硬件控制。
11.4 先在 CPU 上检查真实输入
第 11.2 节的 --prepare-only 命令调用真正的 Processor;安装匹配的 CPU 依赖即可运行,不要求 GPU。输出报告可按下表核对:
| 字段 | 核对内容 |
|---|---|
revision、transformers | 是否与本文固定的权重和库版本一致 |
image_size、image_frame | 是否对应用于标注与叠加显示的原图 |
input_tokens、reserved_output_tokens | 完整输入长度与计划生成上限 |
inputs | 各张量的形状与 dtype,供后续运行对照 |
reserved_output_tokens 只是计划输出预算,不表示已分配 KV Cache。model_weights_loaded=false 与 model_forward_executed=false 明确标出检查范围;首次会按需下载 Tokenizer、Processor 等小文件。
小文件缓存齐全后,可以明确禁用 Hub 网络访问:
HF_HUB_OFFLINE=1 python infer_image.py \
  --image /absolute/path/to/scene.jpg \
  --prepare-only --local-files-only
这里的“离线”与 grounding_contracts.py 不同:后者只需要标准库,前者还需要已安装的深度学习依赖和缓存文件。缓存不足时应明确失败,不会自动切换另一个模型。
本例的 --max-input-tokens 只约束输入,默认上限 16384;--max-new-tokens 是单独的生成上限。这是教学入口的保护阈值,不表示任意输入加任意回答都在论文的训练长度之内。准备阶段会在加载权重前拒绝超限输入;它不做截断,因为随意截断可能破坏视觉占位与特征的一一对应。
11.5 失败发生在哪一层,就检查哪一层
| 现象 | 优先检查 | 不能由此推出 |
|---|---|---|
| 模型架构无法识别 | 环境是否确实为脚本要求的 5.2.0、revision 是否匹配 | 权重损坏或模型能力差 |
| 离线模式找不到文件 | 对应 revision 的处理器与 Tokenizer 是否缓存完整 | 必须下载全部模型权重才能检查输入 |
| 空间结果整体偏移 | 裁剪、缩放、图像方向、像素中心与内参 | 加长 Thinking 一定能修正 |
| 三维框绕错轴 | 角度单位、轴对应、列/行向量、乘法顺序 | 只要交换两个数字就一定正确 |
| 输出合法但目标错误 | 对象身份、遮挡和任务语义 | 严格解析器已经保证物理正确性 |
排查时保存原始输入和原始回答;任何单位转换、坐标恢复、拒绝原因都应单独记录,才能定位是模型判断错,还是后处理改错了。
12. 源码阅读清单:如何避开“看起来可以运行”的示例
| 检查项 | 本次核对看到的风险 | 正确处理 |
|---|---|---|
| 版本路径 | 1.0 功能保留在历史分支 | 记录仓库 commit 与模型 revision |
| 3D 角度 | radians 描述与归一化转换冲突 | 明确 codec,利用已知姿态核验 |
| 3D 模型选择 | Notebook 的模型名与 wrapper 家族不一致 | 根据实际配置选择正确检查点 |
| 开发机路径 | 示例包含不可移植路径 | 改为用户提供路径,不复制开发机目录结构 |
| 数据 JSON | 文档示意与严格 JSON 不完全等价 | 通过解析器后再交给训练入口 |
| 接触点标签 | 历史名称不等于完整抓取姿态 | 按该版本实际输出语义解析 |
| VLA 开源状态 | RynnScale 项目小节仍为占位 | 不宣称已有可复现全部硬件结果的一键脚本 |
这些结论固定于本文记录的提交,不代表未来版本仍有同样的问题。进一步开发时,应重新核对上游变化,并把本地修正与原始论文结论分开记录。
13. 与 InternVL 3.5、Being-0 该怎样放在一起理解
RynnBrain 更适合沿“时空观测—空间语义—机器人策略迁移”这条线研究;InternVL 3.5更适合沿“通用多模态输入—推理后训练—视觉 token 与服务效率”研究。
Being-0则提供了另一种系统视角:高层理解、连接协调与既有技能的衔接。它们可以帮助解释不同层的职责,但不能把不同论文的成功率直接排成统一排行榜。
如果目标是做自己的机器人系统,我会先写一份输入输出契约,再选择模型:系统需要的是对象描述、位置、目标姿态、技能调用,还是动作块?缺少哪个中间环节,决定了后续适配工作量。
14. 局限、可研究的问题与复现记录
值得继续研究的不是单一“能不能抓”的演示,而是:
- 历史帧选择策略是否影响短事件与遮挡恢复;
- 三维估计在真实尺寸变化、镜面、透明物体上的失效方式;
- 接触点的多个合理答案应如何评价;
- 空间输出错误如何传播到规划和动作;
- 联合训练的提升来自共享视觉知识,还是更多任务数据本身;
- 不同机器人、相机与控制模式下,哪些模块可以复用,哪些必须重新学习。
每次实验至少记录:模型及 revision、代码 commit、图像预处理、帧采样与时间戳、任务提示版本、输出解析器、随机种子、解码预算、失败计数与硬件配置。只保留成功截图,无法支持可重复的能力结论。
阅读自测与验收
- 能否明确区分 1.0 与 1.1、2B/9B 的 3D 能力范围,以及基础 VLM 的空间输出与 VLA 动作块?用官方配置和模型 ID 逐项核对。
- 运行离线协议测试,解释归一化点、相机内参、角度编码和动作 mask 的作用;面对非法输出应拒绝执行,而不是自动裁剪成貌似可用的命令。
- 用一个已知三维姿态样本分别检查两种角度解释,记录不能确定的协议;不把生成图、Notebook 可视化或本文自拟算例当成真实机器人结果。
- 能否按明确的轴顺序构造八个角点并投影回图像,再用 CPU 预检查验证真实输入预算?区分几何一致、接口可用和模型判断正确这三种结论。
- 能否写出 1.0 CoP 的一种带帧索引输出格式,并说明 Thinking 角色与 GRPO 组内采样的作用?
- 能否解释 32 步动作块、30/200 Hz 双环与 RTC 引导权重的衔接,并说明过程得分与最终成功率的区别?
展开核对:三个关键算例的答案
- 接触点
(500,250)对应1920×1080原图的(959.5,269.75);按第 7.1 节内参与 2 米 Z 深度,得到相机点(-0.001,-0.5405,2)米。 - 第 8.6 节顶视相机外参将该点变成基座点
(0.499,0.5405,0.5)米。它仍未指定工具朝向或抓取偏移。 - 原始角度
0.5在 radians 编码下约为 28.65°,在 normalized-pi 编码下为 90°。先选择编码,再按已声明的轴顺序组合旋转。
参考材料与版本快照
- RynnBrain 1.0 报告:2602.14979v1:原始问题定义与 CoP、Nav、Plan、VLA 研究路线。
- RynnBrain 1.1 报告:2607.17977v2:1.1 能力范围、动作空间与实验协议。
- RynnBrain 仓库快照:5b86419:本文源码核对基线。
- RynnScale 快照:aaedf10:公开训练与评估入口。
- RynnBrain1.1-2B 模型卡:权重 revision 为
b4663299019d15468301f64435539632daed7985。
模型卡和代码仓库标注 Apache-2.0;实际使用还应分别核对所用权重与数据的具体许可,不把仓库许可证自动扩展为所有第三方数据的授权。