大语言模型训练与指标详解:参数、权重、预训练、后训练与消融实验
本文目录 展开章节导航
读懂一份大语言模型训练报告,需要同时回答四个问题:模型有多大、训练用了多少资源、优化目标是否改善、独立评估中的能力是否提升。 参数量、loss、奖励和榜单分数分别回答其中一部分,不能互相替代。
例如,“7B 模型,4-bit 权重,SFT loss 下降,DPO 偏好准确率达到 80%”仍不足以说明模型更好:7B 是参数数量,4-bit 是存储方式,SFT loss 取决于监督哪些 token,而 DPO 的偏好准确率衡量给定回答对的相对分数,不是新问题的回答正确率。
本文以自回归大语言模型为主线,覆盖预训练、继续预训练、监督微调和偏好/强化学习后训练。“恰好 70 亿参数”的资源预算、概率序列和消融数据均为算例;Qwen2.5-7B 的结构与权重载荷则来自固定版本的公开配置和索引核对。 二者都不是本文实测的模型能力。配套指标计算脚本只使用 Python 标准库,无需下载模型;本文没有复现大模型训练。
阅读路线
| 想解决的问题 | 对应章节 |
|---|---|
| 7B 到底多大,4-bit 为什么还会显存不足 | 规模与权重、显存与算力 |
| 预训练、SFT、DPO、RL 有什么区别 | 训练阶段 |
| loss、PPL、token accuracy 怎么读 | 预训练指标、SFT 指标 |
| reward 上涨是不是能力上涨 | 偏好与 RL 指标 |
| 如何比较两份模型报告 | 能力评估、部署指标 |
| 如何证明一个模块或数据处理有效 | 消融实验、记录模板 |
1. 参数量、模型大小和权重大小
1.1 先给“大小”加上单位
| 名称 | 含义 | 读报告时要确认 |
|---|---|---|
| 参数量 | 模型中独立参数的标量总数 | 是否含 embedding、输出头、共享参数是否重复计数 |
| 可训练参数量 | 本次允许参与梯度更新的参数数量 | 全参数微调还是 LoRA,哪些层被冻结,优化器是否包含这些参数 |
| 激活参数量 | MoE 等模型一次 token 计算涉及的参数规模 | 路由规则、共享层;不等于总参数量 |
| 权重载荷 | 参数数值本身占用的字节数 | dtype、混合精度、量化方式 |
| 模型发布目录 | 权重加配置、tokenizer、模板及附属文件 | 是否混有多个版本、adapter 或重复格式 |
| 恢复训练 checkpoint | 为继续训练保存的状态集合 | 优化器、调度器、步数、随机状态、数据游标 |
| 运行显存 | 某次训练或推理中的设备内存占用 | batch、长度、缓存、并行方式与峰值测量口径 |
7B 通常表示约 个参数,B 是 billion。GB 是 字节,GiB 是 字节;“14 GB”和“约 13.04 GiB”可以指同样多的字节。
同样是 7B,不同层数、隐藏宽度、词表大小、KV 头数和上下文设计,也会产生不同吞吐和缓存需求。MoE 的总参数影响存储,激活参数帮助估算单 token 计算,但实际速度还受路由、通信和专家负载影响,不能把“激活 7B”直接等同于稠密 7B。
1.2 原始权重体积怎样计算
如果所有参数采用同一种存储位宽 :
对恰好 70 亿参数,忽略其他文件与量化元数据:
| 存储格式 | 每参数字节数 | 原始载荷 GB | 原始载荷 GiB |
|---|---|---|---|
| FP32 | 4 | 28.00 | 26.08 |
| FP16 / BF16 | 2 | 14.00 | 13.04 |
| INT8 | 1 | 7.00 | 6.52 |
| 理想紧密打包的 4-bit | 0.5 | 3.50 | 3.26 |
FP16 与 BF16 字节数相同,但数值范围和精度分配不同。量化通常还要保存 scale、可能的 zero-point,以及保持较高精度的部分张量;实际 4-bit 文件不必恰好等于 3.50 GB。加载后也可能出现反量化工作区和额外副本。压小权重文件不会自动压小所有运行时内存。 混合精度内存构成
1.3 LoRA 的“小”具体指什么
对原矩阵 ,LoRA 用低秩增量 表示更新。其中 的形状为 , 为 , 是低秩维度, 控制增量的缩放:
例如一个 矩阵有 16,777,216 个参数,rank 16 的两个低秩矩阵只有 131,072 个参数,即原矩阵的约 0.78%。这只是一个目标矩阵的算例,全模型比例还取决于目标层、rank、bias 和额外可训练模块。LoRA 论文
LoRA 减少的是更新参数及其梯度、优化器状态;推理仍需要底座与增量,或合并后的完整权重。QLoRA 将量化底座与低秩适配结合,存储 dtype、计算 dtype 和 adapter dtype 需要分别说明,不能概括成“全部以 4-bit 训练”。QLoRA 论文
1.4 参数从哪里来:一个简化结构账本
词表大小为 、隐藏维度为 ,embedding 大约需要 个参数;若输出词表投影与 embedding 共享权重,不能再重复加一份。标准多头注意力的 Q、K、V 与输出投影,在输入输出宽度均为 的假设下约为 ;GQA 的 K、V 投影更窄,不能照搬这个数。
普通两矩阵 FFN 约有 个参数,采用三个矩阵的门控 FFN 则约为 。因此一个共享 embedding、标准多头注意力、两矩阵 FFN 的简化 层模型可写成:
这只是结构算例,省略了 bias 和归一化参数,也不适用于直接精算 GQA、MoE 或所有现代 LLM。实际统计应遍历独立参数张量,逐项累加元素数,并另算 requires_grad=True 的元素数;量化打包后的张量元素数可能不再等于原始参数数目。共享权重、多份 checkpoint 文件和同一权重的不同保存格式都不能重复计入模型参数量。
1.5 真实配置核对:为什么 Qwen2.5-7B 不是恰好 7B
以基础模型 Qwen/Qwen2.5-7B 为例,固定模型仓库提交为 d14972939875。其 ,Q 头数为 28、KV 头数为 4,头维度为 128;输入 embedding 与输出头不共享。结构还包含 Q/K/V bias、每层两个 RMSNorm,以及末尾一个 RMSNorm。配置文件、对应结构实现
令 KV 投影宽度 ,可以逐项计算:
| 部分 | 参数计算 | 参数数目 |
|---|---|---|
| 输入 embedding | 544,997,376 | |
| 输出词表投影 | 544,997,376 | |
| 所有层注意力投影矩阵 | 822,083,584 | |
| 所有层 Q/K/V bias | 129,024 | |
| 所有层门控 MLP | 5,703,204,864 | |
| 所有层 RMSNorm | 200,704 | |
| 末尾 RMSNorm | 3,584 | |
| 总计 | 各项相加 | 7,615,616,512 |
BF16 载荷为 15,231,233,024 字节,即 15.23 GB / 14.19 GiB,与该提交的 safetensors 索引 metadata.total_size 一致。这个字段统计张量载荷,不等于把仓库所有文件大小相加,也不是运行显存。本文只读取配置与索引,没有下载数十亿参数的完整权重。权重索引
可下载这份配置与核对值复算。它也说明一个阅读顺序:先确认具体模型及 revision,再读结构和 dtype,最后算字节;不要直接把模型名称中的“7B”代入精确容量规划。
2. 从权重文件走到显存和算力
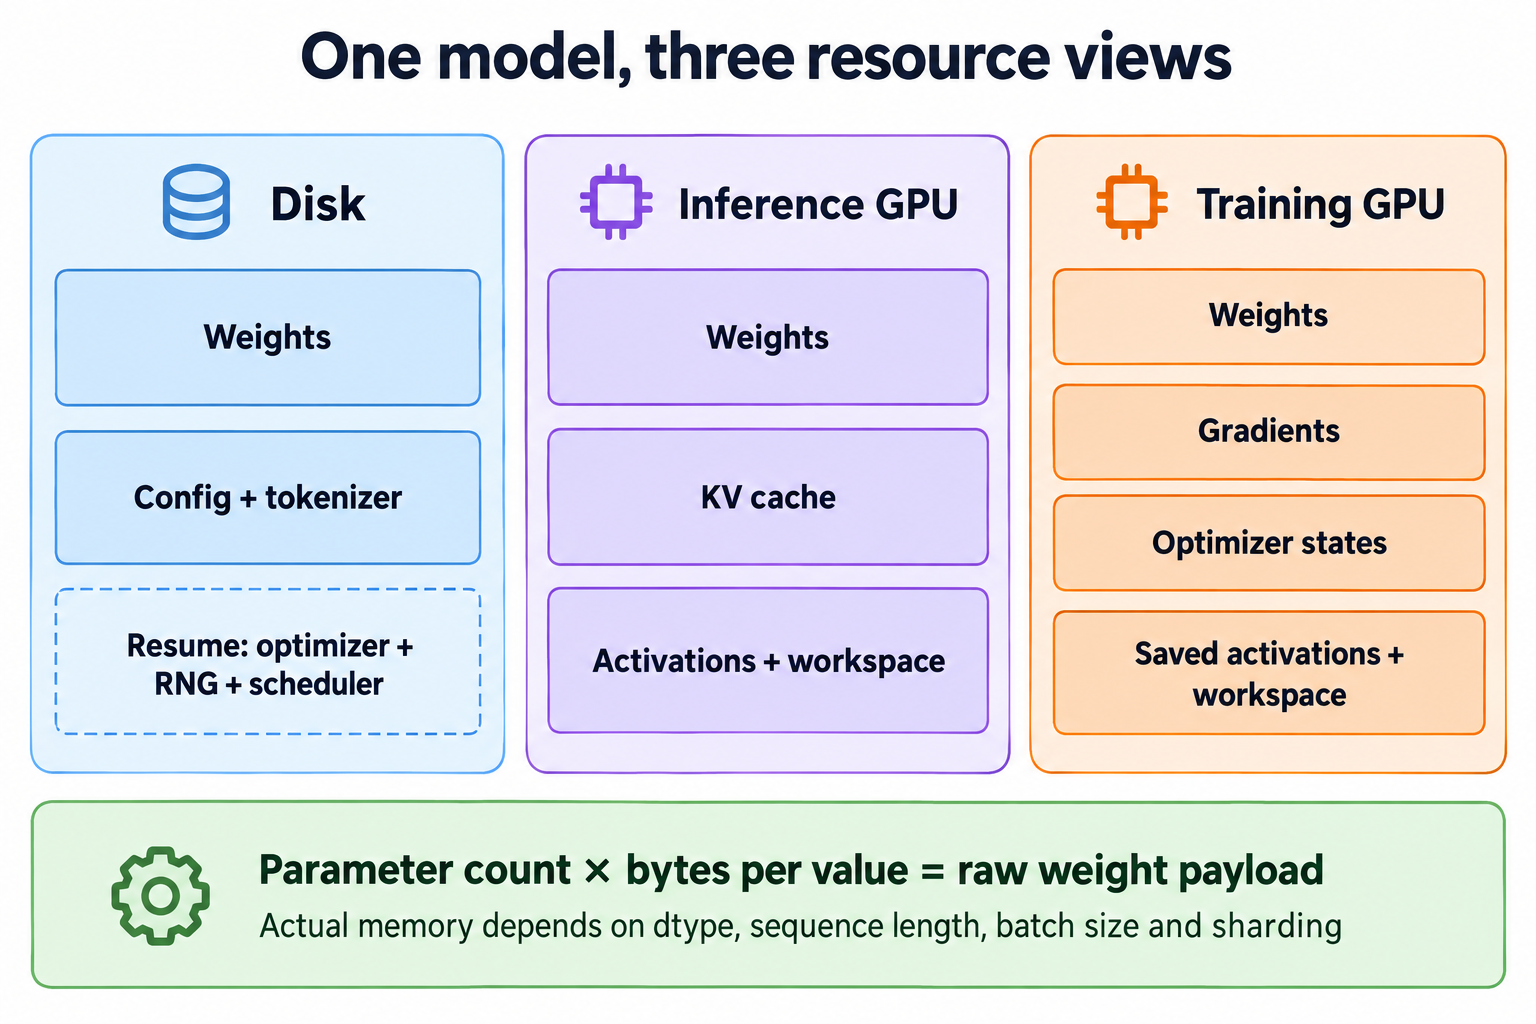
2.1 训练显存没有通用的“参数量乘几”
训练的主要账目为:
以一种明确假定的混合精度 Adam 配置为例:BF16 权重 2 字节、BF16 梯度 2 字节、FP32 主权重 4 字节、FP32 一阶与二阶矩共 8 字节,合计每参数 16 字节。7B 对应 112 GB,尚未计入激活、临时缓冲和运行环境。若梯度为 FP32,同一账本就变成 18 字节/参数;有些实现不保留独立主权重,账本又会不同。
因此,“BF16 训练”“Adam”“7B”三个词仍不足以给出精确显存。分片会改变每张卡的常驻状态,但不意味着把总内存简单除以卡数就得到峰值:参数聚合、通信缓冲和激活可能同时存活。详细的 DDP、ZeRO、FSDP 账本见分布式训练与显存。
冻结权重也不意味着没有激活开销:为了更新网络中的 adapter,反向传播仍可能经过冻结的运算。Activation checkpointing 用重算换内存,通常会改变时间成本,应同时报告。
2.2 推理时,KV cache 会随请求增长
对各层 KV 头数相同、使用普通完整注意力缓存的 Transformer,一份未分片、未量化、没有前缀共享的 KV cache 近似为:
这里 为层数, 为同时保留缓存的序列数, 为每条序列缓存长度, 为 KV 头数, 为头维度, 为每元素字节数;前面的 2 表示 K 与 V。长度不同时用 替换 。KV cache 说明
自设结构 ,得到 512 MiB;8 条相同长度的并发序列为 4 GiB。如果 KV 头数变成 32,其余不变,单条就是 2 GiB。这解释了为什么只看 7B 标签无法估计长上下文并发容量。
前面真实 Qwen 配置的层数和 KV 头数不同:同样按单序列、4096 个缓存 token、BF16 计算,理论 KV 载荷是 224 MiB,而不是 512 MiB。这里仍是结构公式计算,不是实测分配器峰值。
滑动窗口、压缩潜变量缓存、量化缓存、共享前缀、分页分配、预留容量和设备分片需要另建账本;不能不加说明地套用上式。
动手算:权重与 KV 缓存
改变位宽、并发或缓存长度,比较两项理论载荷。所有计算都在当前页面完成。
蓝:权重橙:KV 缓存
按完整注意力、等长序列、无分片、无前缀共享计算。合计不含激活、量化元数据、工作区、预留空间及运行环境,不能直接当作所需显存。
可以先保持默认配置,把权重从 16-bit 改成 4-bit:蓝色权重载荷会缩小,橙色 KV 不会随之缩小。再把并发从 1 改成 8,观察 KV 如何线性增长。点击 Qwen 预设可复算上一节的固定结构;预设重置所有字段,不代表自动选择实际可运行的硬件配置。
2.3 训练 token、步数和 FLOPs
训练时至少区分三种 token:原始语料去重后的 token、累计送进网络的 token、真正进入 loss 分母的目标 token。重复训练两个 epoch 会增加累计处理量,却不会使独立数据多一倍。SFT 的 prompt 参与计算,但在 response-only loss 中不计为监督目标。
固定长度、无 padding 的简单配置中,一次优化器更新处理的输入 token 数为:
是梯度累积次数, 是数据并行副本数;张量并行卡数不能再乘进去当新数据。变长或 packing 场景应累计实际计数。
例如 8 张卡按张量并行 2、数据并行 4 分组,不使用流水线并行;每个副本 micro-batch 为 2,累积 8 次,输入长度为 2048。一次更新处理 个输入 token。两张张量并行卡共同计算一份数据,不能再乘 2。监督 token 还要在 causal shift 和 loss mask 后另外统计。
稠密 Transformer 常用 粗估训练 FLOPs,其中 为累计处理 token。对 7B、1T token,约为 FLOPs。这是数量级预算,未精确建模长序列 attention、重算、稀疏路由与辅助模块,不能直接预测训练时长。Chinchilla 论文
这也解释了“更大模型”和“训练更多 token”是两个不同投入方向。所谓计算最优取决于预算和实验分布;为降低大量部署请求的推理成本,选择较小模型并训练更久,也可能合理。不要把某个参数/token 比例当作所有任务的固定定律。
FLOPs 表示运算量,FLOP/s 表示运算速率。若报告 GPU 小时,还需同时给出卡型号、卡数、精度和墙钟计时边界:8 张卡运行 10 小时是 80 GPU 小时,不能直接与另一型号的 80 GPU 小时视作相同计算量。本文不据此推算云服务费用。
3. 预训练与后训练处在什么位置
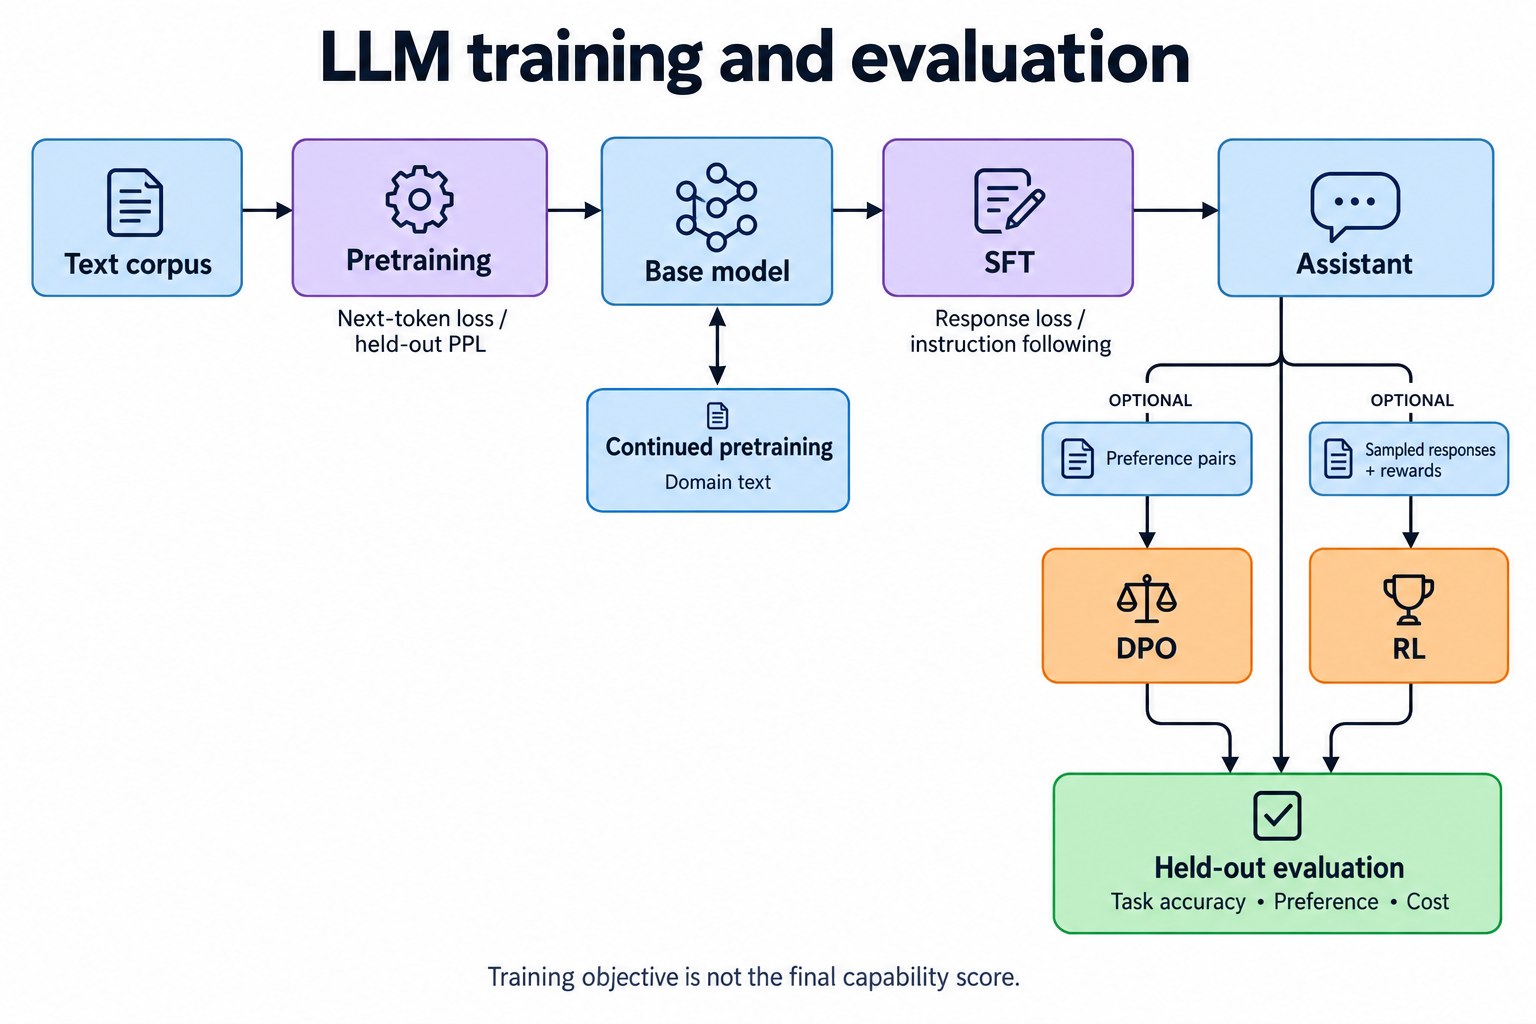
| 阶段 | 起点与数据 | 主要优化目标 | 优先检查的结果 |
|---|---|---|---|
| 预训练 Pretraining | 通常从随机初始化开始,大规模文本等数据 | 给定前文预测下一个 token | held-out loss、PPL、跨领域能力与成本 |
| 继续预训练 CPT / DAPT | 已有基础模型,领域或新增语料 | 常继续使用语言建模目标 | 领域改善与通用能力回退 |
| 监督微调 SFT | 基础模型,指令与示范回答 | 提高示范目标 token 的条件概率 | 指令遵循、任务正确率、格式与泛化 |
| 偏好优化,例如 DPO | 已有策略,同题 chosen / rejected 回答 | 提高相对参考策略的偏好间隔 | 独立偏好评估、正确率及行为回退 |
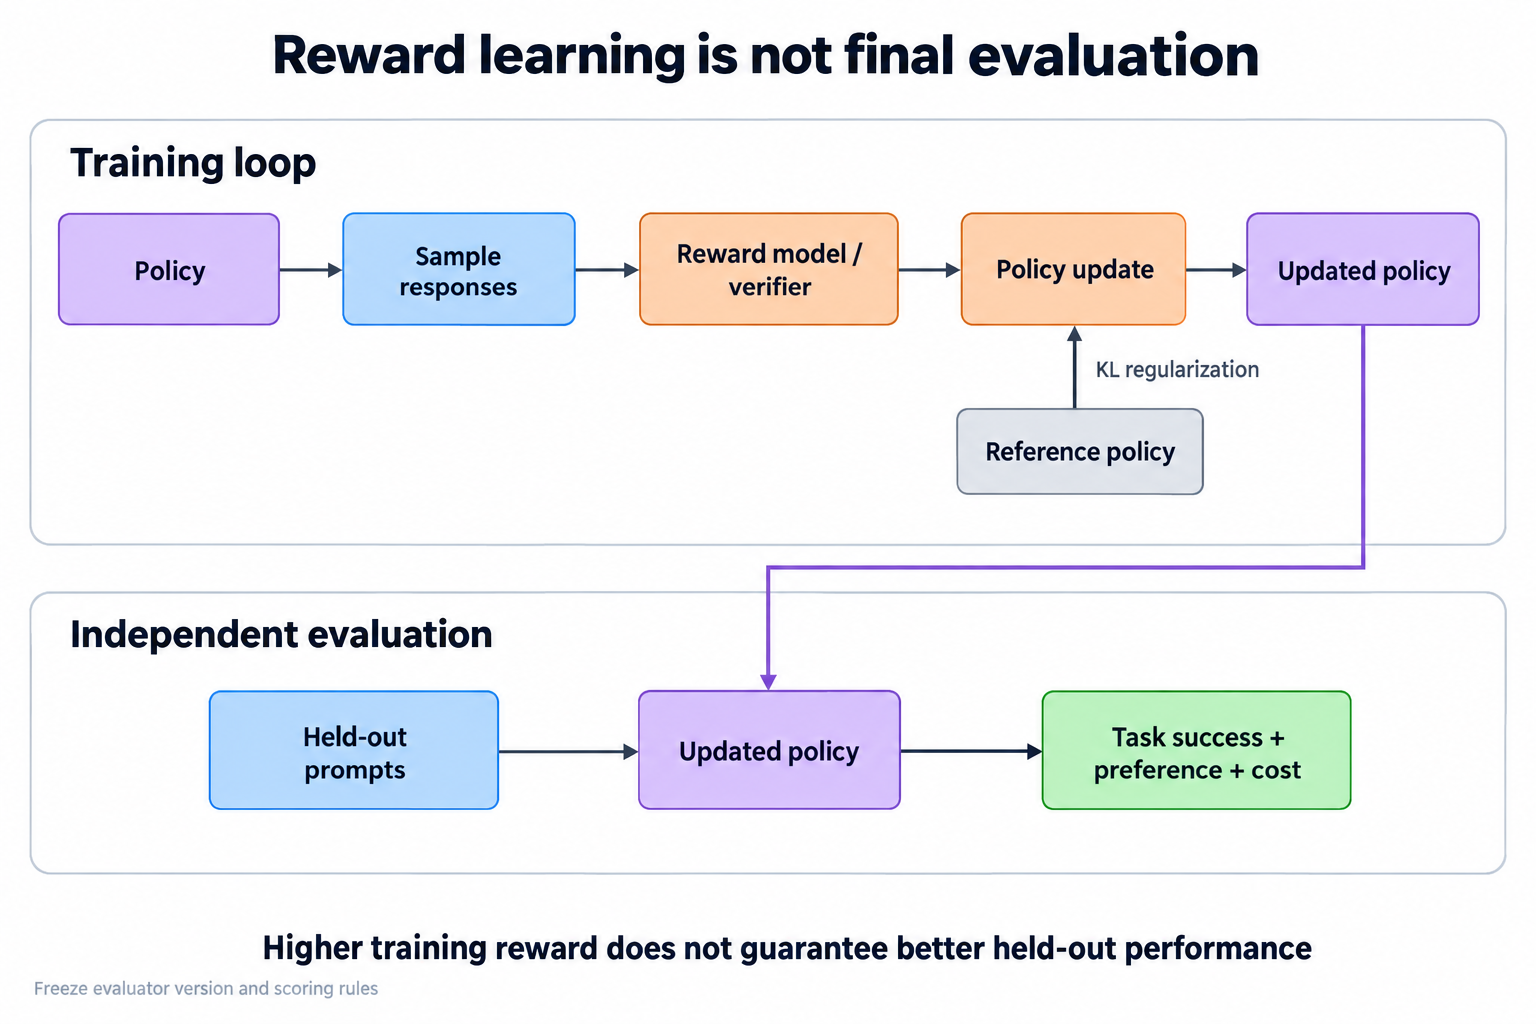
| 强化学习后训练 | 已有策略,在线生成与反馈 | 优化奖励并控制策略更新 | 独立验证的任务成功、稳定性与采样成本 |
SFT 是后训练的一类,后训练不等于 RLHF。使用人工偏好训练奖励模型再优化策略是一种 RLHF 路线;数学答案或程序执行器等可验证反馈常被称为 RLVR。DPO 可以直接利用回答对,不要求显式训练一个独立奖励模型;也不要求先做一遍 PPO。InstructGPT 训练路径、DPO 论文
训练阶段、参数更新方式、数值精度是三个维度。 SFT 可以全参数更新,也可以 LoRA;偏好优化也可以使用 adapter。蒸馏描述监督来自教师的方式,可发生在不同阶段。测试时增加推理 token 或多次采样通常不更新权重,属于推理计算预算变化。
3.1 每个阶段还要记录哪些数据指标
| 阶段 | 数据账目 | 帮助解释的现象 |
|---|---|---|
| 预训练 / CPT | 独立文档、去重后 token、语言与领域占比、重复遍历次数 | 更低 loss 是否来自更容易或重复更多的数据 |
| SFT | 指令数、对话轮次、输入与监督 token、截断比例、任务分布 | 表面样本数相同,实际监督量可能差很多 |
| 偏好数据 | 独立 prompt 数、每题回答对数、平局与歧义比例、长度差 | 回答对数翻倍未必使独立问题翻倍 |
| RL rollout | prompt 数、每题采样数、实际生成 token、奖励可判定比例 | 更新次数相同,采样成本与有效信号仍可能不同 |
数据规模应带上处理阶段:“原始 1T token”“去重后 1T token”“重复训练累计 1T token”是不同账目。评估集应在尽可能独立的来源单位上划分;同一文档改写成多题、同一对话拆成多条时,随机逐条切分容易让训练与测试共享内容。
继续预训练可能增强领域建模,也可能损伤原有能力;后训练可以改善任务能力与行为,并不只改变说话风格。具体收益取决于数据、目标和预算,应在每个阶段保存同协议评估结果,再讨论增加了什么、退化了什么。
3.2 给每个 checkpoint 保留四组结果
| 结果组 | 例子 | 比较时保持一致 |
|---|---|---|
| 固定语料拟合 | 通用/领域 NLL 与 PPL | 同一 tokenizer、窗口与 loss mask |
| 任务能力 | 数学、代码、领域题与指令遵循 | 同一题集、模板协议、解析和生成预算 |
| 行为与回归 | 偏好、错误拒答、长度、截断 | 同一对手、裁判与分桶规则 |
| 资源成本 | 训练 token、GPU 小时、推理延迟 | 硬件与计数边界 |
可以为 Base、CPT、SFT、偏好优化后的模型各保留一行。不要把这几行的训练 loss 放进同一列直接排名:语言建模 NLL、SFT 回答 NLL、偏好二分类目标和策略优化目标,监督对象与数值尺度都不同。若要比较能力,必须回到共同的评估任务。
选择 checkpoint 时也应先约定主指标与约束。以语言建模为目标的预训练实验,可以按固定验证语料的 NLL 选择;以助手任务为目标的后训练实验,可以按验证集任务指标选择,同时检查格式、误拒答和成本约束。Response NLL、偏好 margin 等可作为诊断指标,却不自动决定哪个 checkpoint 最适合交付。选定后,再用未参与选择的测试集报告最终结果。
模板协议也要明确。比较同一条微调链上的 checkpoint,可以固定同一种任务表达;跨基础模型与聊天模型时,硬套某个聊天模板可能额外惩罚没有学过该格式的模型。应事先约定使用共同的续写任务格式,或各模型正确的原生模板,并公开差异;不能看到分数后为某个模型临时挑一个更有利的模板。
4. 预训练:loss 和 PPL 到底在衡量什么
4.1 交叉熵要先看监督位置与分母
令 表示该位置是否计入损失,采用自然对数:
给真实后继 token 的概率依次为 0.5、0.25、0.125,平均负对数概率为 1.3863,PPL 为 4。它可理解为对这批目标的不确定程度,不等于“每四个字错一个”。PPL 的比较需要保持 tokenizer、文本预处理、上下文和评估窗口策略一致。PPL 定义与窗口评估
两个 batch 分别有 2 和 8 个有效目标 token,平均 loss 为 1 和 3。整个集合的 loss 应为 ,不是两个均值再平均得到的 2。PPL 应在汇总 NLL 后取指数,不能平均 batch PPL。
框架日志可能先按 step 求均值,再做跨 step 或跨设备归约。离线报告应核对实际实现,最好同时保留损失总和与目标计数,而不是仅凭字段名假定它已经是全局 token 加权结果。
这里的“有效目标”已经排除了 causal shift 后不可预测的位置和 loss mask 为零的位置。序列长度 100 不保证恰有 100 个训练目标。分布式评估应聚合 NLL 总和与有效目标数,并防止 sampler 为补齐而重复计入样本。
一个长度为 4、步幅为 2 的窗口算例,原文 token 为 x0 … x7:
| 输入窗口 | 本窗口计入损失的目标 | 只提供上下文、不再重复计分 |
|---|---|---|
x0 x1 x2 x3 | x1 x2 x3 | x0 没有本窗口内的前文 |
x2 x3 x4 x5 | x4 x5 | x2 x3 |
x4 x5 x6 x7 | x6 x7 | x4 x5 |
总共统计 7 个目标,重叠 token 不能再次进入分母。步幅为 2 的实现并非每个目标都获得最长可能前文;更小步幅会改变上下文覆盖和评估成本。若改成互不重叠的两块、又不给每块补额外前文,第二块开头的 x4 还可能不被监督。因此要同时保存上下文长度、stride、边界处理和最终有效目标数,避免把“评估方式变了”误读成“模型变好了”。
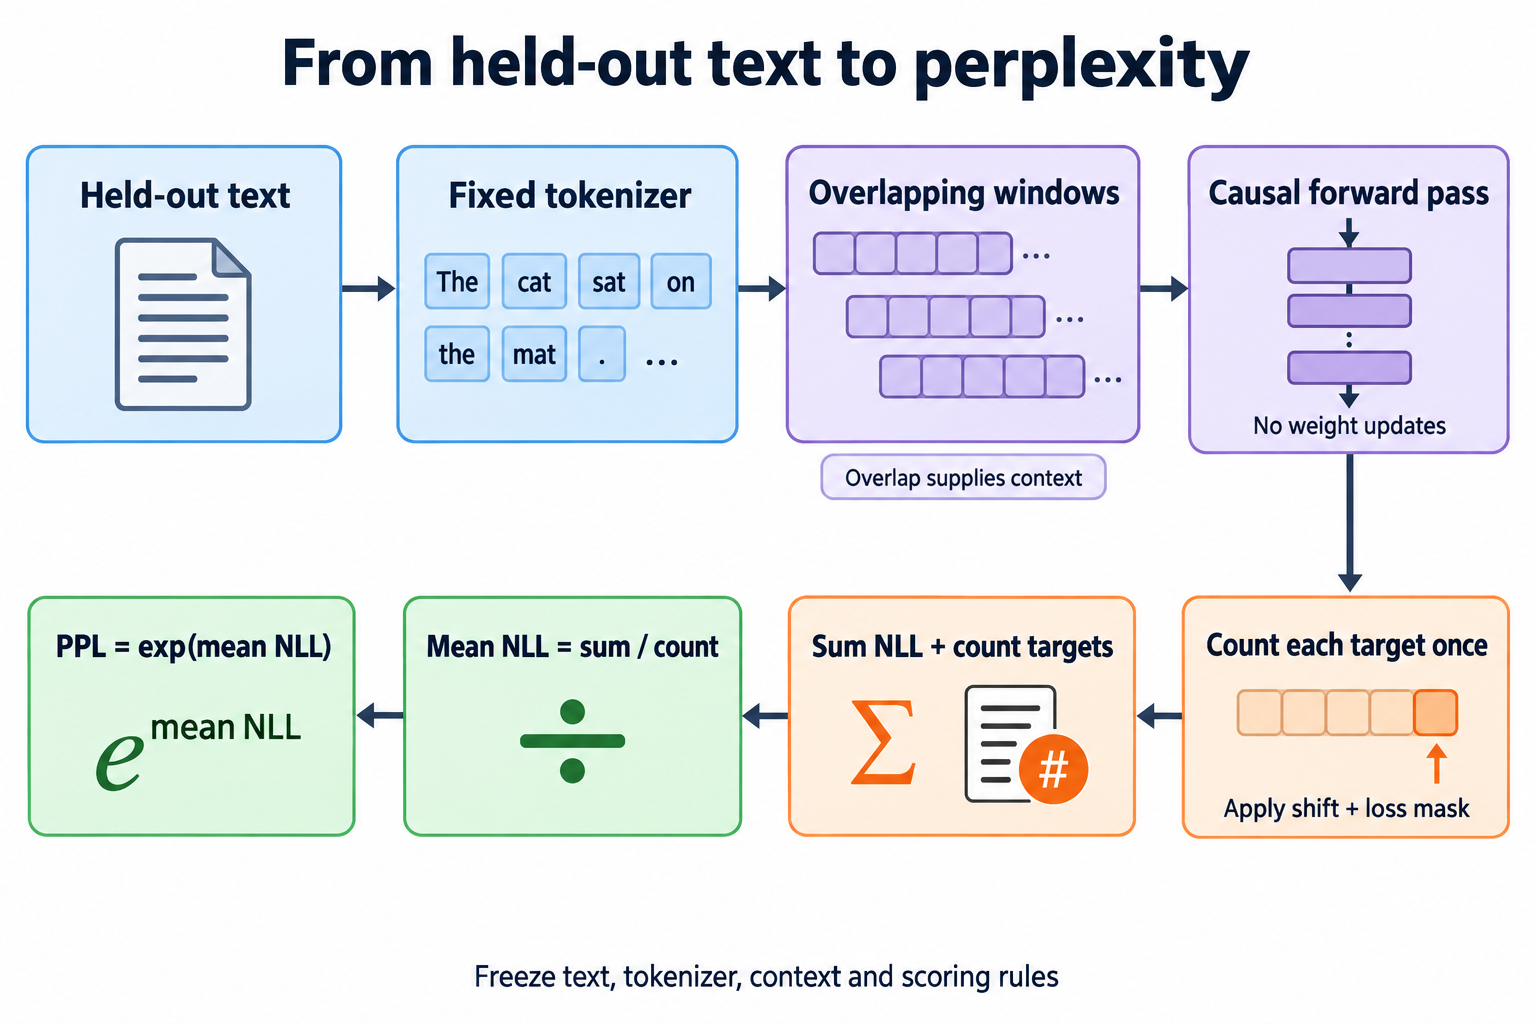
实际实现可以逐窗口累计,不必保存整份语料的 logits。跨 batch 或跨设备汇总时,保留同一对统计量:nll_sum 与 target_count。其中 target_count 应直接来自移位后的有效标签;当一个窗口开头的标签原本就已被屏蔽时,不能再机械地从有效标签数减去一个位置。
4.2 预训练监控表
| 指标 | 定义或分母 | 正常用途 | 常见误读 |
|---|---|---|---|
| Train loss | 训练目标 token 的平均损失 | 检查优化进展与异常跳变 | 与不同数据、mask 的 loss 直接比较 |
| Validation loss / PPL | 固定未参与更新的语料 | 观察泛化和选择 checkpoint | 只报告总均值,掩盖领域退化 |
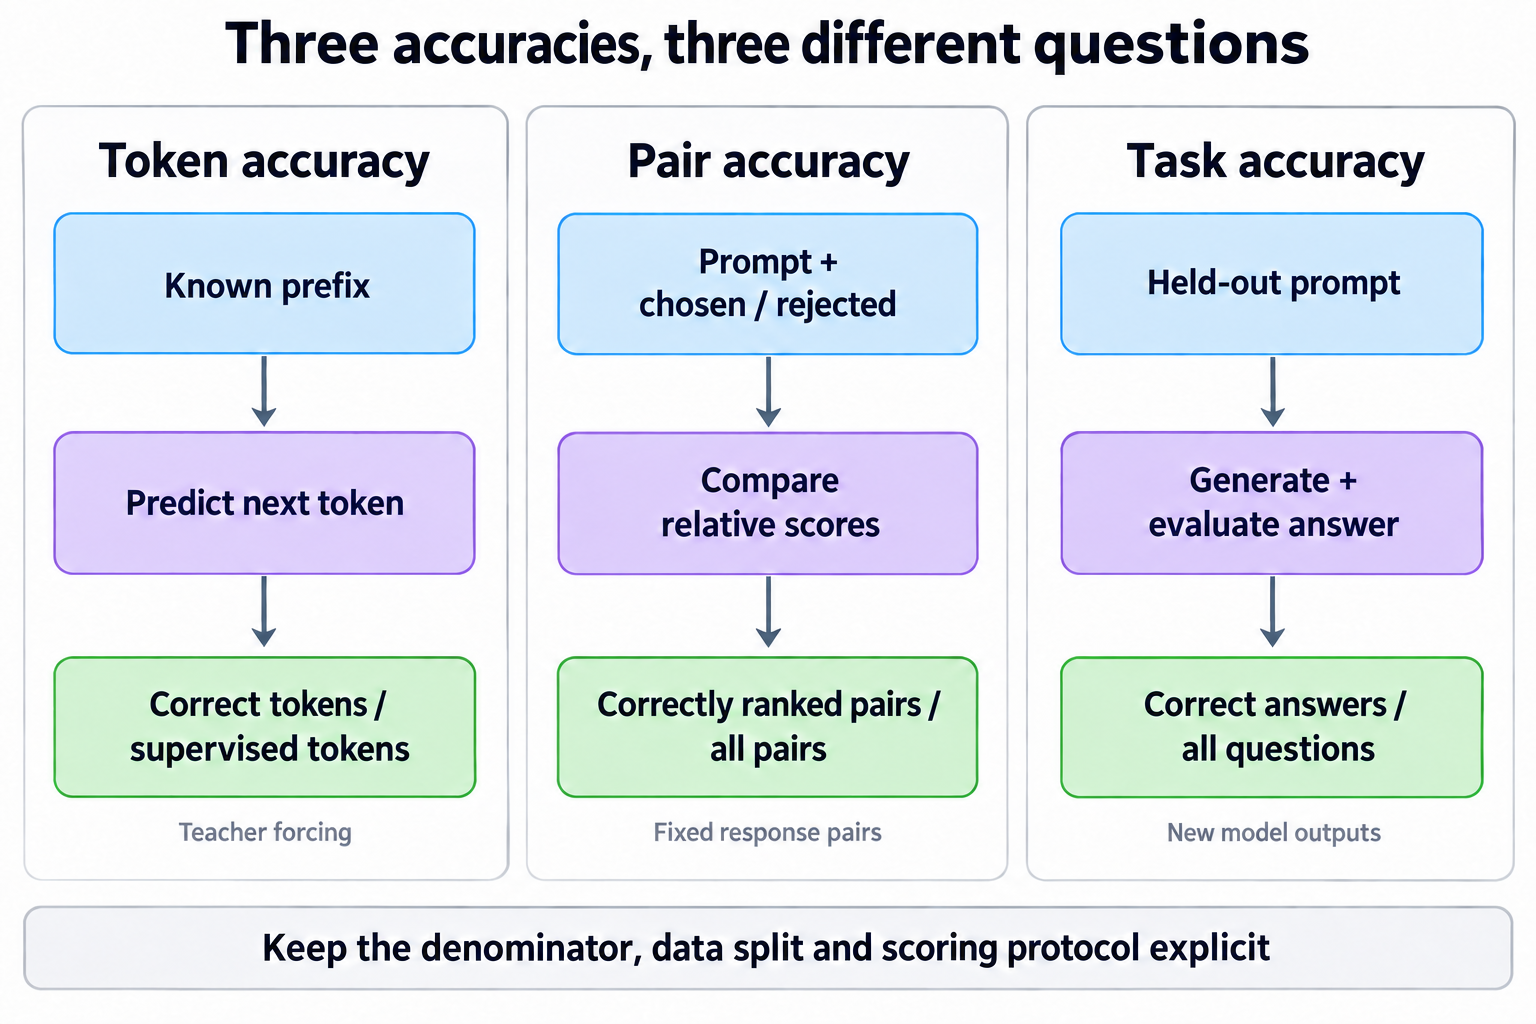
| Token accuracy | teacher forcing 下 argmax 命中目标的比例 | 辅助看预测变化 | 当作整段回答或推理题正确率 |
| Gradient norm | 梯度范数,需注明裁剪前后 | 发现梯度爆炸、异常 batch | 把“越小越好”当作目标 |
| Learning rate | 当前优化步使用的步长 | 对齐 warmup、衰减与 loss | 比较相同步数却不同 token 预算 |
| Tokens/s | 指定 token 计数除以墙钟时间 | 比较训练效率 | 混淆含 padding、有效 token、单卡与集群 |
| MFU | 有用模型计算吞吐/硬件理论峰值 | 衡量端到端计算效率 | 当作 GPU busy 百分比 |
| Peak memory | 测量窗口内峰值显存 | 判断容量与资源回归 | 把 allocated、reserved、驱动占用混为一谈 |
MFU 必须说明 FLOPs 估计式、计算精度、设备数、峰值口径和计时范围。重算会消耗硬件 FLOPs,却通常不增加 MFU 分子中的“有用模型 FLOPs”;所以 MFU 与硬件计算利用率不是同一指标。PaLM 的 MFU 定义
4.3 怎样解释曲线变化
- 训练与验证 loss 都下降:支持语言建模目标改善,还要检查目标任务。
- 训练下降、验证上升:先核对数据分布、评估协议及过拟合;单条曲线不能唯一定位原因。
- 总 loss 下降、某种语言 loss 上升:可能是数据混合改变或局部能力退化,应按语言、领域分桶。
- loss 突然跳升或 NaN:保存对应 batch、长度、学习率和裁剪前梯度,检查数据与数值问题。
- 吞吐提高但 loss 变差:检查是否改变了有效 batch、样本顺序、精度、截断或监督分母。
跨 tokenizer 比较时,按相同原始文本统计 bits-per-byte 等指标可以补充视角,但也要固定编码、文本边界和似然计算协议。不要仅因为两个报告都叫 PPL 就放在同一排行榜里。
还有一种常见情况是 train loss 高于 validation loss。训练时 dropout、数据增强、辅助损失或更难的数据分布,都可能导致这一现象;先把模型模式、损失组成和数据范围对齐,再判断是否异常。尤其是标签平滑、MoE 路由辅助项、正则项或其他附加项:只有相应目标 token 的纯 NLL 才能直接指数化为本文定义的 PPL,不能对任意名为 loss 的总目标取指数。
4.4 准确率更高,NLL 为什么仍可能更差
Accuracy 只判断 argmax 是否命中;NLL 还关心给真实目标分配了多少概率。下面固定四个预测位置,每个位置都只有两个候选 token,列出的概率均属于该位置的真实目标,另一个候选的概率为 。这是人为构造的概率算例,不是模型实测。
| 配置 | 四个位置的真实目标概率 | Token accuracy | 平均 NLL |
|---|---|---|---|
| A | 0.60、0.60、0.60、0.49 | 75% | 0.5615 |
| B | 0.99、0.99、0.99、0.01 | 75% | 1.1588 |
| C | 0.51、0.51、0.51、0.51 | 100% | 0.6733 |
A 与 B 命中相同数量的目标,但 B 在最后一个位置强烈偏向错误答案,产生约 4.6052 的单位置 NLL,足以抵消前三个位置的改善。C 全部命中,平均 NLL 却高于 A,因为它在每个位置都只略微偏向真实目标。这里利用 判断命中仅适用于本例的二候选设定;真实词表应直接比较 argmax。
因此 loss 与 token accuracy 可以同时改善,也可能出现取舍。排查时应同时看平均 NLL、命中率及高损失样本,而不是把其中一个指标当成另一个的替代品。交叉熵与归约定义
5. SFT:示范学得好,不代表自由生成一定正确
5.1 Prompt mask 与 response mask
设一条对话为“用户:解释二分查找。助手:……”。一种常见设置是保留系统、用户和助手文本作为输入,仍按因果 attention mask 限制可见前文,而 loss 只监督指定的助手目标;padding 另行屏蔽。多轮对话还要约定监督所有助手轮次,还是仅最后一轮,以及 EOS、工具返回、系统消息是否计入 loss。
这会直接改变指标。假设移位后有 100 个有效 prompt 目标 token,平均 NLL 为 0.2;另有 20 个有效 response 目标 token,平均 NLL 为 2.0:全序列平均是 0.5,而 response-only loss 是 2.0。数值差异来自分母与监督位置,不能说明前者训练更好。
训练采用 teacher forcing:每一步看到的是数据中的前文。自由生成时,后续 token 的上下文包含模型自己的输出。因此 token accuracy 高也可能在一次早期错误后偏离任务;还可能只是准确预测了大量模板词。
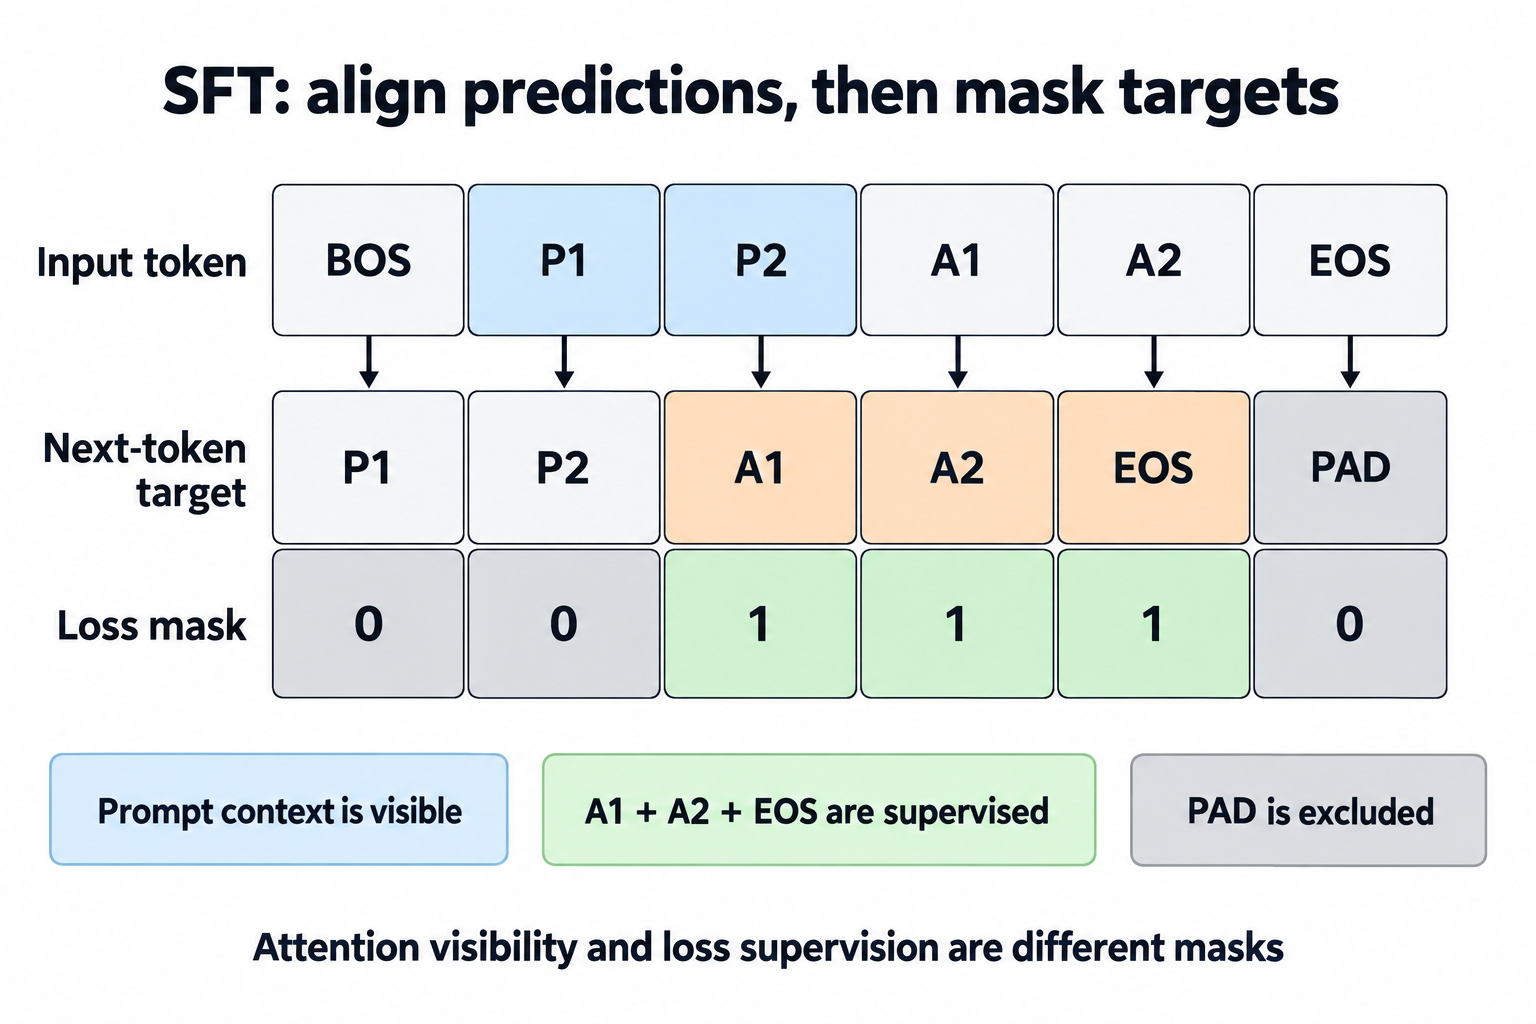
P2 位置的输出预测第一个回答 token A1,因此它的预测要计入 response loss;这不表示把 P2 当成回答标签。实现时可先构造与输入同长度的 labels,把非目标标签设为 -100,再由模型内部执行 causal shift;若训练器已经移位,外部不要再移一次。真实 EOS 与 padding 恰好使用同一 token ID 时,应依据位置与 mask 区分,不能按 ID 一刀切地删除。
当日志同时给出 num_tokens、mean_token_accuracy 和 loss,也不意味着三者共用一个分母。以 TRL v0.24.0 为例,accuracy 和 entropy 针对未屏蔽的目标,num_tokens 描述处理量;跨配置比较应显式记录实际监督 token 数。SFT 日志与 masking
5.2 SFT 应成组报告的指标
| 层面 | 指标 | 解释与限制 |
|---|---|---|
| 监督拟合 | Response NLL、有效目标 token 数 | 固定 chat template、mask 和截断方式 |
| 指令遵循 | 每条约束通过率、整条 prompt 全部约束通过率 | 两个分母不同;必须说明 strict / loose 规则 |
| 任务能力 | 答案正确率、代码测试通过、工具任务成功 | 依据任务定义,不以文本流畅替代正确 |
| 输出行为 | JSON 可解析率、长度、EOS 正常结束率、截断率 | 可解析不等于字段语义正确;短也不一定好 |
| 回归检查 | 通用能力、领域能力、正常请求误拒答 | 与同底座、同协议的基线比较 |
例如 100 条 prompt 每条各有 3 条约束,模型通过 270/300 条约束,但仅 75 条 prompt 全部通过:instruction-level 为 90%,prompt-level 为 75%,二者都应保留。IFEval 专门用可程序验证的约束衡量指令遵循,不能把这类结果泛化为全部回答质量。IFEval 论文
5.3 按 token 平均,还是按回答平均
即使监督位置相同,归约方式也会改变长短回答的权重。令第 条回答的有效目标数为 ,这些目标的 NLL 总和为 ,共有 条回答:
复用前面的 2 个与 8 个有效目标算例,但现在它们分别来自一条短回答和一条长回答:两条回答的平均 NLL 为 1、3,按 token 平均得到 2.6,按回答平均得到 2.0。前者给每个目标 token 相同系数,长回答累计占 80% 的目标权重;后者先在每条回答内部平均,两条回答各占 50%。这描述的是损失中的加权系数,不意味着梯度范数也恰好按该比例分配。
两种归约回答不同问题,没有脱离任务的统一优劣。如果用于反向传播,改变归约就是改变训练目标;如果只用于离线汇报,则应明确命名,不能把按回答平均的 NLL 当成第 4 节定义的逐 token PPL 输入。空监督回答应记录并按预先约定处理,不能除以零,也不能擅自把其 loss 当零。
进一步地,梯度累积或多卡训练中,每个 micro-batch 的有效目标数可能不同。“各自求均值再平均”不自动等价于完整更新批次的 token 平均。实现应核对损失缩放、有效目标计数和分布式归约;评估端再聚合正确,也无法补救训练时已经改变的样本权重。
6. DPO 与 RL:内部指标和外部能力分开
6.1 DPO loss、reward margin 与偏好准确率
对同一 prompt 的偏好回答 与拒绝回答 ,标准 DPO 定义:
这里序列概率由回答 token 的条件概率构成;不同 loss 变体、长度归一化和 mask 会改变口径。 是相对参考模型的隐式分数,不是直接观测到的人类满意度。
标准口径下,rewards/margins 是平均 ;rewards/accuracies 是 的回答对比例。比如四对 margin 为 0.2、−0.1、0.4、0,严格大于零的准确率是 50%,平均 margin 为 0.125。更换 会改变 margin 数值尺度;严格为零如何计数也应遵守实现定义。TRL v0.19.0 指标说明
当策略与参考策略完全相同、计算模式也一致时,所有隐式 margin 为零;按严格大于零的口径,初始 pair accuracy 甚至可能是 0%。这不表示模型不会回答任何问题。不同 还会改变训练目标,不能仅凭更大的 margin 判断哪种配置更好。
chosen 与 rejected 的分数可以同时下降,只要差值改善,DPO loss 仍可能下降。训练对的偏好准确率上升,只能说明该目标更符合给定偏好标签;是否让新回答更好,需要 held-out 生成评估。还要检查偏好标签是否把“更长”“更多套话”误当作“更正确”。
例如 ,参考策略对 chosen/rejected 的序列 log-probability 分别为 −10、−12。初始策略等于参考策略时,两个隐式 reward 都为零,单对 DPO loss 为 。若更新后两项变为 −11、−15,则隐式 reward 为 −0.1、−0.3,margin 为 0.2,loss 降到约 0.5981。chosen 的绝对概率在下降,但偏好间隔在改善。 这是一对样本的算例,不代表 DPO 必然降低 chosen 概率。
6.2 RL 后训练的监控面板
| 指标 | 在检查什么 | 必须一起看的量 |
|---|---|---|
| 原始任务 reward | 优化目标的得分 | 各奖励分量、独立正确率、奖励器版本 |
| 加入 KL 等项后的总 reward(若实现提供) | 奖励与惩罚合成的信号 | 原始 reward、惩罚项及实际公式 |
| KL to reference | 策略相对参考分布的变化 | 方向、估计方式、token/sequence 归约 |
| Approx KL to old policy | 一轮更新离采样策略多远 | 不要与 reference KL 混为一谈 |
| Entropy | 输出分布的随机性 | 正确率、重复率和采样 temperature |
| Clip fraction | 更新有多少进入裁剪区域 | 具体算法条件、学习率和重要性比 |
| Completion length / 截断率 | 生成长度与预算限制 | 成功率、成本、正常 EOS 结束比例 |
| Reward std / 零方差组比例 | 同题样本是否有奖励差异 | 组大小、全对/全错的比例 |
| Rollout tokens/s 与训练 tokens/s | 采样及更新各自的瓶颈 | 奖励器、reference、通信与总墙钟时间 |
KL 惩罚可能从 reward 中扣除,也可能作为独立项加入 loss,不能假定所有日志里的 reward 都已经包含它。例如 TRL v0.24.0 的 PPO 区分原始 score、非 score 奖励项和 RLHF reward;同版 GRPO 将 KL 项写入目标,且默认 beta=0 时不启用该项。比较日志前,应先确认算法、配置和字段公式。PPO 指标口径、GRPO 目标与默认配置
GRPO 的组内奖励全相同时,基于组内差异的任务优势通常为零;但这可能是全对,也可能是全错,或奖励器过于粗糙,并不证明输出文本没有多样性。KL 等其他项仍可能带来梯度。TRL 不同版本对 reward 标准差、裁剪和长度有具体定义,本文字段例子参考 TRL v0.24.0 GRPO 文档,实际记录应绑定所用版本。
奖励上涨、外部正确率不涨时,优先检查奖励漏洞、训练题记忆、答案提取、输出长度和评估分布。格式奖励高不代表内容正确,代码通过不充分的训练测试也不代表通过隐藏测试。PPO、DPO、GRPO 的目标推导与数值实验见算法详解。
6.3 训练奖励模型时,又有一套不同的 loss
显式奖励模型 通常给一个回答输出标量分数;基于成对偏好的常见目标是 。它与 DPO 的数学外形相似,但这里更新的是奖励模型参数,DPO 更新的是生成策略;二者不能仅凭日志都叫 reward 就混同。Reward Trainer
在同一 prompt 下,两个回答分数都加 100,差值及偏好概率不变。因此“平均 reward 从 1 变为 101”本身没有能力含义;不同奖励模型的原始分数通常也不在同一标尺上。应固定奖励器并报告 held-out pair accuracy、margin 分布、分领域错误,以及它是否更偏爱更长的回答。
RL 训练中的评分器与最终验收可以使用不同实现或额外隐藏测试,但也要验证它们的评分质量。独立只是减少训练目标被直接利用的机会,不会自动保证裁判正确。
7. 能力评估:指标必须附带协议
7.1 常见指标速查
| 指标 | 计算对象 | 使用时的边界 |
|---|---|---|
| Accuracy | 正确题数/题数 | 多选、生成后提取、概率打分是不同协议 |
| Exact Match,EM | 规范化后答案是否完全一致 | 规范化规则、单位、等价表达会影响结果 |
| Token F1 | 预测与参考答案 token 的重合程度 | 是答案匹配 token,不是模型 next-token accuracy |
| ROUGE / BLEU | 与参考文本的词片段重合 | 可辅助看摘要/翻译,不能证明事实正确 |
| pass@k | 同题 次采样至少一次通过 | 不代表知道如何从中挑出正确答案 |
| 偏好胜率 | 对同题两份输出的比较 | 依赖对手、裁判、顺序、平局规则和长度 |
| 校准指标 | 预测置信度与经验正确率的匹配 | 要定义置信度;口头“90% 确信”不等于可靠概率 |
| 鲁棒性/分组结果 | 改写、领域、语言、长度等分桶表现 | 平均分不能覆盖所有子群 |
选择题通过候选续写似然选答案,与让聊天模型生成“A/B/C/D”再提取答案不同。还可能存在按长度归一化的打分版本,记录评估器的任务配置和 revision,比只写一个 benchmark 名更有意义。LM Evaluation Harness 任务协议
7.2 pass@1 与 pass@k
若每题独立采样 个候选,其中 个通过相同测试,在 时,常用估计量为:
当 时,分子按零处理。先对每题计算,再对题目求平均;这依赖固定的采样和测试协议。HumanEval 论文、估计器源码
例如 ,pass@1 为 20%,pass@3 为 。提升来自允许尝试更多次,不能写成单次回答正确率达到 53.33%。若实际系统没有可靠验证器,还需要评估候选选择器;多数投票、best-of-N 与 pass@k 是不同协议。
若真实单次成功概率 已知,独立尝试 次的成功概率是 。但把有限样本的 直接代入,并不等于上面的组合数估计器;本例直接代入会得到 48.8%,与 53.33% 不同。论文报告应注明使用的估计方法,不能把两种计算混写。
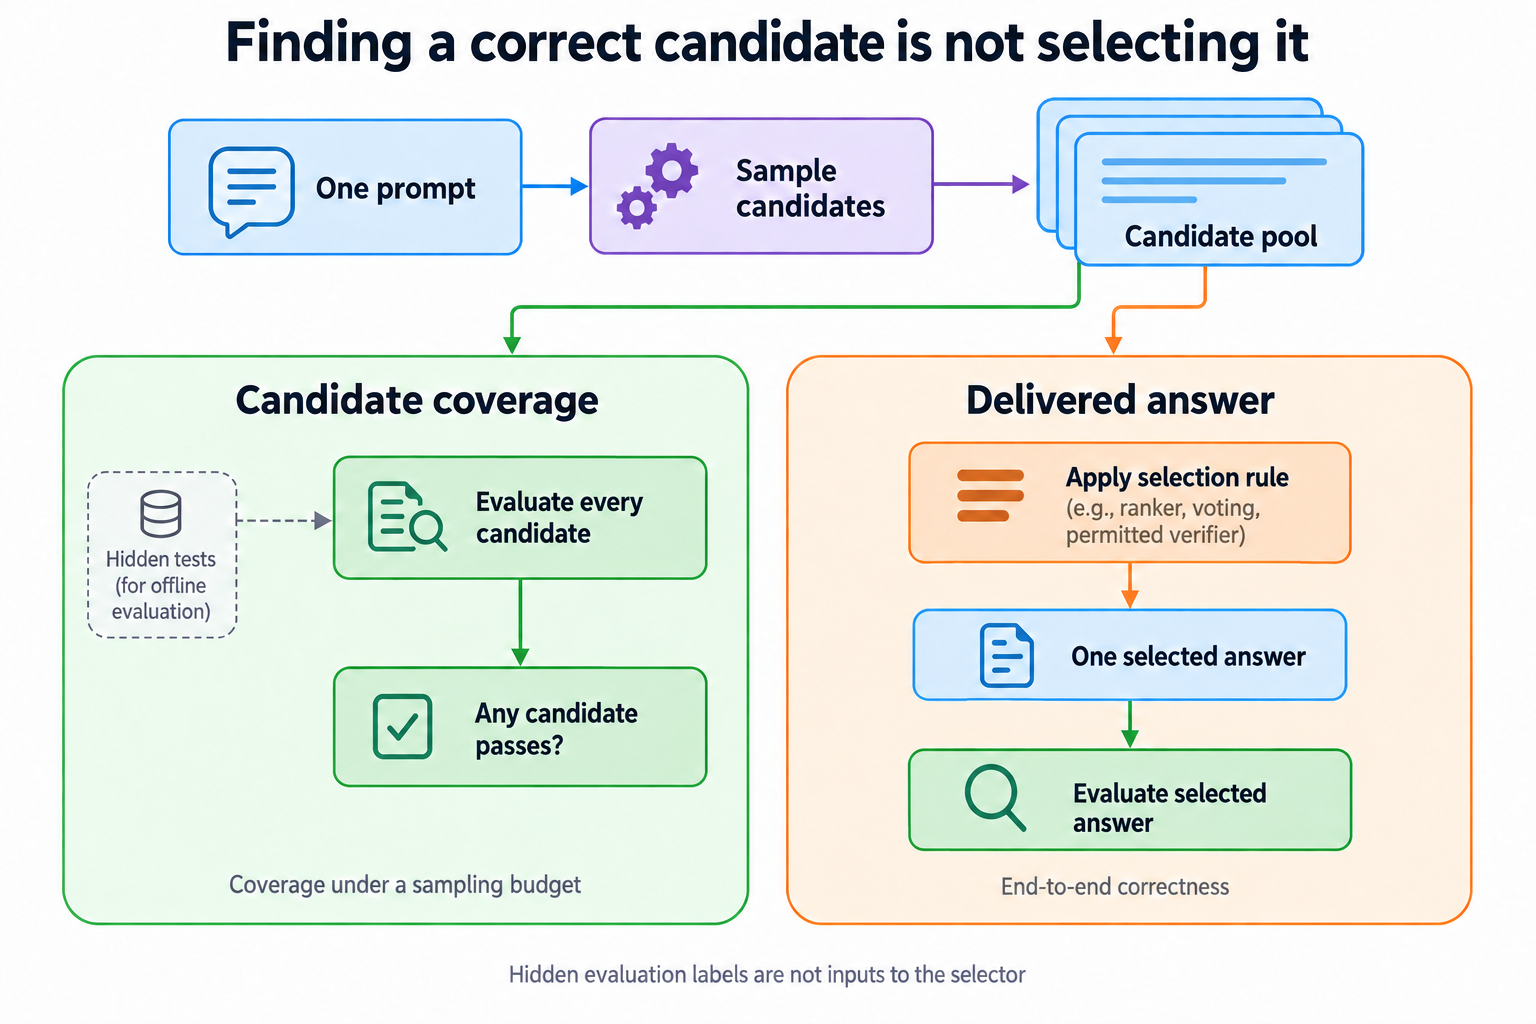
例如某一道题采样得到 A、B、C 三个答案,只有 B 通过隐藏测试,但排序器选择了 A:这次候选池“至少一个通过”为真,最终交付却错误。这是一道题的一次采样结果,不能直接当成整个题集的 pass@3。报告中可以并列记录候选覆盖率、最终答案正确率,以及生成与选择各自的耗时;若选择器会调用工具、再采样或修改答案,这些新增计算也应计入预算。
比较推理模型时,应同时报告 temperature、top-p、最大生成长度、实际生成 token、尝试次数和选择规则。更长思考可能改善结果,也可能只是增加成本;应画出或列出质量—推理预算对照。
7.3 偏好胜率的分母与裁判偏差
本文示例采用平局各计半分:
100 对结果中胜 48、负 32、平 20,得分是 58%;若报告“去掉平局后的胜率”,则为 60%。必须写明口径,不能把两者混用。
固定对手与裁判版本,随机或交换展示顺序,隐藏模型名称,保留逐题理由并抽样人工复核。长度控制可以减轻裁判偏爱长回答的影响,但无法消除全部偏差。AlpacaEval 的长度控制评估
7.4 安全、拒答与事实性也要拆分
有害请求的拒绝率与正常请求的误拒答率应分开报告,分母分别是两类请求。事实性可以按可核查断言计算支持率,但还要检查回答覆盖了多少必要信息,否则少说话可能显得“更准确”。对引用型问答,引用格式合法、来源存在和来源支持断言是三个检查层次。
多指标评估的目的在于暴露取舍。例如任务正确率升高、长尾语言能力下降、延迟翻倍,不能用一个平均总分概括为全面提升。HELM 多维评估框架
7.5 F1、宏平均与微平均
在抽取式答案匹配中,若预测与参考按约定分词后有 个重合 token,预测长度为 、参考长度为 ,则 precision 为 ,recall 为 ,F1 为两者的调和平均 。重合通常要考虑重复次数;空答案、大小写和标点处理必须遵循评估器规则。
一个不依赖具体分词器的算例是:预测列表 [甲, 乙, 丙],参考列表 [甲, 乙]。Precision 为 2/3,recall 为 1,F1 为 0.8;但 Exact Match 仍为 0。不同表达可以具有同样含义却词面不重合,因此它不能替代语义核查。
聚合也会改变结论。任务 A 有 10 题,答对 9 题;任务 B 有 90 题,答对 45 题。逐题等权的微平均为 54%,两个任务等权的宏平均为 70%。任何“综合分”都应写明权重;把不同量纲的 PPL、胜率和延迟直接相加没有清晰解释。
7.6 校准:模型有多确信,和它有多正确
对固定选择题协议,可由候选分数归一化得到预测类别的置信度,再与其是否正确比较。一种常见指标 ECE 将置信度分桶:
为第 桶题目,桶内平均正确率与平均置信度越接近,该桶的差值越小。但分桶数量和边界会影响结果;校准良好也不等于准确率高。应同时报告准确率与可靠性分桶结果。校准与 ECE
对于明确定义的二元事件,也可用 Brier score:,其中 为 0 或 1, 是该事件的预测概率。它同时受校准和预测区分能力影响,多分类版本还需说明求和/归一化约定。自由生成回答若没有清楚定义事件概率,不应直接把平均 token 概率当作“整段内容为真的概率”。
一个独立的二元事件算例:10 次预测都给事件发生概率 0.8,实际发生 8 次。按事件概率分桶的 ECE 为 0,Brier 为 0.16;若全都改报概率 1,阈值 0.5 下的分类准确率仍为 80%,但 ECE 变为 0.2、Brier 变为 0.2。前者只是在这份小样本中恰好匹配频率,不能说明所有概率区间或新样本都校准良好。脚本使用的是这种事件概率校准;上面的选择题 ECE 则使用预测类别的置信度,两种口径需要区分。
7.7 Benchmark 名称与指标名称不要混用
| 评估集示例 | 主要观察方向 | 常见报告方式 |
|---|---|---|
| MMLU | 多学科知识与问题求解 | 选择题准确率、学科分桶,注明 few-shot 与聚合 |
| GSM8K | 数学应用题求解 | 最终答案正确率,注明提取与采样策略 |
| GPQA | 较难的专业领域问答 | 对应子集的选择题准确率与推理预算 |
| HumanEval | 代码功能正确性 | 指定测试条件下的 pass@k |
| IFEval | 可验证的指令约束 | instruction / prompt 与 strict / loose 的组合 |
这些是不同任务的例子,不是完整能力清单。公开题集存在训练污染或反复调参的风险,应结合版本固定、近重复检查、领域留出集和新增私有测试。报告“在什么数据与协议上改善”,比笼统声称“智能提升多少”更准确。
8. 部署指标:回答质量相同,成本仍可能不同
8.1 时延、吞吐与计时边界
| 指标 | 建议定义 | 应固定的条件 |
|---|---|---|
| TTFT | 请求发出到收到第一个输出 token | 是否含排队、网络、输入预处理与 prefill |
| TPOT | 首 token 后,平均每个后续 token 的耗时 | 不含首 token;输出 token 数大于 1 |
| ITL | 相邻输出 token 的时间间隔分布 | 流式缓冲可能影响观测 |
| 端到端延迟 | 请求开始到完成 | 输入/输出长度、超时与失败请求 |
| 吞吐 | 单位时间完成请求或输出 token 数 | 并发、到达率、batch、输入输出计数 |
| P50 / P95 / P99 | 延迟分布的分位数 | 样本量、压测持续时间、预热情况 |
| Goodput | 满足约定质量与时延条件的有效吞吐 | 先定义合格条件,不能只报总吞吐 |
若第一 token 在 0.8 秒到达,100 个 token 在 5.75 秒完成,后续平均 TPOT 为 秒。不能用 代替同一定义下的 TPOT。服务框架的具体字段可能有不同边界,应核对实现。TGI 指标字段
量化后应该复测目标任务、峰值显存、TTFT、TPOT 与吞吐。4-bit 减少存储并不保证在所有设备、内核、batch 下更快;只报告平均延迟也可能掩盖高并发时的长尾。
8.2 答对与按时完成,要在同一请求上检查
服务系统常用满足时延约束的有效吞吐衡量承载能力。例如 DistServe 分别约束 TTFT 与 TPOT;具体 goodput 定义应随论文或压测协议说明,不能只看字段名。DistServe 的时延约束
如果业务还要求答案正确,可以另外定义质量约束下的有效吞吐:在同一请求上同时检查正确性与全部时延门槛,再用合格请求数除以观测秒数。下面两组各有 100 个请求,均在各自 10 秒的完整观测窗口内结束,使用相同任务与时延门槛;数字为构造算例,质量由离线评分确认。
| 计数或指标 | 方案 A | 方案 B |
|---|---|---|
| 请求总数 | 100 | 100 |
| 答案正确 | 80 | 85 |
| 满足时延门槛 | 90 | 70 |
| 同时正确且满足时延门槛 | 78 | 60 |
| 总请求吞吐 | 10 请求/秒 | 10 请求/秒 |
| 质量约束下的有效吞吐 | 7.8 请求/秒 | 6.0 请求/秒 |
B 的答案正确率更高,但在这组时延门槛下,合格交付量更少。这并不说明 B 在所有业务中更差;若允许更长等待时间,应按新门槛重新比较。离线评分的耗时不计入本例的服务延迟;若评分器本身属于在线交付流程,其耗时也必须计入。
两个边际比例不能直接相乘。 A 的正确率为 80%、按时率为 90%,但同时满足的比例是 78%,不是 。正确性与耗时未必独立,应保存逐请求的两项结果后直接统计交集。真实压测还要约定到达率、并发、预热、窗口边界和未完成请求;若 P95 仅统计成功请求,必须同时报告失败与超时率,不能把它当作全部请求的时延表现。
后训练的收益也应放回这组约束中判断。更长回答、多候选选择和额外验证可能提高正确率,却改变在线成本;训练 GPU 小时则是另一笔投入。报告应分别列出训练成本与每次请求的推理成本,再依据预期调用量讨论取舍,不要将二者未经单位换算就相加。
9. 消融实验:怎样判断改动是否有效
9.1 对比实验、消融和调参分别回答什么
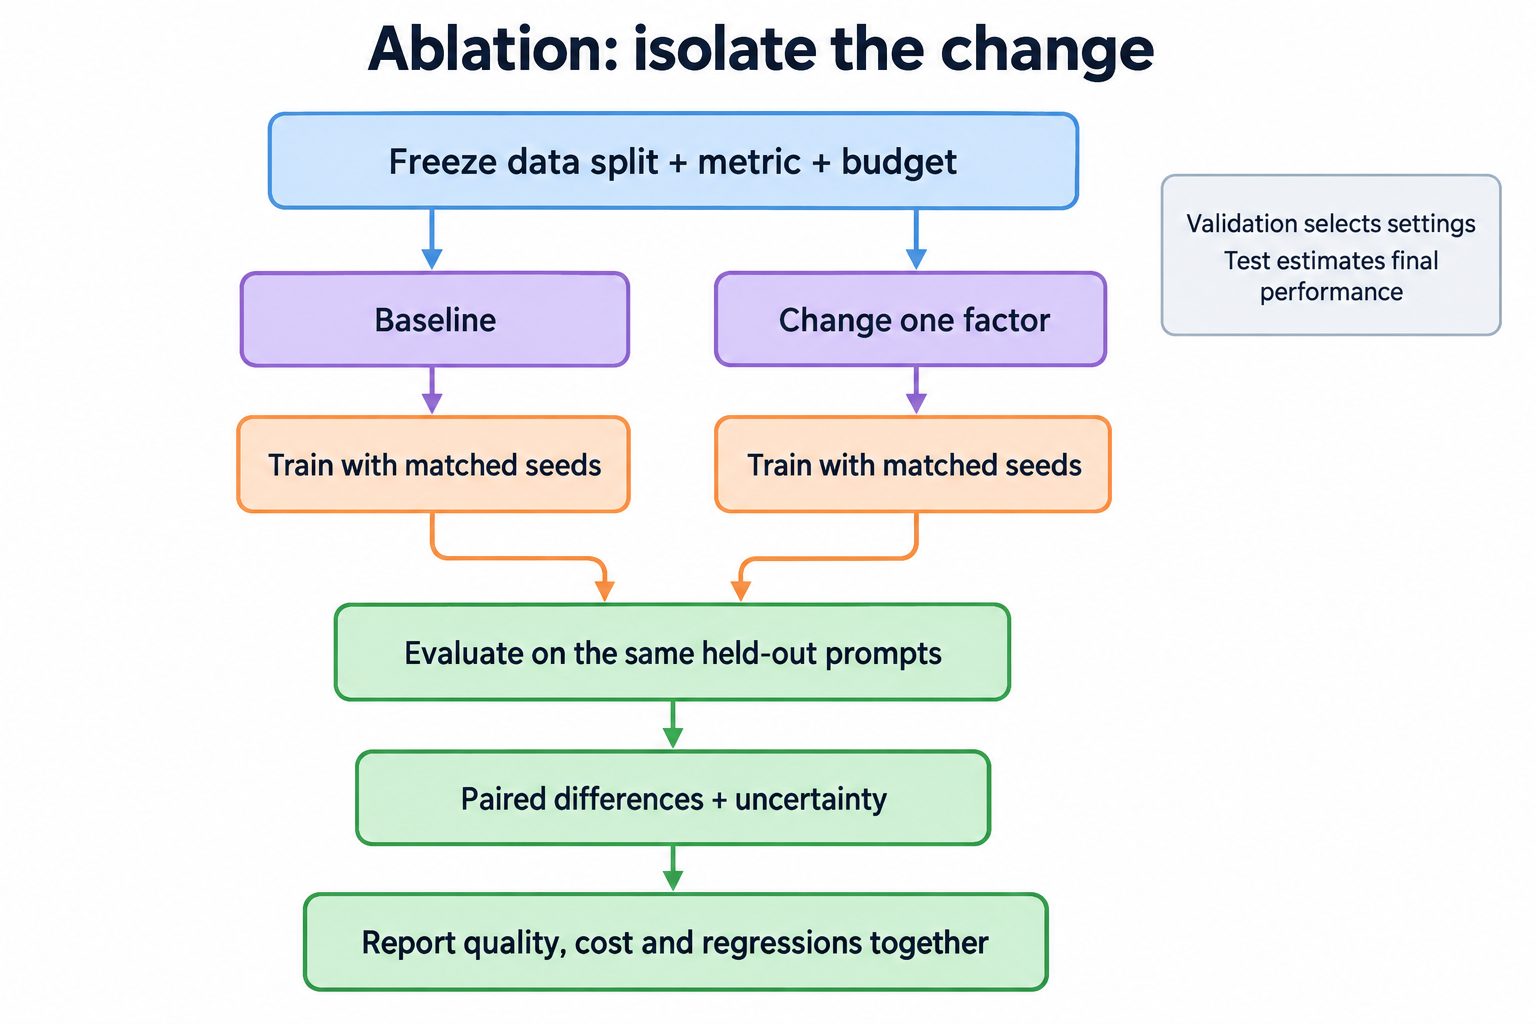
对比实验问“方案 A 与方案 B 谁更适合目标”;消融问“移除或改变某个因素,结果如何变化”;调参问“某方法在给定搜索预算内怎样配置”。将一套精心调参的方法与未经调参的基线比较,无法把收益全归给方法本身。
消融不一定是物理删除网络层。可以改变数据去重、SFT 的 loss mask、偏好标签质量、LoRA rank、奖励分量或 KL 系数。需要事先明确假设,例如“在固定处理 token 预算下,去重能改善新文档上的验证损失”。
9.2 一套具体实验矩阵
假设研究 SFT 数据去重与 response-only loss,四组配置为:
| 组别 | 数据去重 | Response-only loss | 主要用途 |
|---|---|---|---|
| A | 否 | 否 | 共同起点 |
| B | 是 | 否 | 在全序列监督下观察去重 |
| C | 否 | 是 | 在未去重数据上观察 mask |
| D | 是 | 是 | 检查两因素组合与交互 |
所有组使用相同底座 revision、tokenizer、数据来源、源文档级划分、评估 prompt、优化器基本配置,以及预先约定的种子集合。先做跨划分近重复检查,再在训练部分应用待比较的去重策略,避免让“未去重组”因为测试污染占便宜。
等预算要说明等的是什么。 固定处理 token 时,去重后可能重复遍历更少的独立文本;固定 epoch 时,处理 token 会改变。固定 GPU 小时可能导致不同更新次数。研究数据效率可固定 token,研究部署收益可固定时间,但不能声称所有预算都同时相等。
对 mask 消融,监督 token 数本来就是处理因素的一部分;可以固定输入 token,并额外报告监督 token 数。若再强行固定监督 token,则输入计算预算可能不同,回答的是另一个问题。
9.3 百分点、相对提升与不确定性
下面是人为构造的三次训练结果,仅用于演示汇报:
| 配对种子 | 基线准确率 | 新方案准确率 | 配对差值 |
|---|---|---|---|
| 11 | 70% | 73% | +3 个百分点 |
| 22 | 72% | 73% | +1 个百分点 |
| 33 | 71% | 74% | +3 个百分点 |
均值从 71.00% 到 73.33%,差值约 +2.33 个百分点;相对提升约 3.29%。三个配对差值的样本标准差约为 1.15 个百分点。样本标准差描述波动,不等于 95% 置信区间,更不能凭三次结果断言稳定优于所有任务。
先说明“不确定性来自哪里”,再选择重复实验和统计方法:
| 变化来源与控制条件 | 观察方式 |
|---|---|
| 训练过程:固定数据、训练配置与评估协议 | 多个训练种子得到多份 checkpoint |
| 评估题目:固定模型及生成、评分协议 | 对独立题目配对重采样;相关题目按组处理 |
| 随机生成:固定模型、题目与解码参数 | 重新采样回答,保留每题的多次结果 |
在固定两份模型上做题目 bootstrap,不能测量重新训练带来的波动;把三次训练当作仅三道题,也不合理。若关注同一模型重复生成是否稳定,需要实际重跑生成。对已经保存的逐题输出做重采样,不会产生新回答,也不能单独识别生成随机性;同一 prompt 的多次输出仍属于同一个题目组。
训练 seed、生成 seed 与 bootstrap seed 是不同控制项。 本文工具的 --seed 17 只固定重采样索引;把 bootstrap 次数从 1,000 增加到 10,000,有助于减小区间计算自身的 Monte Carlo 波动,但不会增加独立测试题或训练次数。Few-shot 示例的抽取也应单独记录;例如评估工具会区分不同随机数来源与 few-shot seed。评估种子与逐题输出配置
同一测试题上比较两个模型时,应保留逐题结果并对题目做配对重采样:每次取同一组题目索引,计算两模型均值之差。若多个问题来自同一文档或用户,应考虑按组抽样;独立样本假设不满足时,普通逐题区间可能过窄。
9.4 单因素与交互作用
移除一个模块后性能下降,只支持“该模块在此配置中有贡献”。删除模块也许改变了参数量、吞吐和优化难度;若研究机制,应加入参数量或计算预算匹配的对照。逐个移除模块还可能漏掉交互作用,前面的四组设计可进一步检验“一个因素的作用是否依赖另一个因素”。全因子设计
沿用第 9.2 节的 A、B、C、D 配置,假设得到以下构造的任务准确率,仅用于演算:
| 数据设置 | 全序列 loss | Response-only loss |
|---|---|---|
| 不去重 | A:70% | C:71% |
| 去重 | B:72% | D:76% |
全序列监督下,去重对应 个百分点;response-only 监督下,去重对应 个百分点。同一个改动的条件效应并不相同,两者之差为:
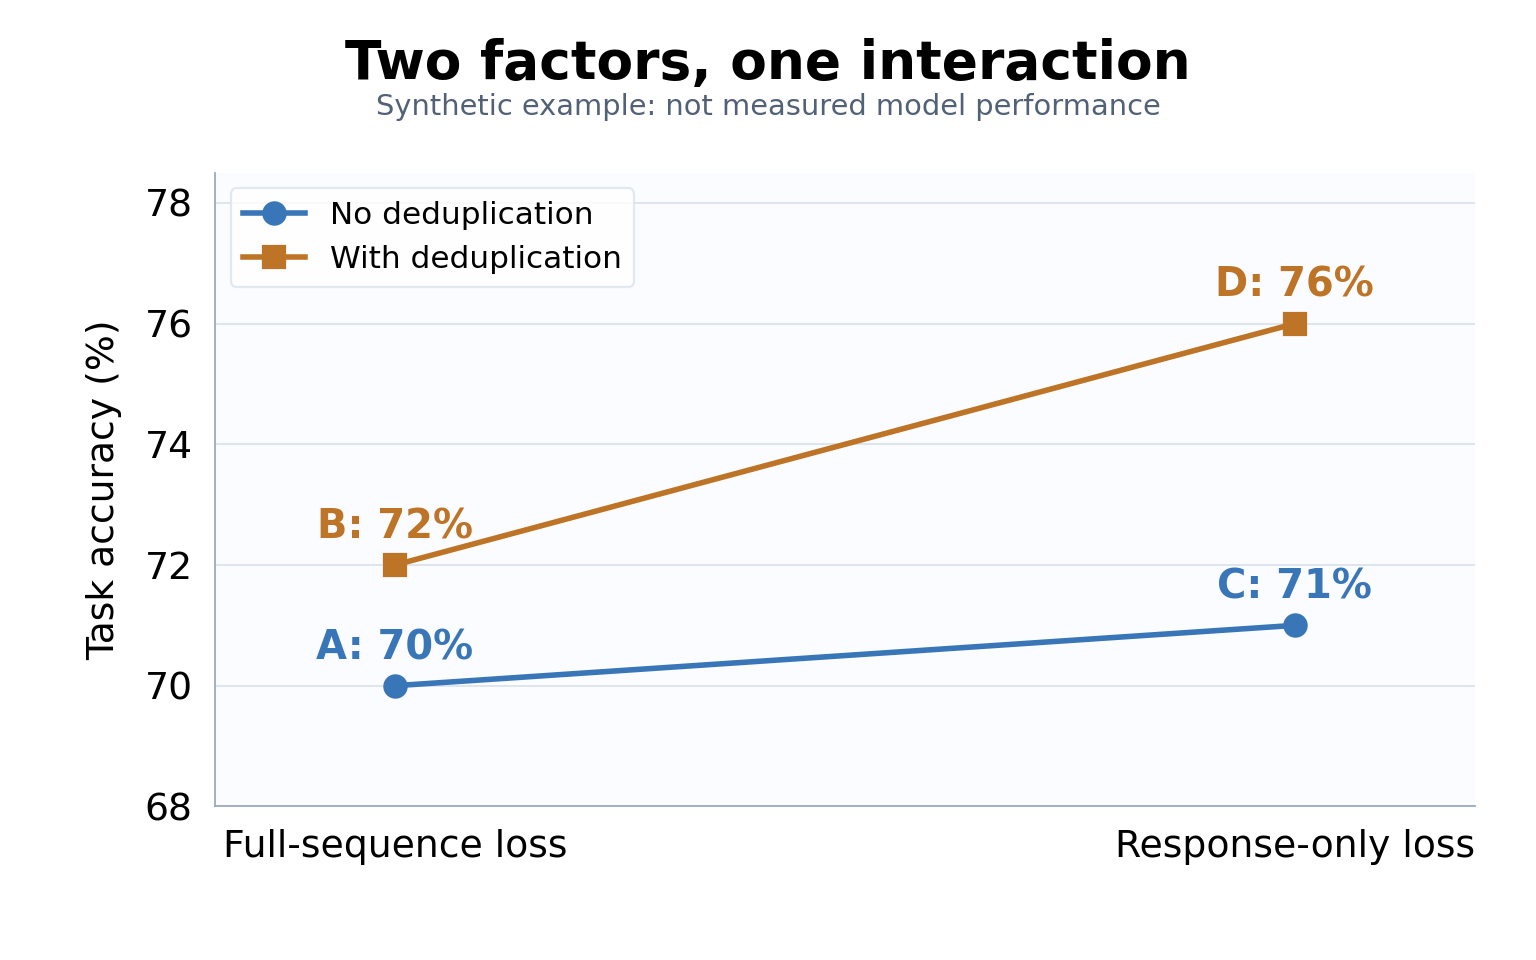
若按准确率的加性关系外推,D 应为 ,本例却是 76%。因此不能把 D 相对 A 的 6 个百分点全部归因于去重,也不能把两个单独改动的收益直接相加预测组合效果。这里的 3 pp 是准确率尺度上的差中之差,不是显著性结论,也不是所有回归编码下同名交互系数的数值。
真实实验应对四组使用约定的训练重复与逐题评估,再为这个交互对比估计不确定性。仅有四个汇总均值,无法判断观察到的非加性来自稳定作用还是随机波动;“没有显著交互”也不等于证明完全没有交互。
验证集可用于选 checkpoint 和超参数,测试集应在方案确定后使用。若根据测试分数连续修改设计,测试集已参与选择,应另留最终测试或如实说明选择过程。多次尝试只展示最佳种子,也会夸大效果。
9.5 同样提升 5 个百分点,也要看改对了哪些题
假设两个固定模型在相同 100 道题上的结果如下,仍是人为构造的算例:
| 新方案正确 | 新方案错误 | 合计 | |
|---|---|---|---|
| 基线正确 | 60 | 10 | 70 |
| 基线错误 | 15 | 15 | 30 |
| 合计 | 75 | 25 | 100 |
差异来自 15 道改对 − 10 道改错,所以准确率从 70% 到 75%。只保存两个总分会丢失这项配对信息。本文脚本对同一组题目索引进行 10,000 次配对重采样,固定随机种子 17,得到百分位区间约 [−5, +15] 个百分点。它包含零,不能据此声称这次实验已经提供明确的提升证据,也不能反过来证明两方案相同。
如果只描述已经做完的这 100 道固定题,70/100 和 75/100 就是这次评估的确定计数。区间服务于“在相同抽样机制下换一批题会怎样”的推断,而不是让已经观察到的总分变得不确定。把固定 benchmark 推广为真实用户分布,仍需要代表性假设。
对这样的独立题目、二元正确性比较,可以进一步用 McNemar 检验,重点看 10 与 15 这两个不一致格;不要把 200 条模型输出当作互不相关的样本。McNemar 检验定义
统计方法还应与实验单位匹配:同一个 prompt 的多个采样不等于多个独立问题,多道题来自同一文档也可能相关。区间算法、单/双侧检验、主指标和多重比较处理要事先约定;统计显著、实际收益和额外成本是三件事。NLP 统计检验指南
9.6 0/100 不代表真实失败概率为零
对独立同分布的二元试验,单个比例可以使用 Wilson 区间。令 , 是对应置信水平的标准正态分位数,其中心和半宽为:
观测 100 次、0 次失败,双侧 95% Wilson 区间约为 [0%, 3.70%],不会因为样本全为零就认定没有不确定性。这个例子统计的是失败率;若改为成功率,方向也要随之改变。Wilson 区间
这类区间描述相同抽样机制下的不确定性,不包括测试污染、评分器错误、分布变化或重新训练带来的变动。对两模型的差值不要直接套单比例公式,也不要把两个区间是否重叠作为配对显著性的唯一判断。普通百分位 bootstrap 在全部观察相同等边界情形可能退化为零宽度,应报告局限而非宣称“结果完全确定”。
平局计半分的偏好胜率、逐题 pass@k 估计值和 F1,也不是简单的二元成功计数;不能把它们的平均值乘样本量后机械地塞进 Wilson 公式。
10. 一份能读懂、能复查的实验报告
10.1 最小记录模板
以下是记录结构,null 表示待测,不能当成零;占位字段需要实际填写。
experiment:
  stage: sft
  hypothesis: "固定输入 token 预算时,去重是否改善独立任务表现"
  model_revision: "填写不可变提交或权重哈希"
  tokenizer_revision: "填写版本与 chat template 哈希"
  trainable_parameters: null
  total_parameters: null
  weight_dtype: bf16
  optimizer_state_dtype: "按实际配置填写"
  data_revision: "填写数据快照与划分哈希"
  split_unit: source_document
  loss_mask: assistant_response
  loss_reduction: global_supervised_token_mean
  budget_unit: processed_input_tokens
  budget: null
  training_seeds: [11, 22, 33]
  checkpoint_selection: "验证集指标与选择规则"
evaluation:
  dataset_revision: "填写测试集版本"
  evaluator_revision: "填写评估代码版本"
  prompt_template: "填写模板哈希"
  decoding: "填写 temperature、top-p、长度及尝试次数"
  generation_seed: null
  fewshot_examples_revision: "固定示例及顺序;零样本时写 not_applicable"
  samples_per_question: 1
  expected_question_ids_hash: "完整题目清单哈希"
  answer_extractor_revision: "答案提取与规范化代码版本"
  primary_metric: task_accuracy
  aggregation: "逐题等权;另报领域分桶"
  failures: "保留超时、解析失败与拒答的计分规则"
serving:
  workload_revision: "请求集、到达过程与硬件配置版本"
  latency_constraints: "分别填写 TTFT、TPOT 或端到端门槛"
  observation_seconds: null
  total_requests: null
  correct_and_on_time_requests: null
  latency_population: "全部请求或成功请求;另报失败与超时"
results:
  mean: null
  training_seed_std: null
  paired_difference: null
  uncertainty_method: "填写抽样单位与区间算法"
  bootstrap_seed: 17
  bootstrap_repeats: 10000
  peak_memory_gib: null
  gpu_hours: null
  inference_tokens: null
记录还应附上软件与硬件版本、训练曲线、实际处理与监督 token、逐题预测、失败样本,以及模型加载所需文件。生成服务若不提供 seed 控制,应明确记录这一限制,不要填写一个未生效的数值。Adapter 实验必须能追溯底座;只给一个 adapter 文件无法完整复现模型。
10.2 结果判读示例
| 观察 | 可以支持的结论 | 还不能支持的结论 |
|---|---|---|
| 相同协议下 PPL 从 12 降到 10 | 该语料的平均 NLL 改善 | 数学、代码、对话都更强 |
| DPO held-out pair accuracy 上升 | 偏好对排序更符合标签 | 自由生成胜率必然提高 |
| pass@8 高于另一模型 pass@1 | 在不同尝试预算下取得更高覆盖 | 单次推理能力更强 |
| 4-bit 权重更小 | 存储载荷下降 | 延迟必然下降、质量不变 |
| 去掉模块后分数下降 | 模块在当前系统有作用 | 唯一原因已被证明,所有配置都必要 |
| 平均分提升,区间很宽 | 当前点估计有改善趋势 | 提升稳定且统计证据充分 |
11. 可运行的指标算例
可以一次下载 完整算例包,解压后进入 llm-metrics-lab 目录。需要 Python 3.8 或更新版本,只使用标准库,不联网,也不加载模型权重。下面也提供各文件的独立下载链接。
11.1 复算公式与模型配置
下载同目录的 metrics_lab.py,然后执行:
python metrics_lab.py它会复算权重体积、KV cache、token 加权 NLL、PPL、准确率与 NLL 的取舍、回答加权方式、pass@k、含平局胜率、SFT mask 差异、DPO margin、TPOT、质量约束下的有效吞吐、种子差值与双因素交互。部分输出如下:
7B BF16: 14.00 GB = 13.04 GiB
KV cache: 512 MiB
Weighted NLL: 2.6000; PPL: 13.4637
Toy probabilities PPL: 4.0000
Toy A: token accuracy=75.00%; NLL=0.5615
Toy B: token accuracy=75.00%; NLL=1.1588
Toy C: token accuracy=100.00%; NLL=0.6733
Token-mean NLL: 2.6000; response-mean NLL: 2.0000
pass@3 (n=10, c=2): 53.33%
Win rate (ties=0.5): 58.00%
Full-sequence NLL: 0.5000; response-only NLL: 2.0000
DPO pair accuracy: 50.00%; mean margin: 0.1250
TPOT: 50.00 ms
Quality goodput A: 7.80 requests/s; joint pass: 78.00%
Quality goodput B: 6.00 requests/s; joint pass: 60.00%
Paired gain: 2.33 pp; sample std: 1.15 pp
Dedup effects: 2.00 / 5.00 pp; interaction contrast: 3.00 pp
脚本也包含固定逐题结果上的配对 bootstrap 演示。那一段的区间只描述该玩具题集的重采样,不代表真实模型效果,也不包含训练种子的变化。
将 qwen2.5-7b-budget.json 放在脚本旁边,还会核对真实配置的参数量与权重载荷;未提供该文件时会明确跳过这一项。Wilson 和校准算例的输出分别为 [0.00%, 3.70%]、ECE=0.0000; Brier=0.1600。
11.2 对齐逐题结果,再做配对评估
将 paired_eval.py 与 metrics_lab.py 放在同一目录,无参数执行可以复现第 9.5 节的 100 题算例:
python -B paired_eval.py对于已有的真实评分结果,准备两个 JSONL 文件,每行表示同一道题在某模型上的结果。correct 必须是布尔值;此脚本不判断答案文本是否正确,评分应先由固定评估器完成。
{"id":"q001","correct":true,"status":"ok"}
{"id":"q002","correct":false,"status":"error"}
其中 status=error 表示这次模型请求或输出处理失败,按本工具的预设协议保留在分母并计为错误;不能填写 correct=true。这是一个明确的端到端评估约定,若研究排除基础设施故障的条件能力,应另定义实验并同时报告故障覆盖率,不要静默过滤。
再提供从测试集确定的完整 ID 清单 ids.json,例如 ["q001", "q002"],执行:
python -B paired_eval.py \
  --baseline baseline.jsonl \
  --candidate candidate.jsonl \
  --ids ids.json \
  --repeats 10000 --seed 17
工具会拒绝重复 ID、两份结果中的缺题/多题、非布尔评分和矛盾状态;按 ID 排序使文件行顺序不影响固定种子的重采样。--seed 和 --repeats 只控制 bootstrap,不控制模型训练或回答生成。它输出逐模型准确率、单比例 Wilson 区间、配对差值区间、四格表与错误数。只支持独立题目的二元评分比较,不覆盖相关题组、多种子联合不确定性、自由文本判分或奖励模型评估。
阅读自测与验收
- 为什么 7B BF16 权重约 14 GB,却不能据此判断训练显存? 训练还包含梯度、优化器状态、激活与临时缓冲。
- PPL 从 10 降到 8 前,必须核对哪些条件? 数据、tokenizer、上下文、mask、窗口策略和归约分母。
- 为什么不能仅凭 SFT loss 0.5 小于 2.0 就判断模型更好? 两者可能监督不同位置,必须先统一口径。
- DPO 偏好准确率是否等于回答正确率? 前者比较给定回答对的相对分数,后者评估新生成回答的任务结果。
- pass@8 可以直接与 pass@1 排名吗? 不能据此比较相同预算下的能力,还需统一采样、验证和选择协议。
- 如何证明数据去重的收益? 固定划分和评估协议,明确预算,构造对照,报告多种子与配对结果。
- 为什么 Qwen2.5-7B 的 BF16 载荷不是恰好 14 GB? 具体配置有 7,615,616,512 个参数,7B 是规模标签。
- 0/100 次失败能证明没有风险吗? 不能;还要考虑抽样区间、分布覆盖与评估误差。
- 脚本计算正确意味着大模型训练已经复现吗? 不意味着;它只验证文中算例和指标计算。
进一步阅读可按问题选择:Transformer 与注意力补充模型结构,分布式训练与显存展开资源管理,PPO、DPO 与 GRPO推导后训练优化目标。正文链接中的版本用于界定指标口径;实际实验应记录自己使用的实现版本。