LeRobot 与 ACT 详解:从机器人示教数据到动作分块、训练与部署
本文目录 展开章节导航
LeRobot 是连接机器人硬件、数据集、学习算法与执行流程的开源工具链;ACT 是可以在这套工具链中训练和运行的一种模仿学习策略。 前者解决实验怎样组织和复用,后者学习“看到当前场景以后,接下来应该怎样运动”。
以“抓起积木并放入盒子”为例:先记录遥操作时的相机、关节状态与控制指令,再训练 ACT 将当前观测映射为未来动作块,最后通过队列或时间集成逐步执行。理解这条链,需要同时看清数据时间对齐、网络输入输出和实际控制周期。
版本范围:源码核对基于 LeRobot 提交 89236ea0f4f81a81ca566081e20dd1ff5f823cbe。默认值和命令针对这个版本,设备与数据集名称需按实际环境替换。算法推导、源码核对与可运行的时序算例见下文;真实机器人训练及成功率尚未在本文复现。
图内英文标签的中文含义见图注和正文;点击图片可放大查看。
阅读路线
| 阅读目标 | 从这里开始 | 接着看什么 |
|---|---|---|
| 理解工具链 | LeRobot、ACT 与 ALOHA → 完整工作流 | 记录与下发、输入输出接口、数据窗口 |
| 理解算法 | 动作分块 → 网络架构 | 训练与推理、时间集成 |
| 运行实验 | 环境与采集 → 数据检查 → 训练配置 | 部署、评估对照 |
| 复用已有模型 | 配置与权重兼容性 | 控制周期、断点恢复 |
| 定位问题 | 排查顺序 | 现象与原因、源码入口 |
不连接机器人也可以运行文中的动作时序小实验,观察队列何时重预测,以及 padding 和时间集成如何改变数值。
1. LeRobot、ACT 与 ALOHA 各是什么
| 名称 | 定位 | 在实验中负责什么 |
|---|---|---|
| LeRobot | Hugging Face 的机器人学习库 | 数据存取、硬件接口、策略实现、训练与执行工具 |
| ACT | Action Chunking with Transformers | 根据观测预测连续的一段动作 |
| ALOHA | 原论文使用的双臂遥操作硬件系统 | 采集双臂示教并执行策略 |
| Behavior Cloning,BC | 行为克隆训练方法 | 用专家动作监督策略输出 |
ACT 是行为克隆的一种具体实现,不要求先设计奖励函数。ALOHA 是它最初验证的硬件背景,但并不是算法的必要条件;输入输出特征匹配以后,也可以在单臂机器人上使用。LeRobot 还包含其他策略,选择 ACT 只是确定了学习算法,没有替你确定相机安装、动作单位与任务成功标准。LeRobot 项目介绍、ACT 原项目
原版 ACT 的主要输入是图像和机器人状态,不是自然语言指令。数据集中保存了任务文字,也不表示 ACT 自动具备“听懂一句新指令”的能力。语言条件需要相应的模型结构和训练数据。
2. LeRobot 如何把整个实验串起来
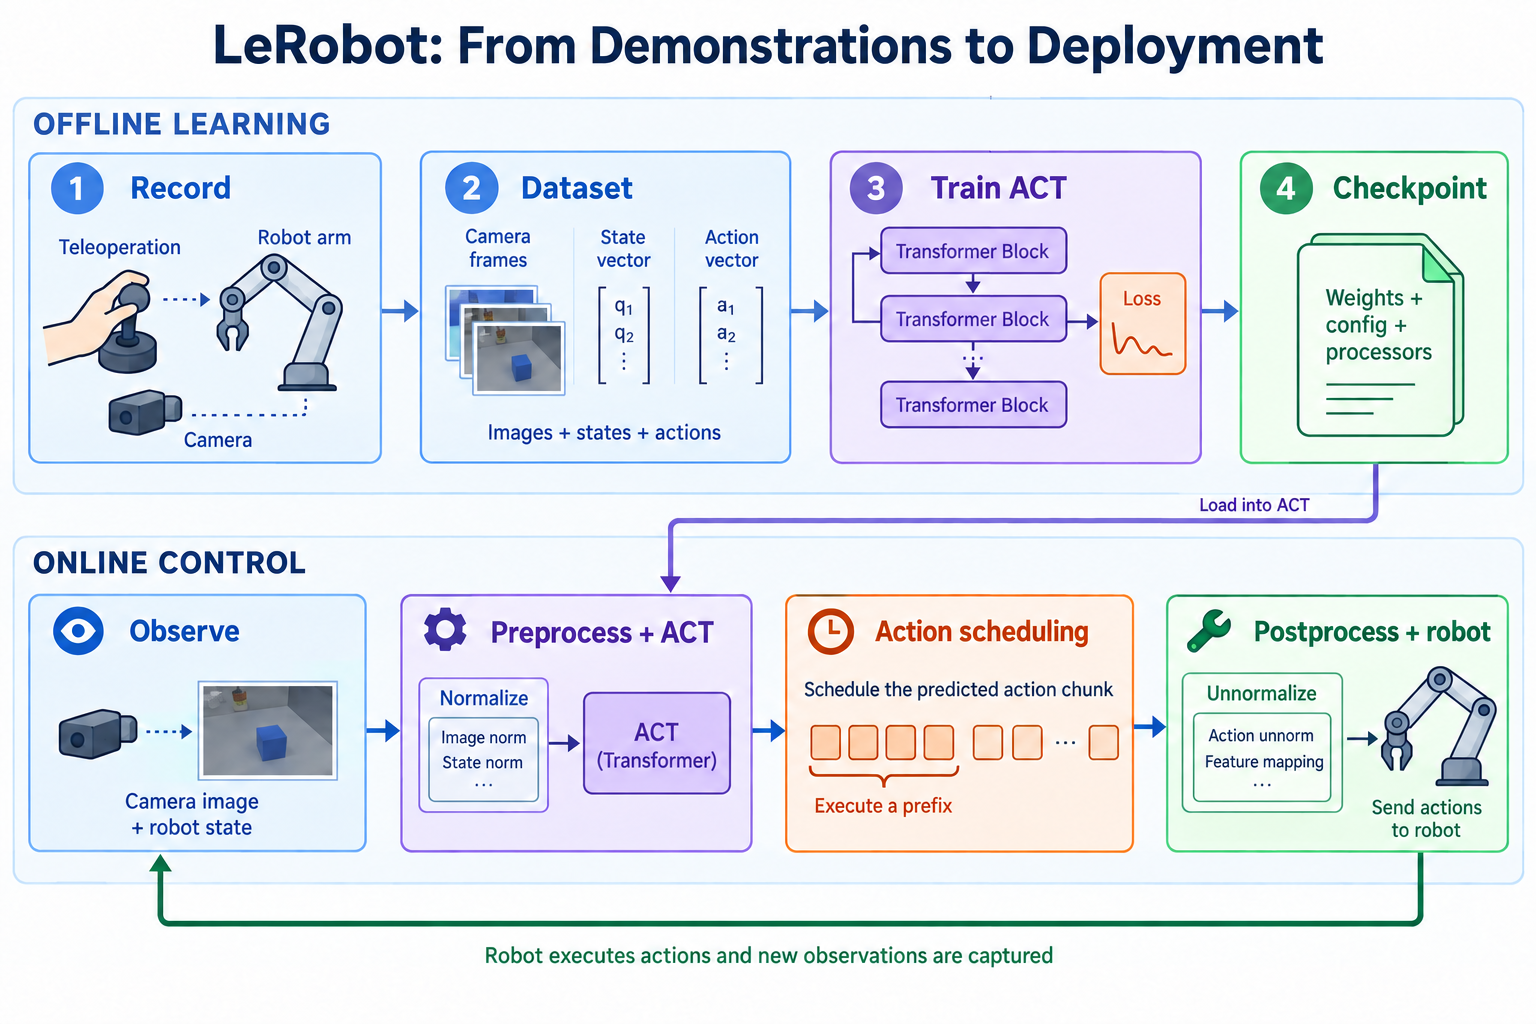
2.1 硬件接口统一调用方式,不统一物理含义
机器人接口提供连接、读取观测、发送动作等操作。策略因此可以与具体串口通信分离。但同样长度的动作向量,可能分别代表关节角、归一化电机位置或末端位姿增量,不能只看形状就互换。
例如,observation.state 记录的是机械臂测得的位置,而 action 可能是遥操作器提供的目标位置。有跟踪误差时,两者本来就不同。把当前状态直接复制成动作标签,往往会教出一套“保持原位”的策略。
接入新硬件时,需要落实四件事:特征名称与顺序、物理单位与范围、标定关系,以及控制指令的时序含义。训练和部署必须采用同一套约定。Robot 接口源码
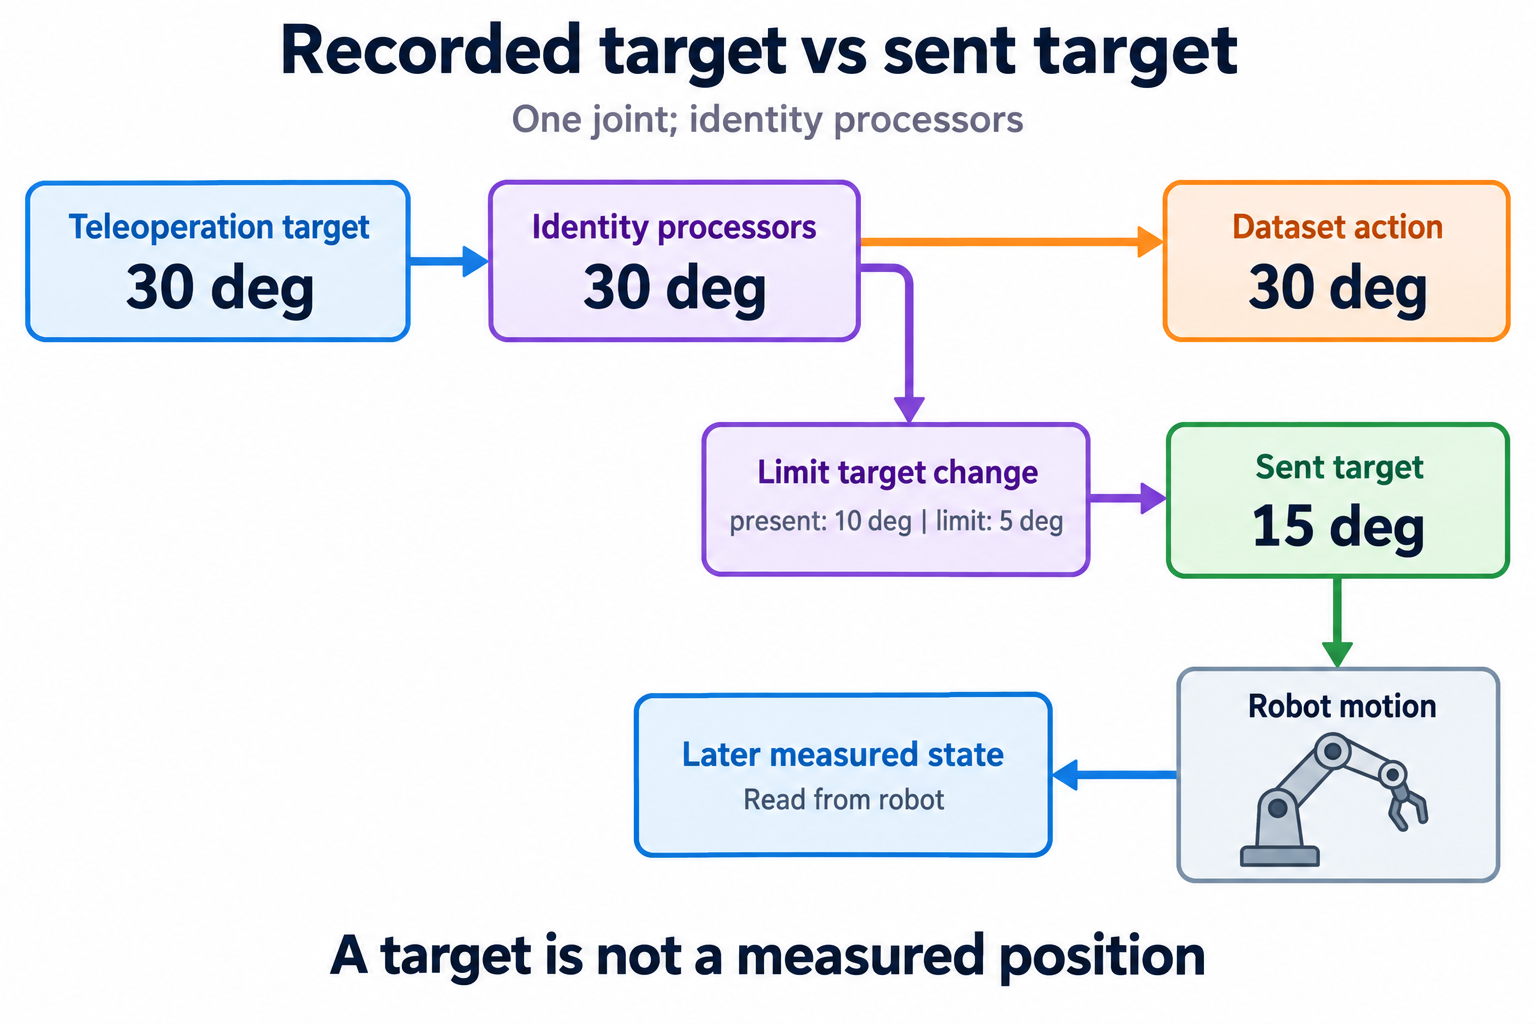
还要区分记录的目标与实际发送的目标。本文版本的 lerobot-record 将遥操作动作经过 teleop_action_processor 后赋给 action_values,用它构造数据集的 action;发送路径还会经过 robot_action_processor 和 robot.send_action()。后者返回的 _sent_action 没有用于替换标签,因此不能笼统地说数据集始终记录了限幅后的指令。采集循环实现
例如,假设某关节当前位置为 10°、遥操作目标为 30°,且设置了 max_relative_target=5.0,SO follower 会把发送目标限制到 15°;在默认恒等处理器下,这一帧的动作标签仍是 30°。15° 也是下发目标,不保证电机当场到达;真实位置需通过后续观测读取。此例仅说明数据流,后文命令没有开启该限幅选项。排查标签与运动不一致时,应同时核对处理器、限幅配置及机器人反馈,而非立即改写标签。SO follower 发送实现
2.2 Processor 也是策略的一部分
在这个版本中,ACT 的预处理和后处理由独立 Processor 管理,包含批次维度、设备迁移、归一化和动作反归一化。直接把相机原始数组交给 select_action(),通常缺少必要转换;把模型输出直接发送给电机,也可能把归一化数值当成真实控制量。
对于采用均值、标准差归一化的一个动作维度,可以写成:
这与核对版本的 MEAN_STD 实现一致:归一化分母加 ε,反归一化则直接乘以标准差,因此数值上并非严格互逆。ε 用于避免除零,不是需要部署时重新拟合的参数。部署要恢复训练时保存的处理器及统计量,不能对实时数据临时重新估计一套均值和方差。ACT Processor、Processor 工厂
2.3 从像素到控制目标:两种归一化不要混淆
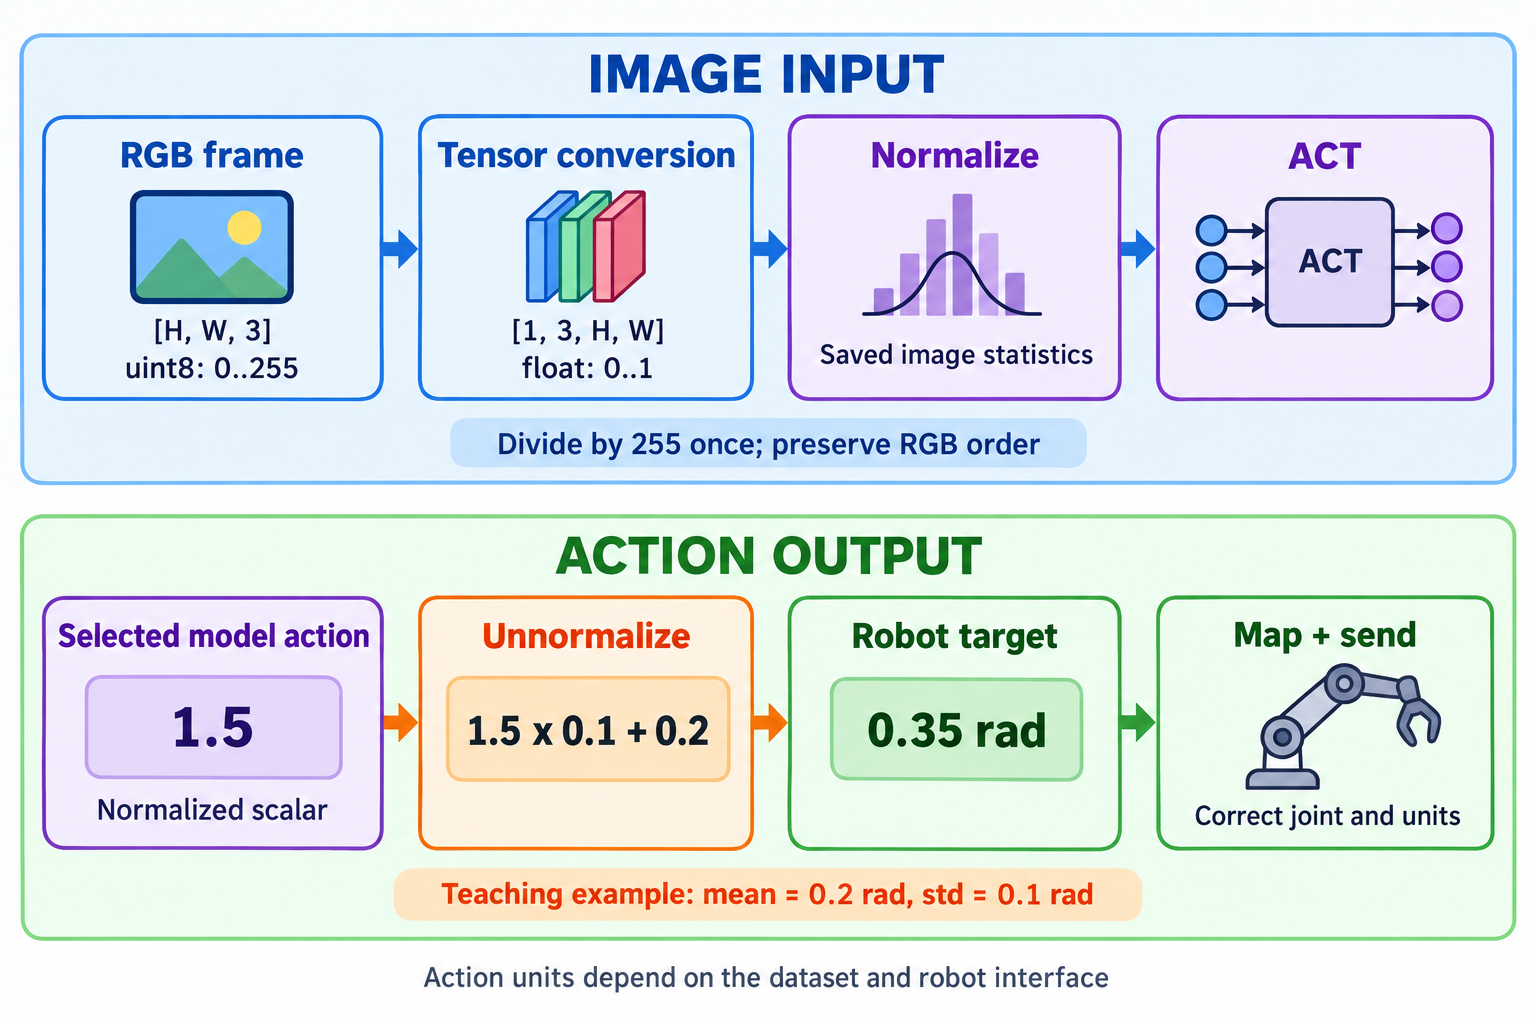
图像输入有两个不同的数值变换:先把 uint8 像素除以 255,得到浮点的 0~1 范围;再使用配置中的均值和标准差进行标准化。后一变换的结果通常不再限制在 0~1。对于已经返回浮点 0~1 图像的数据接口,不能再除一次 255。
在当前同步部署路径中,prepare_observation_for_inference() 先完成图像的 HWC → CHW、除以 255 和批次维度处理,随后才调用策略 Processor。因此,把这些步骤全部归到某一个 Processor 类,容易在自写推理代码时重复处理。应检查完整调用链,并分别记录每一步的 shape、dtype 和数值范围。观测准备函数、同步推理路径
动作输出则需要回到示教标签的数值空间。假设某一关节的动作标签单位是弧度,训练统计量为均值 0.2、标准差 0.1,模型选出的归一化动作是 1.5,则下发前恢复为:
1.5 本身没有弧度含义,也不意味着模型输出超限;均值/标准差归一化不把数值限制在 [-1,1]。反归一化也不会替你把角度制换成弧度制,或把绝对位置转换成增量。这些语义取决于数据定义及机器人适配层。归一化实现
上面的弧度算例不代表后文 SO-101 示例的默认单位。 本文固定版本的 SO follower 与 leader 默认均为 use_degrees=true,五个机械臂关节使用角度,夹爪单独使用标定范围映射:
| 硬件配置 | 机械臂关节 .pos | 夹爪 .pos |
|---|---|---|
use_degrees=true | 角度(度) | 标定后的 0~100 范围值 |
use_degrees=false | 标定后的 -100~100 范围值 | 标定后的 0~100 范围值 |
这里的范围映射属于电机接口,和 ACT Processor 的均值/标准差归一化是不同层次。夹爪值也不能直接解释成毫米。使用已有数据或 checkpoint 时,先查其采集配置;更改 use_degrees 后,形状虽然不变,数值含义却变了,不能仅切换部署参数继续沿用原模型。SO follower 配置、关节与夹爪映射
| 交接位置 | 至少核对什么 | 典型错误 |
|---|---|---|
| 相机 → 观测准备 | RGB/BGR、HWC/CHW、原始数值范围 | 通道颠倒或重复除以 255 |
| 观测准备 → 策略 | 特征名称、批次维、保存的统计量 | 多加一个 batch 维度或使用另一套均值 |
| 策略 → 后处理 | 输出是否已归一化、动作顺序 | 把归一化输出直接交给硬件 |
| 后处理 → 机器人 | 单位、绝对值/增量、夹爪范围 | 形状相同但物理含义不同 |
3. LeRobotDataset:模型实际读到了什么
3.1 一行数据、一个 episode 与一个动作块
一个 episode 是一次完整尝试。一个数据行对应某个采样时刻;ACT 的训练样本则会以这一行为起点,再取未来若干行的动作。
| 字段示例 | 单帧含义 | ACT 训练批次中的典型形状 |
|---|---|---|
observation.images.front | 前置相机 RGB 图像 | [B, 3, H, W] |
observation.images.wrist | 腕部相机 RGB 图像 | [B, 3, H, W] |
observation.state | 当前机器人状态 | [B, Ds] |
action | 当前或未来时刻的控制目标 | [B, K, Da] |
action_is_pad | 动作是否因越过 episode 边界而填充 | [B, K] |
episode_index、frame_index、timestamp | 轨迹、帧与时间定位 | 元数据,不都直接输入网络 |
其中 B 为 batch size,K 为动作块长度,Ds 与 Da 分别为状态和动作维度,不必相等。图像在读取、预处理以后应满足模型需要的通道顺序与数值范围。
普通的 dataset[i] 不会凭空返回长度为 K 的动作序列。需要配置时间窗口;标准训练入口会根据策略的 action_delta_indices 和数据 FPS 生成相应的 delta_timestamps。数据集时间窗口解析
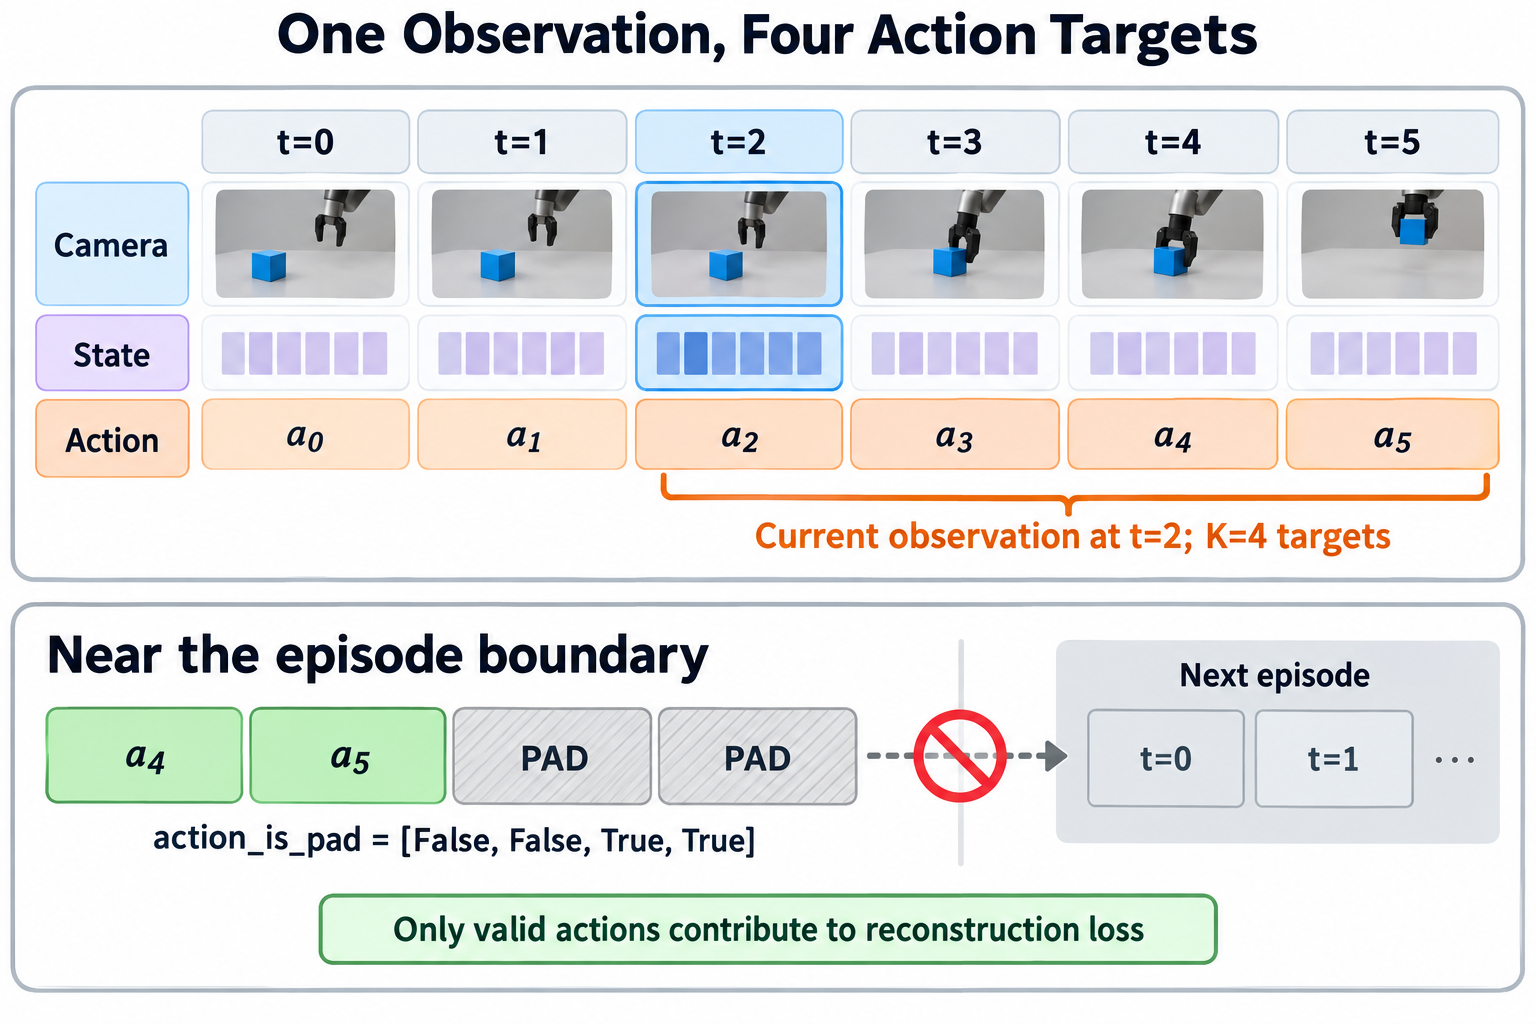
读图顺序:先看蓝色高亮的当前观测,再沿橙色括号找到四个动作标签;下半图把起点移到 t=4,因此只有 a4、a5 有效。PAD 表示逻辑上的无效位置,张量里仍需填入数值。
3.2 v3 的存储结构
常见的 Parquet 与视频存储方式,可以概括为:
dataset-root/
├── meta/
│   ├── info.json            # 特征 schema、FPS、路径模板等
│   ├── stats.json           # 归一化统计量
│   ├── tasks.parquet       # 本文核对版本中的任务表
│   └── episodes/           # episode 边界与文件偏移等元数据
├── data/
│   └── chunk-000/file-000.parquet
└── videos/
    └── observation.images.front/
        └── chunk-000/file-000.mp4
这是示意目录,实际路径应读取元数据。v3 的重点是:多个 episode 可以共享一个 Parquet 或 MP4 文件,逻辑轨迹边界由元数据恢复。 不能再默认“一段视频文件就是一个 episode”。
核对版本的 v3 文档仍有 meta/tasks.jsonl 的旧描述,而源码的 DEFAULT_TASKS_PATH 已是 meta/tasks.parquet,并单独保留旧路径常量。排查真实数据时应同时检查格式版本、info.json 和读取实现。v3 设计文档、存储路径常量
3.3 对齐错误比模型大小更值得先检查
以下是实践中的检查顺序:
- 时间对齐:图像、状态和动作是否对应约定的同一控制周期?相机延迟是否稳定?
- 动作语义:记录的是下发目标、观测位置还是位置增量?夹爪开合方向是否一致?
- 轨迹边界:取动作窗口时是否越过 reset,串到了下一次示教?
- 数据划分:按完整 episode,最好再按采集场次或场景划分训练与评估,避免相邻帧泄漏。
- 分布覆盖:初始位置、抓取姿态与接触失败后的修正是否被示范过?
例如相机比动作慢 100 ms,在 30 Hz 采样下就是约三帧。模型可能一直在学习“根据过去的画面预测现在的命令”。这种误差通常不能靠多训练几轮解决。
4. ACT 为什么一次预测一段动作
4.1 从逐步行为克隆到动作块
设当前观测为 ,由多路图像和机器人状态组成。普通单步 BC 学习:
ACT 学习的是一个动作块:
下标 表示“在时刻 做出、针对时刻 的预测”。这不是一次输出多个备选动作,而是按时间排列的一段连续控制目标。
逐步 BC 在执行中稍有偏差,就可能看到示教里没有出现过的状态,随后继续偏离,形成误差累积。动作分块让模型在同一次预测中学习“靠近、闭合夹爪、抬起”等局部运动之间的关联。原论文用它缩短有效决策跨度,但这不意味着分布偏移消失,也不保证开环执行任意长的一段都可靠。ACT 论文
4.2 预测长度和执行长度是两个参数
定义:
chunk_size = K:每次网络前向预测多少步。n_action_steps = M:不开时间集成时,每次预测后实际取前多少步执行。fps = f:训练数据与执行的时间尺度。
例如 、、 Hz:动作块包含 100 个采样点,覆盖约 3.33 秒的动作序列,首末时间戳相差 秒;执行前 20 步后使用最新观测重新预测,理想情况下约每 0.67 秒更新一次动作计划。
把 M 降到 1 会更频繁地利用视觉反馈,但推理计算必须跟得上。把 K 增大则会延长预测跨度,也增加序列建模和监督的负担。这两个改动的含义不同。
即使底层电机始终在做位置反馈控制,策略在动作队列未耗尽时也可能没有使用新图像。电机闭环与视觉策略闭环的频率不是一回事。
4.3 用六个控制周期看清“预测”和“执行”
把窗口缩短为 K=4、M=2,便于手算。记 A(s) 为根据时刻 s 的观测生成的动作块,方括号内使用从零开始的索引。
| 控制时刻 | 此刻是否重新预测 | 实际执行 | 被保留或丢弃的预测 |
|---|---|---|---|
0 | 是,生成 A(0) | A(0)[0] | 队列还剩 A(0)[1] |
1 | 否 | A(0)[1] | A(0)[2:4] 没有进入执行队列 |
2 | 是,生成 A(2) | A(2)[0] | 新观测修正了原先对时刻 2 的计划 |
3 | 否 | A(2)[1] | 队列耗尽 |
4 | 是,生成 A(4) | A(4)[0] | 再次使用新观测 |
5 | 否 | A(4)[1] | 下一周期才重预测 |
虽然每块后两步没有执行,训练时仍然监督全部四步。这可以让网络学习较完整的局部运动,同时在部署时只承诺执行较短的前缀。不过,后半段预测的质量是否帮助了当前动作,需要通过实验验证,不能仅凭窗口更长就认定策略更好。
这与滚动时域控制在“预测一段、执行前缀、重新规划”上相似,但 ACT 没有因此获得 MPC 的动力学模型、在线约束求解或稳定性保证。
5. ACT 网络:两个 Encoder 分别做什么
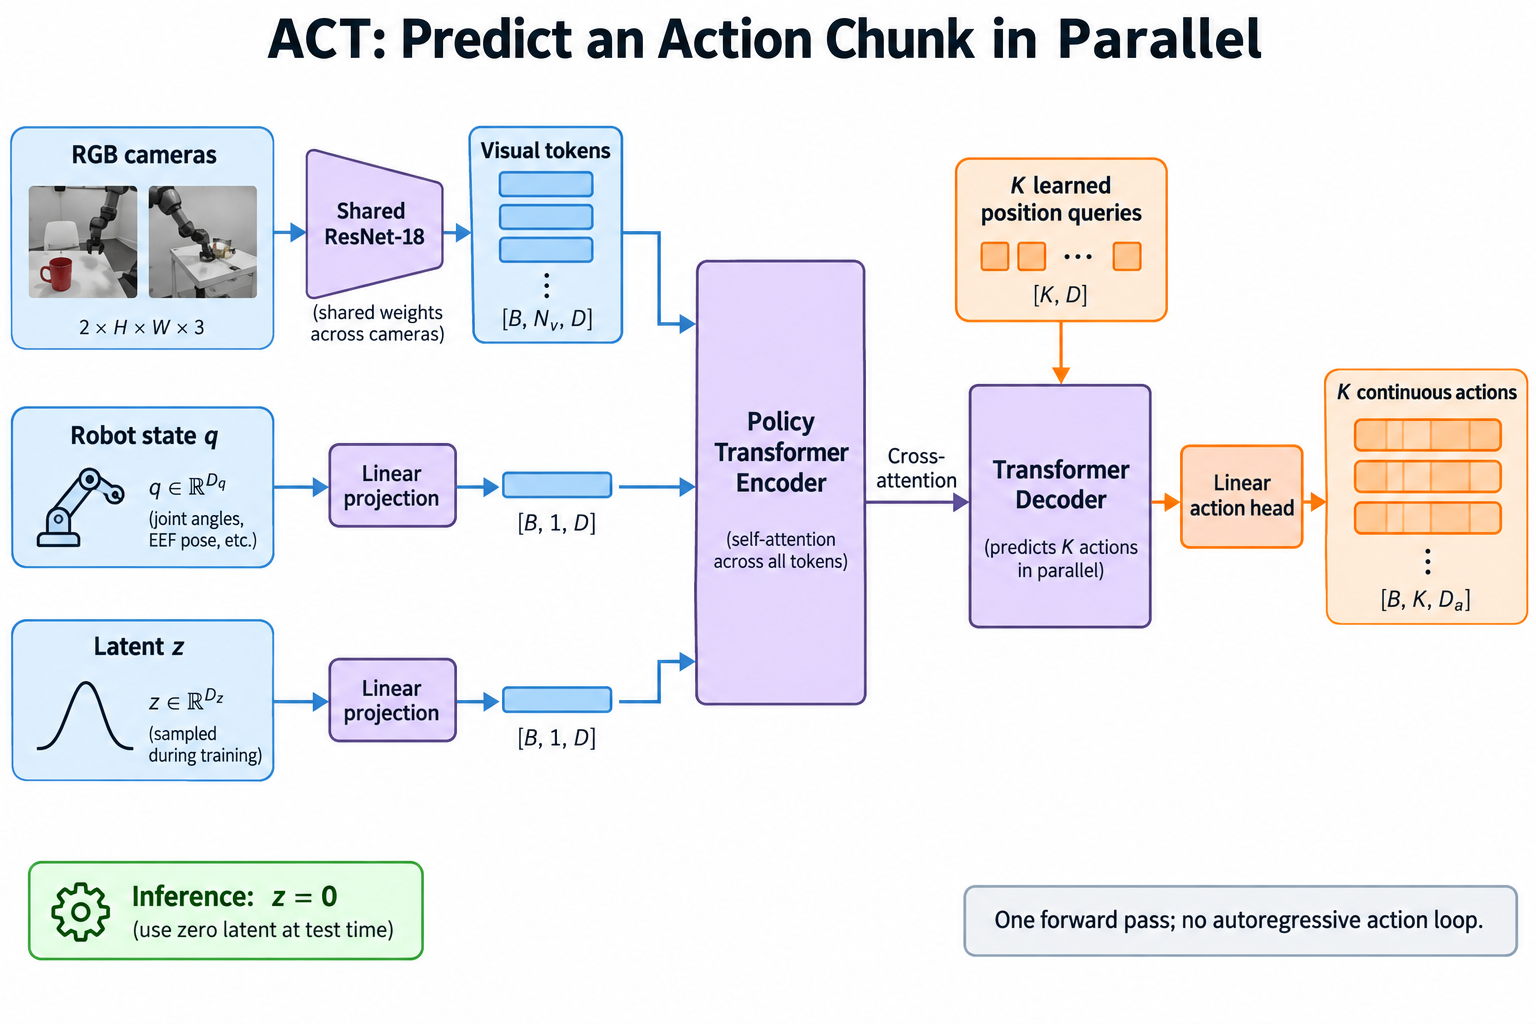
5.1 视觉与状态编码
在本文核对的默认配置中,视觉骨干为带 ImageNet 预训练权重的 ResNet-18。图像变成空间特征图,经投影进入 Transformer 的隐藏维度,再展平成视觉 token。空间位置编码保留“特征来自画面哪里”的信息。
状态向量经线性层投影成 token,潜变量 也映射成 token;策略 Encoder 融合这些 token 与各相机特征。这里的 n_obs_steps=1 表示每次使用一个观测时间步,多相机并不等于多帧历史。
若每个相机生成 个视觉 token,使用 个相机、一个状态 token 和一个潜变量 token,则策略 Encoder 的序列长度约为 。因此提高图像分辨率或增加相机数量,也会增加注意力的计算和显存开销。
5.2 Decoder 并行产生动作
Decoder 为动作块的 K 个时间位置分别设置可学习的位置向量,通过 cross-attention 读取 Encoder 特征,最后经线性回归头得到 [B, K, Da]。第 j 个位置始终对应相对当前观测的第 j 步动作;它不是某个关节的专属查询,每个位置都会输出完整的 Da 维动作。
它不是像语言模型一样先生成第一个动作、把它拼回输入、再逐步生成第二个动作。一个动作块在一次前向中并行产生;也不是输出离散动作 token 后查码本还原。这里输出的是连续动作数值。
为什么 Decoder 内容全零,却能输出不同时间位置的动作? 零初始化的是内容张量,可学习的位置向量并不相同。源码将位置向量加入注意力的 Query、Key 输入,使不同时间位置能够从同一份观测特征中读取不同信息。回归头在所有位置共享参数,但接收的隐藏特征不同,因此输出可以不同。
令 x 表示 Decoder 当前的内容特征,memory 表示 Encoder 输出,p_action 和 p_obs 分别表示动作位置与观测位置编码。忽略 LayerNorm、残差和投影细节,两个注意力操作的输入为:
| 注意力操作 | Query 输入 | Key 输入 | Value 输入 |
|---|---|---|---|
| Decoder self-attention | x + p_action | x + p_action | x |
| Decoder cross-attention | x + p_action | memory + p_obs | memory |
这里列的是传给注意力模块的张量,模块内部还会做 Q/K/V 线性投影。位置向量用于区分查询位置,不是预先写好的动作轨迹;动作内容由观测条件和学习到的网络参数共同决定。Decoder 层实现
以 B=8、两路 480×640 图像、Ds=Da=6、K=100 为例,默认 ResNet-18 最终步幅为 32,张量沿主策略网络的变化如下。这里的尺寸仅对应这个输入和默认骨干配置:
| 阶段 | 张量形状 | 说明 |
|---|---|---|
| 单路图像 | [8, 3, 480, 640] | 每路相机独立提取特征,共享视觉骨干 |
| 单路空间特征 | [8, 512, 15, 20] | 一路得到 300 个空间位置 |
| 两路视觉 token | [600, 8, 512] | 源码内部采用序列维在前的排列 |
| 加入状态与潜变量 | [602, 8, 512] | 各增加一个 token |
| Decoder 查询 | [100, 8, 512] | 内容初始为零,加入可学习的查询位置编码 |
| 动作回归输出 | [8, 100, 6] | 每个时间位置回归 6 维连续动作 |
CVAE Encoder 则是另一条长度为 K+2=102 的序列:一个 CLS token、一个状态 token,加 100 个真实动作 token。它不接收这 600 个图像 token。这样区分以后,就不容易把两个 Encoder 的序列长度和 padding mask 混在一起。
并行 Decoder 的查询之间可以相互注意,不要求语言模型式的因果 mask:它们代表待预测的时间位置,没有携带真实未来动作标签。因此,第 0 个查询能关注第 99 个查询,并不等于看到了第 99 步的真实动作。真实动作标签进入训练时的 CVAE 后验分支,并用于计算重建损失;它们不会直接作为主策略 Decoder 的动作查询输入。
5.3 避免把两个 Encoder 混为一谈
| 组件 | 输入 | 作用 | 标准推理是否使用 |
|---|---|---|---|
| CVAE Encoder | 当前状态、真实动作块、padding mask | 推断潜变量分布 | 否 |
| 策略 Transformer Encoder | 图像特征、状态、潜变量 | 融合当前条件 | 是 |
| 策略 Transformer Decoder | Encoder 特征、时间位置查询 | 输出动作块 | 是 |
从 CVAE 的整体视角看,整个动作预测网络,包括它自己的 Transformer Encoder 和 Decoder,合起来才是 CVAE 的解码器。源码中的 vae_encoder、encoder、decoder 正好对应这三个不同角色。ACT 网络实现
6. CVAE:为什么训练时输入真实的未来动作
同一张画面下,人可以用不同速度、抓取姿态和运动风格完成任务。ACT 用条件变分自编码器(CVAE)为这些差异引入潜变量。
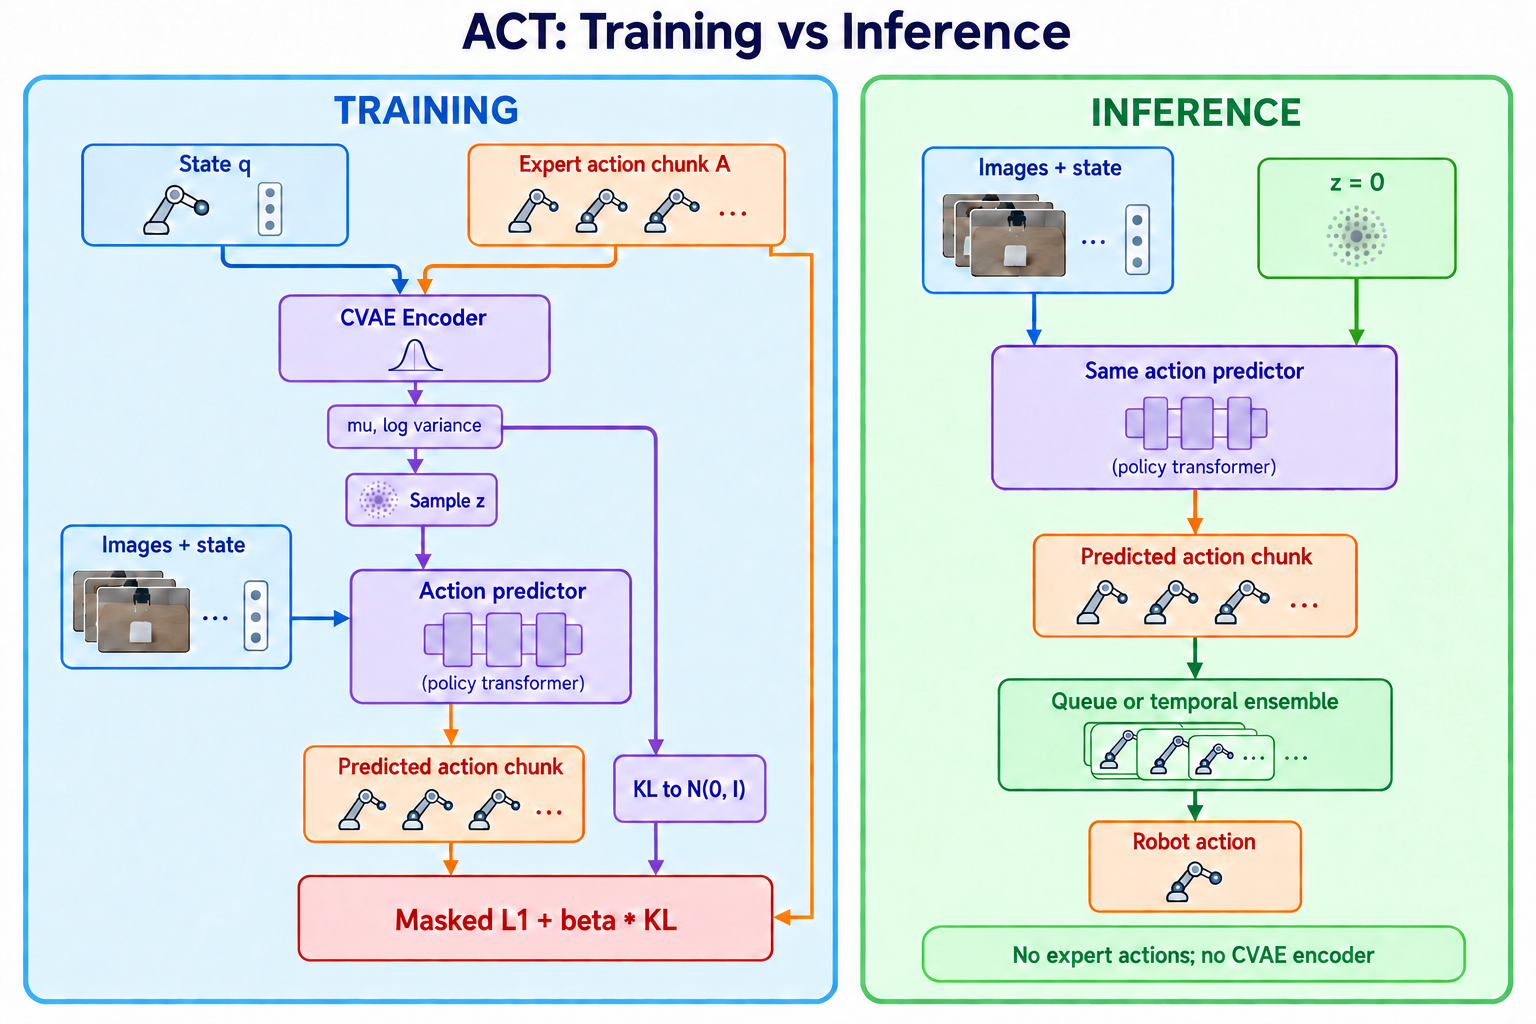
读图顺序:先跟随左图的“真实动作 → 后验 → z → 动作预测”路径,再看右图如何用 z=0 替代它。两侧的 Action predictor 是图 5 的整个主策略网络,不是单独一个 Transformer Decoder。
6.1 后验与重参数化
训练时,CVAE Encoder 接收状态 和示教动作块 ,预测一个对角高斯后验:
通过重参数化采样:
这里未来动作是训练监督的一部分,用于估计后验,并不是假设机器人运行时可以知道未来。部署时去掉这条分支,按标准 ACT 做法设 ,即标准正态先验的均值。
标准部署固定 z=0,而不通过反复采样潜变量探索多个动作模式。动作预测网络是非线性的,因此“在潜变量均值处预测”通常不等于“对不同潜变量的动作预测求平均”。CVAE 有助于建模示教差异,但最终的确定性执行效果仍需通过 rollout 检查。
6.2 重建损失与 KL 正则
令 在第 个样本、第 个动作有效时取 1,否则取 0。核对版本按有效动作元素归一化 L1 损失:
这里的动作已经过策略预处理,L1 计算发生在归一化后的动作空间。因此,L1=0.1 不能直接读成“平均关节误差为 0.1 弧度”。按维度恢复物理量后,才能分别讨论关节位置、夹爪开度等误差;同一个归一化误差乘上不同标准差,会得到不同的物理误差。
分母还决定了 batch 内的加权方式:源码先汇总所有有效动作元素,再除以有效元素总数。以单维动作为例,样本 A 有 4 个有效元素、每个误差为 1,样本 B 有 1 个有效元素、误差为 3,batch L1 是 (4×1+1×3)/5=1.4,而不是先算两条样本均值再平均得到的 2.0。这解释了为什么 padding 比例变化会影响不同样本对 batch 损失的贡献。
对角高斯与标准正态之间的 KL 项是:
总损失:
L1 督促动作重建,KL 约束后验靠近先验,减少训练潜变量与推理固定潜变量之间的脱节。kl_weight 就是 。权重太小可能使网络过度依赖训练时从真实动作中提取的信息;太大则可能使潜变量携带的信息过少。判断时应同时观察 L1、KL 和实际 rollout,不能只比较总 loss。
这几个公式对应核对版本的 ACTPolicy.forward();不同历史实现对 padding 后的平均方式可能不同,因此同名 loss 的绝对数值未必能直接横向比较。损失实现
对照原论文时还有一个细节:Algorithm 1 的伪代码写作 MSE,但第 IV-C 节明确说明实际采用 L1 重建损失。本文遵循已核对源码中的 L1 实现,不把伪代码里的 MSE 当成当前训练目标。原论文
6.3 episode 尾部必须屏蔽填充
假设 K=100,采样起点距离 episode 结束只剩 15 个有效动作,其余位置需要填充,以形成固定长度张量。填充值不是额外的真实示教,不能跨过边界从下一条轨迹补齐。
action_is_pad 在两个地方参与计算:一是在 CVAE Encoder 中屏蔽无效动作 token,二是在动作重建损失中去掉无效元素。两者缺一,都可能让尾部样本传递错误的监督。
窗口能补齐到 K,不代表每个预测位置都有足够监督。 对长度为 L 的完整 episode,假设每一帧都作为窗口起点、动作偏移为 0…K-1,第 j 个预测位置只有 max(L-j,0) 个有效标签。越远的预测位置,可用标签越少;如果所有轨迹都短于 K,最远的位置甚至从未参与动作重建损失。
以 K=100 为例,逐帧枚举一个 episode 的全部窗口,可以得到:
episode 长度 L | 每个窗口平均有效动作数 | 有效位置占比 | 第 100 个位置的有效标签数 |
|---|---|---|---|
| 50 帧 | 25.5 | 25.5% | 0 |
| 100 帧 | 50.5 | 50.5% | 1 |
| 300 帧 | 83.5 | 83.5% | 201 |
这些比例按所有窗口位置统计,重复出现的标签也重复计数,不代表独立示教数量;实际训练的采样器若筛掉部分起点,统计还会变化。选择 K 时,应同时查看 episode 长度分布和各预测偏移的有效标签数。大量 padding 不会凭空提供长时域监督;也不宜只为降低 padding 比例裁掉尾部,因为那可能删除释放夹爪、完成放置等关键阶段。下面的时序脚本会打印这张表对应的数值。
6.4 为什么 train loss 和 eval loss 不能直接比较
在核对版本中,ACT.forward() 只在 self.training 为真时,从真实动作块估计后验并采样 z。切换到 eval() 后,即使 batch 里还有真实动作,策略也使用 z=0;ACTPolicy.forward() 此时没有后验参数,因此不会加 KL 项。
| 调用状态 | z 的来源 | 返回的损失 |
|---|---|---|
policy.train() 下的训练前向 | 从示教后验采样 | 有效动作 L1 + 加权 KL |
policy.eval() 下的验证前向 | 全零 | 有效动作 L1 |
select_action() 在线执行 | 全零 | 返回动作,不计算监督损失 |
因此,训练总 loss 高于验证 loss 不一定意味着模型异常;两者的目标组成、潜变量来源和 dropout 状态都不同。应分别记录训练 L1、训练 KL,以及 z=0 时的验证 L1,最终再看闭环任务结果。验证循环源码
torch.no_grad() 或 torch.inference_mode() 只控制梯度记录,不能代替 policy.eval()。自写脚本直接调用 policy(batch) 计算验证损失时,需要同时设置评估模式和禁用梯度;否则可能仍然走训练后验分支。本文版本的 select_action() 与 predict_action_chunk() 内部会调用 self.eval(),但不要把这一行为误套到普通前向调用上。推理入口实现
7. 推理:动作队列与 Temporal Ensembling
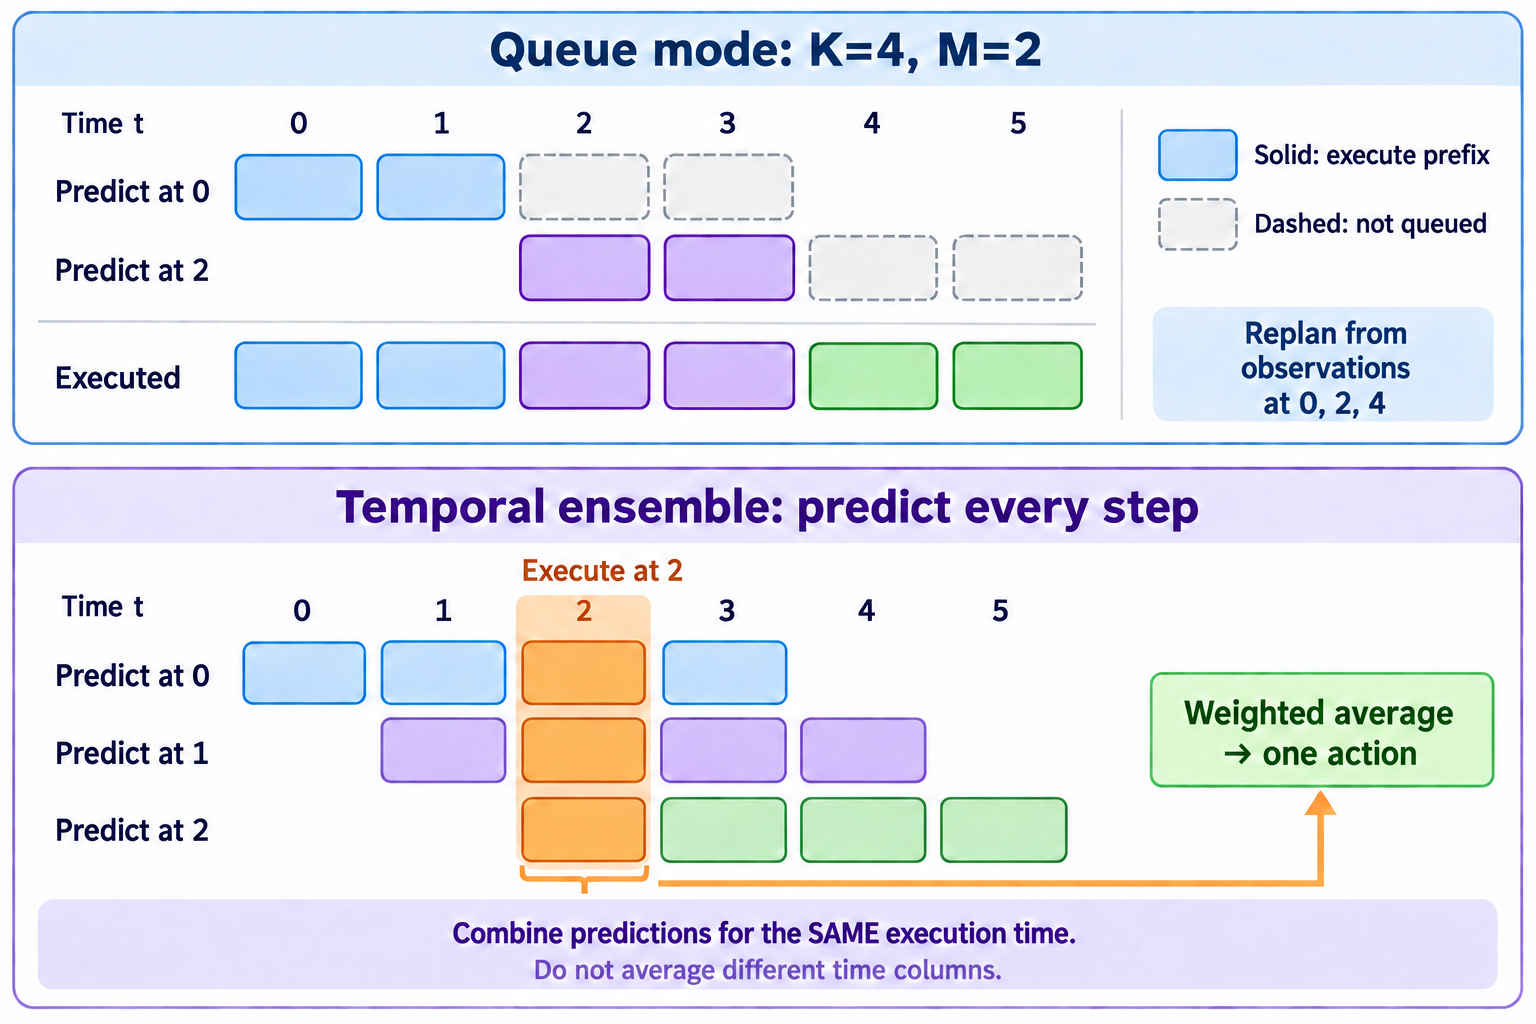
读图顺序:上半图按行看每次预测、按最底行看实际执行;下半图只看橙色竖列,不要沿某一行平均。绿色执行块来自时刻 4 的新预测,图中省略了这次预测的完整行。
7.1 默认队列模式
不开启时间集成时,select_action() 维护一个队列:
- 队列为空,用当前观测预测一个长度为
K的动作块。 - 将前
M=n_action_steps个动作入队。 - 每次调用弹出一个动作,直到队列耗尽。
- 再次用最新观测预测。
因此,“每个控制周期调用一次 select_action()”不等于“每个周期都运行了一次网络”。控制循环仍可逐周期读取相机与机器人状态,队列未耗尽时返回的动作则仍来自此前的预测。切换到一个新的独立 episode 时要调用 policy.reset(),否则上一条轨迹的队列可能残留。
7.2 时间集成融合的是同一时刻的多个预测
启用 Temporal Ensembling 后,每步重新预测整个动作块。不同起始时刻的动作块会对当前时刻给出多个预测:
| 预测发生时刻 | 对执行时刻 t=2 有效的元素 |
|---|---|
t=0 | 第 3 个元素:预测未来两步后的动作 |
t=1 | 第 2 个元素:预测未来一步后的动作 |
t=2 | 第 1 个元素:预测当前动作 |
时间集成将这一列融合,而不是把当前动作块内部不同未来时刻的动作平均掉。后者会破坏轨迹的时间含义。
把针对同一执行时刻的候选动作按生成时间从旧到新记为 ,LeRobot 使用:
注意 是最早生成的候选预测。因此 m>0 更偏重较早的预测,m=0 为均匀平均,m<0 更偏重新预测。不能把这里的索引误解成“距离现在的年龄”,然后把权重方向解释反了。
系数为 0 仍然开启时间集成;只有 None 才关闭它。 前者每步预测并对同一执行时刻的候选动作取均值,后者使用动作队列。这也意味着 temporal_ensemble_coeff=0.0 仍需搭配 n_action_steps=1,不能拿它表示“保持队列模式,但不加权”。
候选数量也不是从第一步就等于 K。从 episode 起点 t=0 开始、每步都预测时,当前执行时刻拥有 n=min(t+1,K) 个候选:第一步只有一个,随后逐步增加,到 t=K-1 才达到 K 个。新 episode 调用 reset() 后,这个过程重新开始。
系数的效果要结合候选数量理解。对于 m=0.01,最新候选与最旧候选的权重比是 exp(-0.01×(n-1)):n=3 时约为 0.980,差异很小;n=100 时约为 0.372。因此,同一个系数在 episode 开头与稳定运行阶段的融合效果不同,也不能脱离 K 比较系数大小。
这是实现层面的定义。偏重早期预测有助于保持先前动作计划的连续性,但也可能减缓对新情况的响应,具体效果要看任务与系数。ACTTemporalEnsembler 源码及注释
7.3 一个可运行的数值例子
下面只用 Python 标准库验证加权方向,不加载模型,也不连接机器人:
import math

def ensemble(oldest_to_newest, coefficient):
    weights = [math.exp(-coefficient * i)
               for i in range(len(oldest_to_newest))]
    return sum(w * a for w, a in zip(weights, oldest_to_newest)) / sum(weights)

# 都在预测同一个执行时刻;数值只是教学例子。
predictions = [0.2, 0.5, 0.8]
for coefficient in (0.0, 0.5, -0.5):
    print(f"m={coefficient:+.1f}: {ensemble(predictions, coefficient):.4f}")
结果为 0.5000、0.4040、0.5960。正系数向较旧的 0.2 偏移,负系数向较新的 0.8 偏移。这里故意用绝对值较大的系数,让差异更明显。
完整的动作时序小实验还演示了队列重预测、episode 尾部的 masked L1,不同有效长度在 batch 损失中的权重,以及同步推理的周期预算。下载到本地后运行:
python act_timing_lab.py
python act_timing_lab.py --chunk-size 6 --action-steps 3 --coeff 0.01
脚本只使用标准库,以标量动作代替机器人动作向量,并明确打印“当前执行时刻”和“生成预测的时刻”。这些合成数值用于验证时序机制,不衡量 ACT 网络性能。
输出中的 candidates 是本周期参与融合的预测数,newest/oldest 是最新与最旧候选的权重比。默认 K=4 时,候选数依次为 1、2、3、4、4、4;可将 --coeff 改为 0,观察均匀平均仍然在每步融合多个候选。脚本为了展示来源而逐项列出历史预测;LeRobot 的实现则维护未来各时刻的累计均值与计数,消费当前动作后移动窗口,不需要保存所有历史动作块。
7.4 时间集成的代价与边界
启用它需要设置 n_action_steps=1,因为每一步都要获取新预测;核对版本会拒绝“时间集成开启且执行步数大于 1”的配置。它可以减小块切换时的不连续,但不是关节限速器、碰撞检测器,也不能自动弥补推理超时。
ACT 时间集成与 RTC 也不是同一个机制:这里融合重叠预测,RTC 则重点处理异步推理时已经在执行的动作前缀和新动作块衔接。关于后者可继续阅读实时动作分块文章。
7.5 三种频率与一次推理的时间预算
在线执行至少涉及三个频率。设数据与策略动作频率为 f,队列每次取 M 步,机器人插值倍率为 N,在各周期都能按时完成的理想情况下:
| 频率 | 队列模式、不做时间集成 | 30 Hz、M=20、N=2 的例子 |
|---|---|---|
| 策略动作消费频率 | 每秒取出 f 个动作 | 30 次/秒 |
| ACT 网络调用频率 | 约为 f/M | 1.5 次/秒 |
| 机器人指令发送频率 | 约为 f×N | 60 次/秒 |
相机采集频率是另一项硬件配置。即使每个控制周期都有新观测,队列未耗尽时也不会重新计算动作块。开启时间集成后,网络需要每个策略动作周期都预测一次,理想调用频率才接近 f。
本文版本的 lerobot-rollout 提供 --interpolation_multiplier。例如在 --fps=30 的基础上设置倍率 2,会在线性插值后以目标 60 Hz 发送机器人命令,同时保持 30 Hz 的策略动作时间尺度。它有助于细化发送节奏,但不会增加新的视觉决策,也不能代替降低模型推理延迟。Rollout 配置
同步推理尤其要检查重预测的那个周期。 以下算例不启用插值(N=1):假设目标为 30 Hz、每周期预算约 33.3 ms,观测、处理和发送合计需要 8 ms,而一次网络前向需要 50 ms:
| 周期类型 | 计算耗时 | 是否落在 33.3 ms 预算内 |
|---|---|---|
| 从队列取动作 | 约 8 ms | 是 |
| 队列为空,重新预测 | 约 58 ms | 否 |
| 时间集成,每周期预测 | 每周期约 58 ms | 否 |
取 M=20 后,摊到每个动作的平均工作量只有 8+50/20=10.5 ms,但那次 58 ms 的重预测仍然会阻塞同步执行。平均工作量能估计吞吐开销,不能证明每个控制周期都准时。 上述数字用于说明预算计算;真实系统应记录预热后的控制周期分布、最慢周期和超期次数,并检查相机与通信耗时。同步控制循环
排查时先确定瓶颈:如果耗时主要来自相机读取,单纯缩小 Transformer 不一定有效;如果网络前向已超过周期预算,仅调整队列平均调用频率也不能消除切块时的停顿。异步推理需要进一步处理观测滞后和动作衔接,可参照 RTC 的时序分析。
8. 对照源码理解默认配置
以下默认值来自本文固定提交的 ACTConfig;升级版本时应重新核对。
| 参数 | 默认值 | 含义 |
|---|---|---|
n_obs_steps | 1 | 只支持一个观测时间步 |
chunk_size | 100 | 一次预测的动作数 |
n_action_steps | 100 | 默认整块入队执行 |
vision_backbone | resnet18 | 视觉特征提取网络 |
dim_model / n_heads | 512 / 8 | Transformer 隐藏维度与注意力头数 |
dim_feedforward | 3200 | 前馈层维度 |
n_encoder_layers / n_decoder_layers | 4 / 1 | 策略 Transformer 层数 |
use_vae / latent_dim | true / 32 | 使用 CVAE,潜变量 32 维 |
n_vae_encoder_layers | 4 | CVAE Encoder 层数 |
kl_weight | 10.0 | KL 损失权重 |
temporal_ensemble_coeff | None | 默认不开时间集成 |
optimizer_lr / optimizer_lr_backbone | 1e-5 / 1e-5 | 主网络与视觉骨干学习率 |
一个容易忽视的细节是 n_decoder_layers=1:源码注释解释,它是为了对齐原 ACT 实现中实际只生效第一层的行为。复现实验时,应区分论文设计、原始实现实际行为和 LeRobot 的配置,不能只从文字描述抄一个层数。ACT 配置及校验
初次调试建议先确认默认配置的数据流,再单独调整 n_action_steps 或时间集成。若同时更换动作表示、图像尺寸、块长度和数据增强,即使成功率发生变化,也很难知道原因。
8.1 哪些参数可以复用同一份权重
| 参数变化 | 对已训练模型的影响 | 应怎样操作 |
|---|---|---|
n_action_steps | 改变每次执行的前缀长度,不改变动作预测头 | 保持 1 ≤ M ≤ K,用新配置构造策略 |
temporal_ensemble_coeff | 改变重叠预测的融合方式,不改变网络权重 | 设置 M=1,重新构造策略和集成器 |
chunk_size | 改变可学习查询的长度,也影响 CVAE 位置编码 | 不能当作普通部署开关,需要处理结构与权重兼容性 |
dim_model、层数、动作维度 | 改变网络参数形状或含义 | 需要相应模型与训练方案 |
kl_weight | 改变训练目标;标准推理没有 KL 损失 | 已有 checkpoint 不会因改这个值而重新学会动作 |
fps | 改变动作序列对应的物理时间尺度 | 对照数据采样率和执行计划处理,不能随意覆盖 |
尤其不要把 policy.config.temporal_ensemble_coeff 从 None 改成数值后,就认为 policy.reset() 会自动创建集成器。源码在 ACTPolicy.__init__() 中创建它;reset() 只清空现有状态。即使原来已经开启集成,系数对应的权重也在集成器初始化时计算。策略与集成器初始化
要对同一个本地 ACT checkpoint 比较队列与集成模式,可以在加载权重之前构造配置:
from dataclasses import replace
from lerobot.policies.act.configuration_act import ACTConfig
from lerobot.policies.act.modeling_act import ACTPolicy

checkpoint = "outputs/train/act_cube_to_box/checkpoints/last/pretrained_model"
base_config = ACTConfig.from_pretrained(checkpoint)
assert isinstance(base_config, ACTConfig), "Expected an ACT checkpoint"

# 队列模式:执行前 20 步。该 checkpoint 的 chunk_size 必须至少为 20。
queue_config = replace(
    base_config, n_action_steps=20, temporal_ensemble_coeff=None
)
# 时间集成模式:每步重新预测。replace 会运行配置类的初始化校验。
ensemble_config = replace(
    base_config, n_action_steps=1, temporal_ensemble_coeff=0.01
)

# 每次选择一种配置,创建一个新策略;另一个实验再重新加载。
policy = ACTPolicy.from_pretrained(checkpoint, config=ensemble_config, strict=True)
policy.eval()
policy.reset()
这段代码只展示策略加载,运行前需要真实的本地 checkpoint 和 LeRobot 环境。完整推理仍需恢复相同 checkpoint 的前后处理器、准备观测并连接执行接口;第 9.5 节的 rollout 入口负责串联这些组件。strict=True 用于尽早发现权重键或形状不匹配,不能验证动作单位、关节顺序或控制频率是否正确。权重加载实现
9. 实践:从环境到采集、训练和执行
9.1 建立与源码版本匹配的环境
这个提交的 pyproject.toml 要求 Python ≥ 3.12。基础包、训练依赖与硬件依赖已拆分为 extras;不能照搬早期教程,认为安装一个基础包就具备所有工作流。依赖声明
以下以已克隆的本地仓库和独立 Conda 环境为例,将 /path/to/lerobot 替换为你的路径。先核对 git rev-parse HEAD 的输出是否为本文固定提交 89236ea0f4f81a81ca566081e20dd1ff5f823cbe;后续命令按这个版本编写。
conda create -n lerobot-act python=3.12 -y
conda activate lerobot-act
cd /path/to/lerobot
git rev-parse HEAD

# ACT 不需要一个额外名为 act 的依赖组。
python -m pip install -e ".[training]"

# 在受支持的平台上,为视频解码配置 FFmpeg。
conda install -c conda-forge ffmpeg -y

# 仅在使用 SO-101 等相应硬件采集、执行时添加:
python -m pip install -e ".[core_scripts,feetech]"
PyTorch、CUDA 和视频解码后端需要与机器平台匹配。先检查 torch.cuda.is_available()、读取一帧视频和加载一个数据样本,再开始长训练。FFmpeg 具体配置及平台支持见同版本安装文档。
后续示例都在同一 LeRobot 工作目录运行。采集、检查数据、训练前,先在当前终端设置数据集命名空间;即使跳过采集、直接使用已有数据,也需要设置它:
export HF_USER="your-hf-username"将占位值替换为数据集所属的用户或组织名。HF_USER 是这些示例自行约定的环境变量,不是登录凭据;新开终端后需重新设置并激活环境。相对路径 outputs/train/... 以启动命令时的工作目录为准,换目录执行时应改用绝对路径。
9.2 示教采集示例
下面假设 SO-101 主从臂已完成电机配置和标定,两个串口分别对应 follower 和 leader;相机 front 是训练、执行都使用的同一个视角。请先替换设备路径与命名空间。
lerobot-record \
  --robot.type=so101_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.id=act_follower \
  --robot.use_degrees=true \
  --robot.cameras='{front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30}}' \
  --teleop.type=so101_leader \
  --teleop.port=/dev/ttyACM1 \
  --teleop.id=act_leader \
  --teleop.use_degrees=true \
  --dataset.repo_id="${HF_USER}/cube_to_box" \
  --dataset.no_stamp=true \
  --dataset.single_task="Pick up the cube and put it in the box" \
  --dataset.fps=30 \
  --dataset.num_episodes=50 \
  --dataset.push_to_hub=false
这里的 50 条是采集计划示例,不是保证学会任务的数量门槛。要覆盖积木初始位置、接近方向与抓取过程中的合理变化,并剔除时间对齐错误、未完成任务等不适合直接作为专家监督的轨迹。上传关闭时数据保存在本地;跨机器训练需要复制数据目录或另行上传。采集教程
--dataset.no_stamp=true 用于保持名称为 cube_to_box,使后续数据检查和训练命令能找到同一份数据。该版本默认会在新建数据集名称后追加日期时间;如果保留默认行为,应把后续命令中的 repo_id 改为实际生成的完整名称。固定命名时,新一轮独立采集应换名;接续原数据集则使用采集入口的 --resume=true,它与训练断点恢复是两种不同操作。数据集命名配置
9.3 检查动作窗口
先读取元数据得到 FPS,再创建带动作窗口的数据集。下面检查首、末两个采样点的形状、有限值和 padding;root=None 使用默认缓存,已有本地目录时将它改为数据根目录即可。示例针对前述 SO-101 的 RGB 相机和一维关节状态,不适用于未经调整的深度图或其他状态表示。
import os
import torch
from lerobot.datasets.dataset_metadata import LeRobotDatasetMetadata
from lerobot.datasets.lerobot_dataset import LeRobotDataset

repo_id = f"{os.environ['HF_USER']}/cube_to_box"
root = None  # 或 "/path/to/cube_to_box"
meta = LeRobotDatasetMetadata(repo_id, root=root)
fps = meta.fps
chunk_size = 100
assert fps > 0, "FPS must be positive"

dataset = LeRobotDataset(
    repo_id,
    root=root,
    delta_timestamps={"action": [i / fps for i in range(chunk_size)]},
)
assert len(dataset) > 0, "Dataset is empty"
print("fps:", fps, "frames:", len(dataset))

for index in sorted({0, len(dataset) - 1}):
    sample = dataset[index]
    actions = sample["action"]
    padding = sample["action_is_pad"]
    state = sample["observation.state"]
    context = f"sample={index}, episode={int(sample['episode_index'])}"
    assert actions.ndim == 2 and actions.shape[0] == chunk_size
    assert actions.shape[1] == meta.features["action"]["shape"][0]
    assert tuple(padding.shape) == (chunk_size,)
    assert padding.dtype == torch.bool, context
    assert state.ndim == 1 and torch.isfinite(state).all(), context
    assert torch.isfinite(actions).all(), context
    # 当前帧有效;向未来连续取样时,padding 只能出现在后缀。
    valid_count = int((~padding).sum())
    assert valid_count >= 1 and not padding[:valid_count].any(), context
    assert padding[valid_count:].all(), context
    if index == len(dataset) - 1:
        assert valid_count == 1, context
    print(context, "state:", state.shape)
    print("actions:", actions.shape, "valid:", valid_count)
    for key in meta.camera_keys:
        image = sample[key]
        assert image.ndim == 3 and image.shape[0] == 3, (context, key)
        assert image.is_floating_point() and torch.isfinite(image).all(), (context, key)
        low, high = image.min().item(), image.max().item()
        assert 0.0 <= low <= high <= 1.0, (context, key, low, high)
print(key, image.shape, image.dtype, "range:", (low, high))这里按索引取到的是帧样本,len(dataset) 也是帧数。对于完整、非空的轨迹,最后一帧在这个从偏移 0 开始的动作窗口中应只剩一个有效动作。首帧能否提供 100 个有效动作,则取决于第一条 episode 是否足够长。此处尚未调用策略的统计归一化处理器,因此 RGB 图像应为 [3,H,W] 浮点张量,值域在 [0,1];归一化后的策略输入不再适用这个值域断言。
padding 断言依据的是本例连续向未来取样的窗口:有效动作在前,越过 episode 末尾的部分在后。读取器会用边界帧填充越界位置,同时将它们标为 padding,不能通过“动作是否重复”判断有效性。窗口与 padding 实现
这两个采样点通过检查后,再扩展到各 episode 的起点、终点和若干中间帧。有限值与形状检查能发现 NaN、Inf 或接口不一致,但无法证明相机时间对齐、动作单位和关节顺序正确;这些仍需回放轨迹并对照采集配置。
这个例子也展示了时间偏移的单位:delta_timestamps 使用秒,action_delta_indices 使用帧索引。不要把 [0, 1, 2] 直接当成三帧的秒偏移传进去。
9.4 启动一个 ACT 训练实验
lerobot-train \
  --dataset.repo_id="${HF_USER}/cube_to_box" \
  --policy.type=act \
  --policy.device=cuda \
  --policy.chunk_size=100 \
  --policy.n_action_steps=20 \
  --policy.push_to_hub=false \
  --batch_size=8 \
  --steps=100000 \
  --output_dir=outputs/train/act_cube_to_box \
  --job_name=act_cube_to_box \
  --wandb.enable=false
这里显式将执行步数改为 20,网络仍然预测并监督 100 步。100000 是实验训练步数示例,不代表收敛保证。首次运行建议先做短程试跑:保留上面的数据与策略参数,将下表对应参数替换为试跑值;试跑完成后,再使用正式实验的参数。
| 参数 | 短程试跑 | 正式实验示例 |
|---|---|---|
--steps | 100 | 100000 |
--output_dir | outputs/train/act_cube_to_box_smoke | outputs/train/act_cube_to_box |
--job_name | act_cube_to_box_smoke | act_cube_to_box |
试跑与正式训练要使用不同的输出目录。 本文版本在非恢复模式下发现输出目录已存在,会直接报错;不必提前创建该目录,也不要为了重试删除需要保留的实验。重复试跑时换一个新的目录名;只有接续同一个中断实验时才使用第 9.6 节的恢复方式。
默认启用 checkpoint 保存,除每隔 save_freq=20000 步保存外,最后一步也会保存,因此正常完成 100 步试跑可以检查保存链路。检查试跑目录下 checkpoints/last/pretrained_model 和 checkpoints/last/training_state 是否生成,并确认 loss 为有限值;这只能验证流程跑通,不能证明策略已学会任务。保存触发逻辑
训练时长取决于相机数量、分辨率、batch、设备与解码吞吐,不能直接套用某个教程里的小时数。
如果使用非默认位置的数据,可补充 --dataset.root=/path/to/cube_to_box。如果需要上传权重,再配置自己的 policy.repo_id、登录凭据和上传选项。上述命令关闭模型上传与 W&B,便于先完成本地实验。训练配置、ACT 训练教程
若要从一开始保存时间集成配置,用下列两项替换命令中的 --policy.n_action_steps=20:
--policy.n_action_steps=1 \
--policy.temporal_ensemble_coeff=0.01
这两项控制推理行为,并不改变 CVAE 的训练目标。对已有权重切换执行模式时,按第 8.1 节先确定配置,再重新构造策略;不要只修改运行中对象的配置字段。
留出验证集,避免只看训练曲线
上面的最小命令用于跑通训练,本身没有开启留出集验证。在本文版本中,可追加:
--dataset.eval_split=0.2 \
--eval_steps=5000
这是追加到 lerobot-train 的参数片段,不是独立命令。数据工厂按任务分组,将每组 episode 列表末尾的 ceil(数量 × 0.2) 条留出,不是随机抽取 20% 的帧。例如同一个任务的 50 条轨迹,默认顺序下会分成前 40 条训练、后 10 条验证。应检查每组样本数,以及采集顺序是否导致验证集过于简单或偏向特定场景。
跨场次泛化需要显式按采集场次划分。留出集用于选择 checkpoint,最终测试集应另行保留;预处理统计量的来源见下一节。划分实现
episode 划分不等于统计量重新拟合
这一点可以从源码明确追踪:数据工厂分别创建训练和验证的 LeRobotDataset,但二者使用相同数据根目录;Metadata 从该目录加载已有 stats.json,episode 筛选本身不重算这些统计量。标准训练随后把 dataset.meta.stats 提供给策略处理器。因此,要区分样本划分和预处理统计量的拟合范围。Metadata 加载
若你的实验要求严格的训练集统计量,应从训练 episode 单独计算并保存统计量,并让训练、验证与部署共同使用这一份;不要分别给验证集和在线观测拟合新的均值。使用固定的 ImageNet 图像统计量时,它的来源又不同于动作和状态统计量,应分开记录。
9.5 使用训练产物执行
新版本真机部署使用 lerobot-rollout。以下 base 策略运行但不录制评估数据;若需逐 episode 保存评估轨迹,应使用该版本的 episodic 策略及其数据集配置。
lerobot-rollout \
  --strategy.type=base \
  --policy.path=outputs/train/act_cube_to_box/checkpoints/last/pretrained_model \
  --device=cuda \
  --robot.type=so101_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.id=act_follower \
  --robot.use_degrees=true \
  --robot.cameras='{front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30}}' \
  --fps=30 \
  --duration=30
先确认 checkpoint 目录存在,并从训练时工作目录运行,或改成绝对路径。执行前检查标定、关节顺序、图像视角、动作量纲与训练一致;首轮在可停止、速度受控的条件下验证动作方向和夹爪行为。
将训练的 30 Hz 动作序列直接以 60 Hz 逐项消费,会把其时间尺度压缩约一半;这与保持 30 Hz 动作时钟、插值生成 60 Hz 指令不同。实际执行还受跟踪和限速约束,应按第 7.5 节分别检查动作消费、网络调用与指令发送频率。部署入口说明
9.6 加载模型与恢复训练有什么区别
部署只需要预测所需的产物;完整断点恢复还依赖训练过程状态。
| 操作 | 需要恢复什么 | 实验含义 |
|---|---|---|
| 部署推理 | 权重、策略配置、前后处理器及统计量 | 在机器人上运行已有策略 |
| 从已有权重开始新实验 | 权重及合适的配置,重新定义训练过程 | 新实验,可使用新的数据与优化设置 |
| 恢复中断训练 | 上述模型信息、步数、优化器、随机数状态;如有则包括调度器 | 从 checkpoint 接续原实验 |
仅把 --policy.path 指向一个模型,不等于完整恢复优化器的动量和训练进度。本文版本可通过 checkpoint 中的训练配置恢复:
lerobot-train \
  --config_path=outputs/train/act_cube_to_box/checkpoints/last/pretrained_model/train_config.json \
  --resume=true
这要求保留完整 checkpoint,不能只复制其中的 pretrained_model 子目录。开始前核对 training_state、模型文件和训练配置都存在;如果原实验已经到达总步数上限,直接恢复不会自动增加训练目标步数。更换数据、batch size 或分布式规模后,也不应再宣称与原实验具有完全相同的采样顺序。Checkpoint 保存与恢复
10. 怎样判断模型真的学会了
离线动作重建误差衡量“给定记录下来的状态,预测与示教多接近”;真机成功率衡量“策略影响后续状态以后,还能否完成任务”。后者包含闭环误差积累,不能由前者替代。
例如,在一段成功示教中,夹爪闭合前已经对准积木。离线验证总是把这幅已对准的观测交给模型;真实执行时,前几步的偏差可能让夹爪停在积木侧面,此时模型面对的是另一幅观测。如果数据中缺少这种偏移后的重新对准过程,即使模型很好地复现了成功轨迹,也可能直接闭合并空抓。这是闭环失败的一种可能机制,需要用失败回放确认,不能仅凭 loss 推断。
比较训练集与留出集时,应在同一个 checkpoint 的 eval() 模式下,使用相同处理器与损失汇总方式计算动作 L1,再结合 rollout 判断。训练日志与验证日志的目标组成、潜变量路径不同,不能直接相减作为泛化差距;具体区别见第 6.4 节。
可以为积木任务提前定义:积木完整进入盒中、机械臂松开夹爪、任务在指定时间内完成,且无人工接管。固定评估初始状态分布,每个 checkpoint 使用可比较的测试条件,并报告试验次数。
| 评估维度 | 建议记录 | 用途 |
|---|---|---|
| 任务结果 | 成功次数 / 总次数、超时、人工接管 | 确认完整任务能力 |
| 泛化范围 | 未见位置、光照、物体变化分组结果 | 区分插值与分布外变化 |
| 执行质量 | 夹爪时机、动作跳变、接触失败阶段 | 定位失败机制 |
| 实时性能 | 推理与控制周期的中位数、P95、超期次数 | 检查是否赶得上动作时钟 |
| 可复现信息 | 代码提交、数据 revision、checkpoint、标定与相机配置 | 支持对比和复盘 |
若只有 10 次评估,8 次成功应写作 8/10,不能仅用“80%”掩盖样本量。原 ACT 项目展示了特定硬件、任务与数据条件下的精细操作结果,它们不是换一套设备或任务后的成功率承诺。原项目实验背景
10.1 用受控对比选择执行方式
对同一个 checkpoint、同一组初始条件,可以先做四组实验:
| 组别 | 设置 | 主要回答的问题 |
|---|---|---|
| A | M=K,不集成 | 完整动作块是否连贯,反馈是否过慢? |
| B | M<K,不集成 | 更频繁的视觉更新能否改善成功率? |
| C | M=1,不集成 | 每步重预测但不融合时,表现如何? |
| D | M=1,开启时间集成 | 相同重预测频率下,融合是否改善平滑性与成功率? |
保持 K、权重、相机和任务分布一致,先比较执行行为;按第 8.1 节为每组配置重新构造策略,并在各 episode 开始前重置状态。B 与 C 用来观察执行前缀缩短的影响,C 与 D 才能较公平地比较时间集成本身。若直接比较 B 与 D,就同时改变了重预测频率和融合方式,无法把收益全部归因于集成。C 比 B 更慢时,应确认是推理调用更频繁,还是数据处理和通信拖慢了周期。只有端到端周期满足要求,模型前向耗时的优化才有实际意义。
之后再分别实验数据覆盖、K 或 kl_weight 等训练因素。这样能区分“模型没有学会”和“执行方式没有用好模型”,也能减少无目的地反复训练。
10.2 把失败记录到具体阶段
每次试验除最终成功与否,还应标记首次失败的阶段。以抓取积木为例,可以提前采用下面的判定规则;规则一旦确定,应在各对照组保持一致。
| 阶段 | 可观察的通过条件 | 未通过时重点回看什么 |
|---|---|---|
| 接近与对准 | 夹爪进入事先规定的抓取区域 | 物体位置、相机视角、动作方向 |
| 闭合与抓住 | 夹爪闭合后确实抓住积木 | 闭合时机、夹爪指令、接触前后的画面 |
| 抬起与移动 | 积木离开台面,并在运输中未掉落 | 跟踪误差、动作衔接、抓持状态 |
| 放置与释放 | 积木完全进入盒内且夹爪释放 | 末端位置、释放时机、结束条件 |
记录可采用一行一个 trial 的表格,至少包含 trial_id、对照组、checkpoint、初始条件编号、成功与否、首次失败阶段、超时与人工接管标记,以及回放文件位置。按初始条件交错运行 A/B/C/D 组,可以减少运行顺序与光照、设备温度等变化重合的影响;每次仍需重新布置场景并重置策略状态。
汇总阶段结果时,区分“全部试验中有多少次走到这里”和“已经到达此阶段的试验中有多少次通过”。例如,假设 20 次试验中 12 次抓住积木,其中 9 次完成放置,则抓取通过率为 12/20,抓住后的放置完成比例为 9/12,完整任务成功率仍是 9/20。这些数字只是统计口径示例;不能用 9/12 替代端到端成功率,也不能把未进入放置阶段的失败忽略掉。
11. 常见问题:先查数据和执行链,再调模型
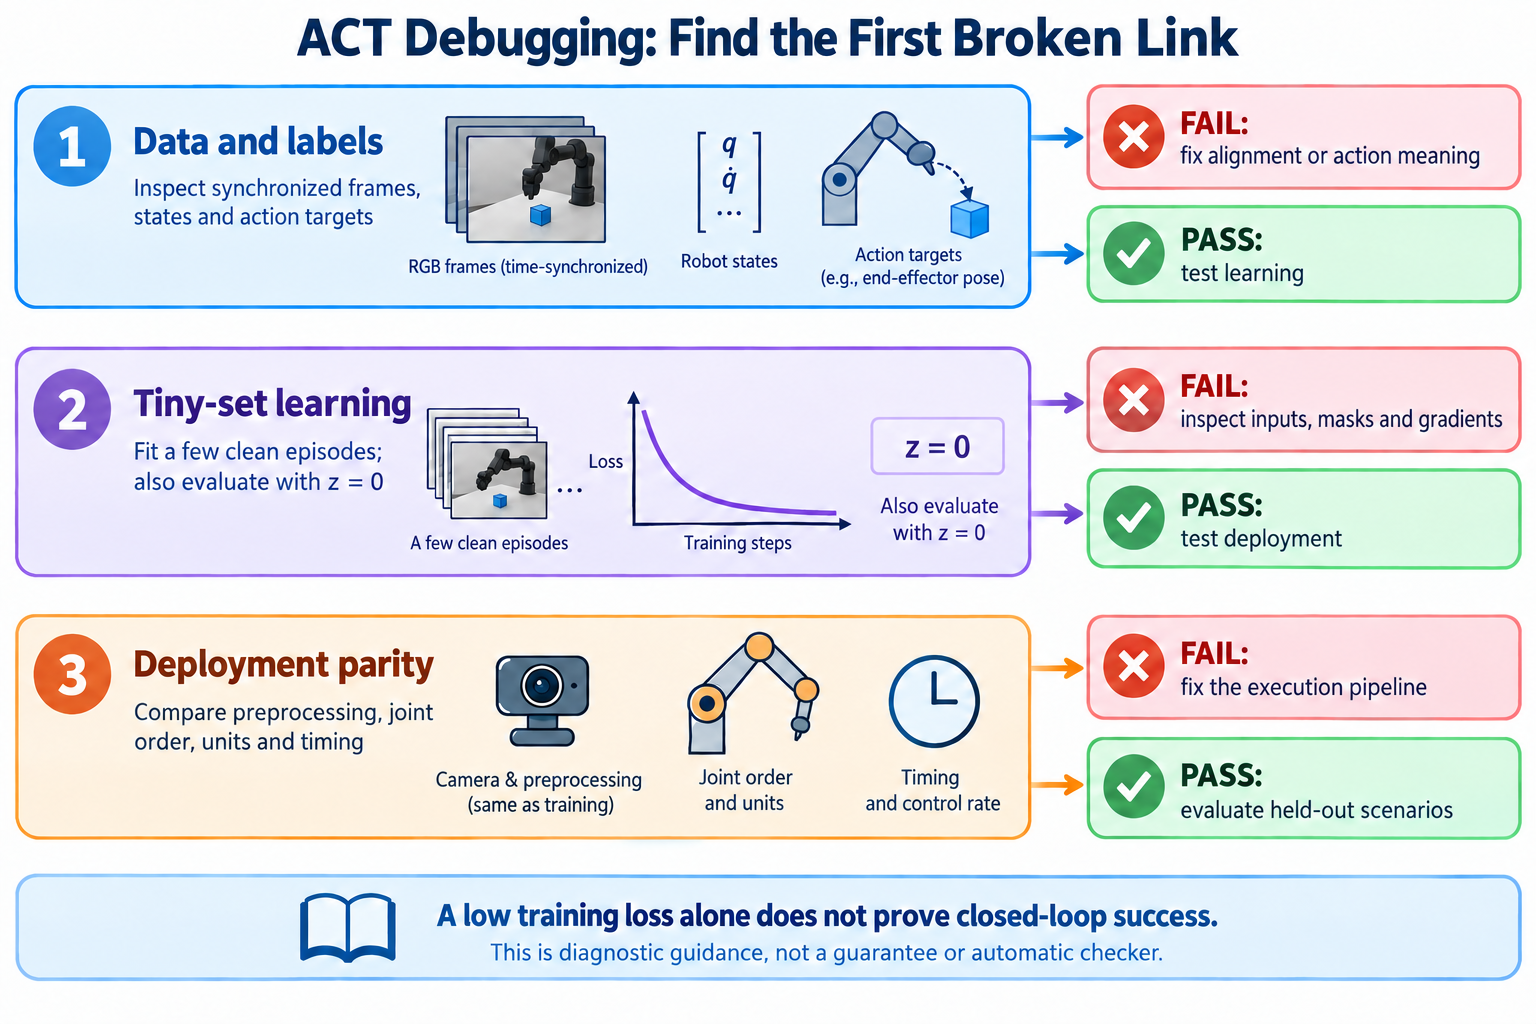
11.1 先做三个小检查
- 检查示教本身。 选择一段完整轨迹,同时观察相机帧、测得状态与下发动作。确认闭合夹爪、抬起物体等事件在三条时间线上对应,而不是只看视频“似乎正常”。
- 检查能否拟合少量干净轨迹。 固定少量 episode,暂时关闭额外随机图像增强,观察训练 L1 是否改善,并在
eval()、z=0下检查同一批观测的输出。如果训练后验下表现很好,z=0下却明显退化,应检查潜变量依赖和输入处理,不能直接宣布训练成功。这个检查用于定位问题,不用于报告泛化性能。 - 对照离线与在线执行链。 将同一份保存的原始观测分别交给离线脚本和部署预处理;以相同权重和配置、
eval()模式、重置后的策略状态,比较预处理张量及反归一化动作。先允许合理的数值精度误差,再检查特征顺序、单位和真实执行周期。如果两边一致但实际任务仍失败,再重点检查闭环状态偏移、数据覆盖和硬件跟踪。
队列模式下,比较动作前必须重置或明确队列状态;否则一次调用可能返回旧队列中的动作,另一次却使用当前观测新预测,结果自然不同。
11.2 根据现象缩小范围
同一现象可能有多种原因,可用右栏的小实验逐项排除。
| 现象 | 优先检查 | 下一步实验 |
|---|---|---|
| loss 下降,但机械臂几乎不动 | 是否把观测状态误当标签;静止片段是否过多 | 对比状态、动作和实际下发目标曲线 |
| 离线误差低,真机运动方向反了 | 关节顺序、单位、标定、反归一化 | 单维小幅指令验证 |
| 每个动作块边界突然跳动 | M 过大,块间预测不连续 | 缩短执行步数;对比时间集成 |
| 物体移动以后很久才反应 | 队列执行时间、视觉延迟、集成权重 | 测量观测时间到执行时间的延迟 |
| 图像能读,但抓取位置总是偏 | 相机视角改变、裁剪变化、时间错位 | 用训练与在线帧做并排对照 |
| 到 episode 末尾行为异常 | padding mask、reset 状态、数据边界 | 检查尾部窗口与 policy.reset() |
| GPU 利用率低、训练等待很多 | 视频解码、磁盘、网络、DataLoader | 分别测量取 batch 与训练一步耗时 |
| KL 很低或很高 | 重建与 KL 比例、归一化尺度 | 结合 L1 和 rollout 做受控对比 |
| 视觉遮挡以后难以恢复 | 单帧观测的歧义、缺少纠错示范 | 增加有效视角、补充恢复轨迹 |
ACT 的能力边界也很清楚:当前实现只有一个观测时间步;没有通过标准输入建立语言理解;动作输出没有自动施加完整的机器人动力学与环境约束。长任务、强部分可观测任务或跨本体任务可能需要记忆、分层策略、额外条件或不同模型,但前提仍是先把当前数据与执行接口验证正确。
12. 源码阅读路线
沿以下入口阅读,可从配置和数据窗口一路追踪到在线执行:
| 顺序 | 文件 | 核心问题 |
|---|---|---|
| 1 | configuration_act.py | 输入窗口、输出窗口、默认值和互斥配置是什么? |
| 2 | factory.py | 策略索引怎样变成以秒为单位的数据窗口? |
| 3 | processor_act.py | 归一化与反归一化发生在哪里? |
| 4 | modeling_act.py | 训练、预测整块、选择单步动作各走哪条路径? |
| 5 | lerobot_train.py | 数据、策略、优化器与 checkpoint 怎样连接? |
| 6 | lerobot_rollout.py | 模型与机器人怎样进入实际控制循环? |
在 modeling_act.py 内,可以再沿 ACTPolicy.forward → ACT.forward → ACTPolicy.select_action → ACTTemporalEnsembler.update 阅读。特别留意 self.training、action_is_pad、_action_queue 和 temporal_ensemble_coeff,它们决定了训练与部署之间最关键的差别。固定版本源码目录
阅读自测与验收
K=100、M=20分别改变什么? 前者决定预测与监督窗口,后者决定队列模式每次重预测前执行的步数。- CVAE 训练看到了未来动作,推理为什么不需要? 真实动作参与训练后验与重建监督;标准推理去掉后验编码器并使用
z=0。 - 时间集成在平均哪些动作? 不同观测时刻生成、但指向同一执行时刻的动作预测。
- 正的时间集成系数偏重哪一端? 在本文核对的实现中,偏重较早生成的预测。
- 为什么不能只保存权重? 模型还依赖输入输出配置、归一化统计量、Processor 与硬件语义。
- 什么时候可以说实验链路已跑通? 数据窗口正确、训练产物可重载、在线动作语义一致,并在约定的初始条件和成功标准下完成了实际评估。
参考资料
- LeRobot 官方仓库:项目范围与入口。
- 本文核对的 LeRobot 提交:所有版本敏感实现的依据。
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware:Zhao 等人的 ACT 原论文,RSS 2023。
- ALOHA / ACT 项目页:硬件背景与任务演示。
- 原始 ACT 实现:与 LeRobot 实现对照阅读。
- LeRobot ACT 文档:持续更新的使用指南,执行命令时需核对本地版本。