大模型分布式训练与显存优化指南:从 DDP、ZeRO 到 FSDP
本文目录 展开章节导航
一个 1B 模型,BF16 权重只有 2 GB,为什么训练时仍可能占用十几 GB,甚至在第一次 optimizer.step() 才 OOM?因为权重只是训练状态的一部分,激活、梯度、优化器状态和通信缓冲会在不同阶段分配与释放。
本文围绕两个问题展开:每张 GPU 此刻持有什么,以及下一次通信为什么发生。 先用同一份 1B 显存账本比较 DDP 与 ZeRO,再沿集合通信理解 FSDP,最后定位实际训练峰值。
阅读路线
| 你遇到的问题 | 先读哪里 | 要得到的判断 |
|---|---|---|
| 不知道需要多少显存 | 第 1~3 节:显存账本 | 区分模型状态下限与实际峰值 |
| 多卡后梯度或 Loss 尺度变了 | 第 4 节:DDP 与累积 | 核对采样、同步和归一化 |
| ZeRO/FSDP 能运行但很慢 | 第 5~7 节:通信与分片、第 10 节:重叠 | 找到参数聚合和暴露通信的代价 |
| 仍然 OOM 或保存时失败 | 第 8~11 节:精度、激活与排错 | 按发生阶段定位新增分配 |
| 需要确定落地顺序 | 第 12 节:选型与配置 | 每次只改变一个变量并验证恢复能力 |
本文的 Python 分布式接口以 PyTorch 2.8 文档为基线,FSDP1 与 FSDP2 分开说明。显存与通信数字是条件明确的理论算例;DDP/FSDP 代码用于展示训练结构,实际容量和吞吐仍需在目标硬件测量。
1. 先建立训练显存账本
先统计同一时刻存活、且没有重复计算底层存储的显存,再沿训练过程取最大值:
各项的峰值未必同时发生,因此“各项最大值之和”通常只是保守估算。分配器保留空间与 CUDA/NCCL 等额外开销还需单独统计;reserved 已包含其中的活跃 Tensor,不能再与 allocated 相加。
| 符号 | 项目 | 生命周期 | 主要影响因素 |
|---|---|---|---|
P | Parameters,参数 | 长期存在 | 参数量、参数 dtype、是否分片/量化 |
G | Gradients,梯度 | 反向到 optimizer step | 梯度 dtype、是否分片、是否用 bucket view |
O | Optimizer States,优化器状态 | 长期存在 | 优化器类型、master weight、状态精度、是否分片 |
A | Activations,激活值 | 前向保存到反向消费 | Batch、序列长度、层数、隐藏维、Checkpointing |
T | Temporaries,临时张量 | 某些算子期间达到峰值 | Attention、logits、融合算子、cuBLAS workspace |
C | Communication Buffers,通信缓冲 | Collective 前后 | bucket 大小、All-Gather 预取、并发 Collective |
F | Fragmentation/Allocator,碎片与保留空间 | 动态变化 | 动态 shape、分配顺序、缓存分配器 |
ZeRO/FSDP 主要减少 P/G/O 的冗余,不会自动消除激活、临时张量或碎片。模型状态已经能放下但仍 OOM,通常要继续检查 A/T/C/F。例如 gradient_as_bucket_view=True 让梯度引用通信桶中的存储,做账时应计一次,不能同时算一份完整梯度和一份相同大小的独立桶。
1.1 通用计算公式
若参数量为 N,每个元素 b bit:
这里使用十进制 GB;1 GiB = 2³⁰ Byte,因此操作系统或监控工具显示的数字可能略有差异。
2. 分布式训练的基本坐标系
| 术语 | 含义 | 例子 |
|---|---|---|
| Process | 独立训练进程 | DDP 通常每张 GPU 一个进程 |
| Rank | 进程在指定通信组中的编号 | 默认组为全局 Rank;子组还有组内 Rank |
| Local Rank | 当前节点内的进程编号 | 每 GPU 一个进程时,通常映射到可见设备 0…7 |
| World Size | 默认通信组的总进程数 | 2 节点 × 8 GPU = 16 |
| Process Group | 一组参与同一 Collective 的 Rank | DP、TP、PP 可使用不同通信组 |
| Node | 一台服务器 | 节点内常有 NVLink,节点间常用 InfiniBand/RoCE |
rank 不是 GPU 编号,local_rank 才通常用于选择本机 CUDA device。多维并行时,同一个 Rank 可能同时属于一个数据并行组、一个张量并行组和一个流水线组。
2.1 三个不同的数量:总进程、数据并行与分片
本文的简单显存公式默认所有 GPU 都参与同一个数据并行组。组合并行后,应分别记录:
| 数量 | 含义 | 出现在哪个公式 |
|---|---|---|
| 总进程数 | 启动的全部进程 | 启动进程与通信拓扑 |
| 数据并行度 | 处理不同批次的数据副本数 | Global batch 的计算 |
| 分片组大小 | 共同保存一份状态的进程数 | 状态分片账本中的除数 |
例如,16 个进程组成 2 路 Tensor Parallel × 8 路 Data Parallel;其中 DP 维再分为 2 路复制 × 4 路分片,则:
- ,,。
- 每个 TP 组的两个进程协同处理同一批数据,不能算两份独立样本。
- 若每个数据副本的 micro-batch 为 2、累积 4 次,则 global batch 为 。
- 计算每卡持久状态时,应先取 TP 切分后的本地参数与状态规模,再按 4 路分片计算;复制维不会继续把每卡状态除以 2。
在 PyTorch 2.8 的 FSDP2 二维 DP mesh 中,维度顺序是复制在前、分片在后;上例对应 DP 子网格 (2,4),TP 维另行组合。FSDP2 mesh 定义
实际 TP 中部分参数可能复制、部分切分,不能假设所有状态都恰好除以 TP 度数。后面的显存估算器用于单一分片组;只有纯全分片 DP 时,其参数名 world_size 才同时等于总进程数、数据并行度与分片度。
3. 1B 模型到底占多少显存
1B = 10⁹ 个参数。只加载一份权重时:
| dtype | 每参数 Byte | 1B 参数大小 |
|---|---|---|
| FP32 | 4 | 4 GB |
| BF16 / FP16 | 2 | 2 GB |
| FP8 / INT8 | 1 | 1 GB(仅理论原始数据,不含缩放元数据) |
按上述十进制单位计算:
3.1 Adam 的 m、v 为什么是 8 GB
Adam 为每个参数维护一阶矩 m 和二阶矩 v。二者若均为 FP32:
对当前梯度 gₜ,Adam 的核心状态更新为:
| 状态 | 数学意义 | 直觉作用 |
|---|---|---|
m / exp_avg | 梯度的一阶矩指数滑动平均 | 平滑梯度方向,形成类似 Momentum 的惯性 |
v / exp_avg_sq | 梯度平方的二阶原始矩指数滑动平均 | 估计每个参数的梯度尺度,自适应调节步长 |
v 经常被简称为“方差”,但严格说它是 未中心化二阶矩,因为没有减去梯度均值。两个状态从 0 初始化,早期会偏小,所以 Adam 使用 Bias Correction:
忽略 Weight Decay 时,参数更新近似为:
因此 m 提供主要更新方向,sqrt(v) 按历史梯度幅度归一化每个参数的步长,ε 防止除零。AdamW 则把 Weight Decay 从梯度更新中解耦。m、v 都与参数形状相同;若均用 FP32,每个参数额外需要 4+4=8 Byte。
但 8 GB 只是 m+v。一种常见的 BF16 混合精度 Adam 账本是:
| 状态 | dtype | 1B 大小 |
|---|---|---|
| 低精度模型参数 | BF16 | 2 GB |
| 梯度 | BF16 | 2 GB |
| FP32 master parameters | FP32 | 4 GB |
Adam m | FP32 | 4 GB |
Adam v | FP32 | 4 GB |
| 合计 | — | 16 GB |
在这份账本中,若仅将梯度改为 FP32,合计变为 18 GB;若仅移除独立 master copy,则少 4 GB。但不能只看总数判断实现:FP32 参数 + FP32 梯度 + FP32 m/v 同样是 16 GB,这时 FP32 参数本身就是优化器更新的权重,不应再重复加一份 master copy。
autocast 选择算子的计算精度,并不会自动把持久参数全部改为 BF16。先按第 8.3 节检查实际 dtype,再选择估算器的字节参数。
3.2 可运行的显存估算器
def model_state_gb(
    params_billion: float,
    world_size: int,
    param_bytes=2,
    grad_bytes=2,
    master_bytes=4,
    adam_m_bytes=4,
    adam_v_bytes=4,
):
    """只估算持久模型状态;不含激活、临时张量、通信 buffer 和碎片。"""
    import math
    if isinstance(world_size, bool) or not isinstance(world_size, int) or world_size <= 0:
        raise ValueError("world_size must be a positive integer")
    values = (params_billion, param_bytes, grad_bytes, master_bytes, adam_m_bytes, adam_v_bytes)
    if any(not math.isfinite(value) or value < 0 for value in values):
        raise ValueError("parameter count and byte sizes must be finite and nonnegative")
    n = params_billion * 1e9
    P = n * param_bytes / 1e9
    G = n * grad_bytes / 1e9
    O = n * (master_bytes + adam_m_bytes + adam_v_bytes) / 1e9
    K = world_size
    return {
        "DDP": P + G + O,
        "ZeRO-1": P + G + O / K,
        "ZeRO-2": P + (G + O) / K,
        "ZeRO-3/FULL_SHARD lower bound": (P + G + O) / K,
    }


for mode, gb in model_state_gb(1, world_size=8).items():
    print(f"{mode:30s} {gb:5.2f} GB/GPU")
在上述假设和 8 张 GPU 下,理论持久状态约为 DDP 16 GB、ZeRO-1 5.5 GB、ZeRO-2 3.75 GB、ZeRO-3 2 GB/GPU。ZeRO-3/FSDP 计算时仍会临时 All-Gather 当前模块参数,所以 2 GB 不是实际峰值。
下面的完整代码把上述结果画成堆叠柱状图。它与正文使用同一组字节假设,运行后生成 assets/zero-memory-comparison.png(从本文页面包目录运行):
python -m pip install matplotlib numpyfrom pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
world_size = 8
P, G, O = 2.0, 2.0, 12.0 # 1B: BF16 参数、BF16 梯度、FP32 master+m+v
labels = ["DDP", "ZeRO-1", "ZeRO-2", "ZeRO-3"]
parameters = np.array([P, P, P, P / world_size])
gradients = np.array([G, G, G / world_size, G / world_size])
optimizer = np.array([O, O / world_size, O / world_size, O / world_size])
fig, ax = plt.subplots(figsize=(9, 5))
ax.bar(labels, parameters, label="Parameters", color="#3b82f6")
ax.bar(labels, gradients, bottom=parameters, label="Gradients", color="#f97360")
ax.bar(
labels,
optimizer,
bottom=parameters + gradients,
label="Optimizer states",
color="#8b5cf6",
)
totals = parameters + gradients + optimizer
for index, total in enumerate(totals):
ax.text(index, total + 0.25, f"{total:.2f} GB", ha="center")
ax.set_ylabel("Persistent model-state memory per GPU (GB)")
ax.set_title("1B parameters, BF16 params/grads, FP32 Adam, 8 GPUs")
ax.legend()
ax.set_ylim(0, totals.max() * 1.12)
fig.tight_layout()
output = Path("assets/zero-memory-comparison.png")
output.parent.mkdir(parents=True, exist_ok=True)
fig.savefig(output, dpi=180, bbox_inches="tight")
print(f"saved: {output.resolve()}")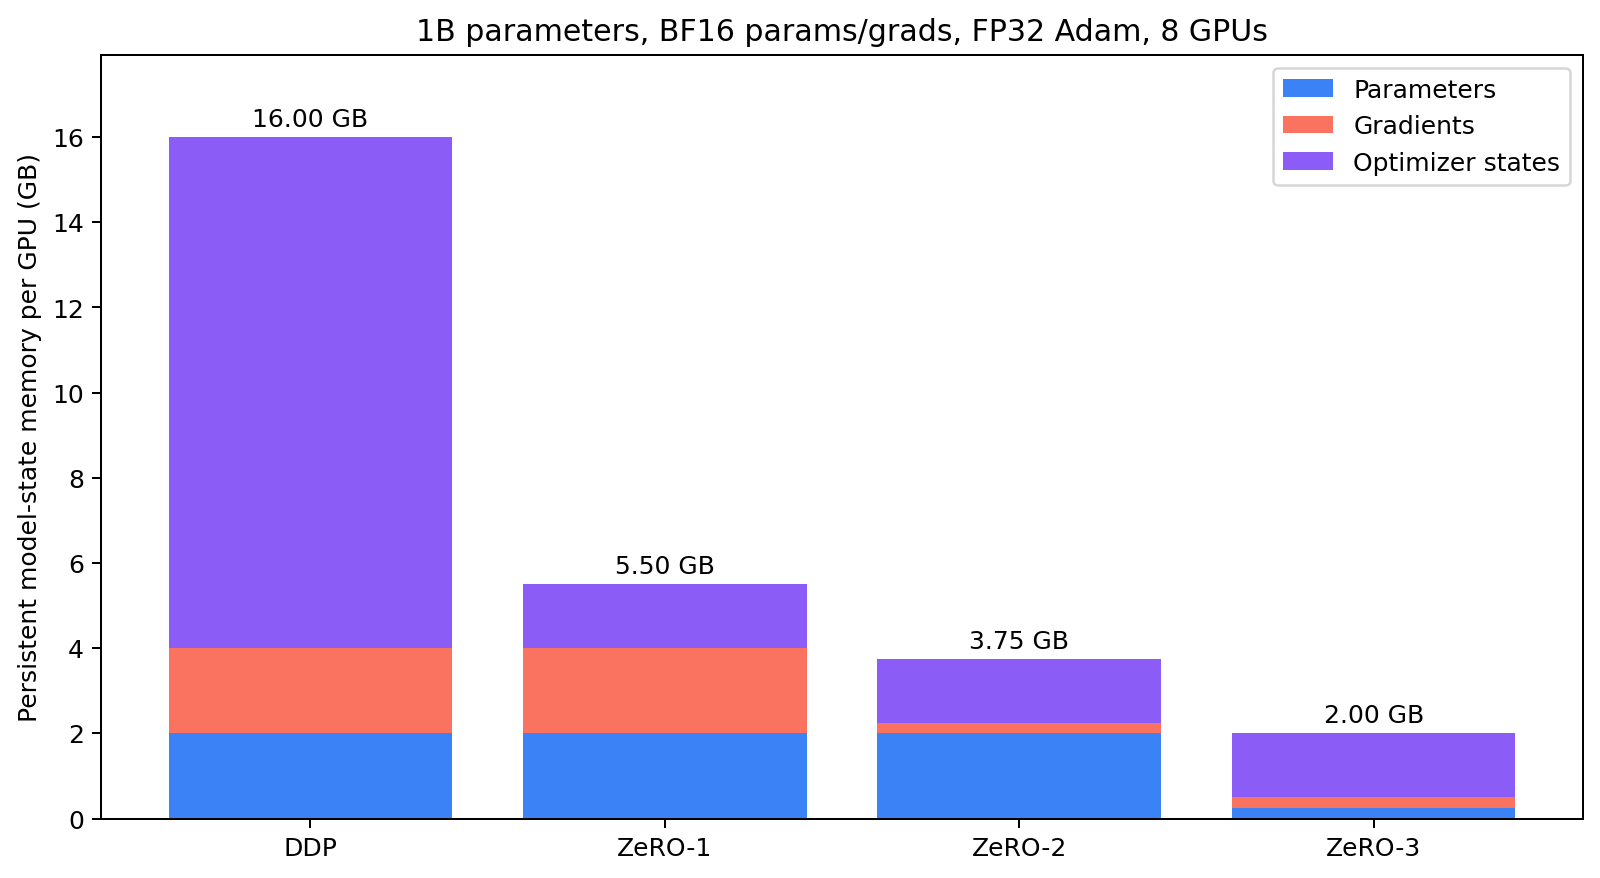
3.3 理论下限、稳态与峰值不是同一个数
- 理论下限:只把
P/G/O按公式分片后的总和。 - 稳态显存曲线:初始化与优化器状态创建完成后,每个 step 内重复出现的分配/释放过程;它不是一条固定水平线。
- 峰值显存:某一瞬间同时存在旧张量、新张量、预取参数和算子 workspace。
容量规划要看峰值,优化效果要同时报告 max_memory_allocated 与 max_memory_reserved。只用 nvidia-smi 的单个时刻或只报 ZeRO 理论公式,都不足以说明任务能否稳定运行。
3.4 部分微调:冻结参数后还剩哪些显存
前面的估算器假设所有参数都训练。若只训练投影层、部分 Transformer 层或 LoRA 参数,应分别统计总参数量 与可训练参数量 。在未分片、未量化、未卸载的前提下:
其中 的单位为 Byte/element,总参数量包含新增适配器。假设总量 1B、其中 10M 可训练,所有权重存为 BF16,可训练部分按第 3.1 节的 BF16 梯度与 FP32 master/m/v 计:
比全参数训练的 16 GB 小很多,但仍要保存完整的 2 GB 权重;激活与临时张量也需另算。若训练参数用 FP32、基座量化,或框架保留不同 dtype 的副本,应重新填写每项字节数。
在设置冻结策略后再构造优化器,例如 AdamW(p for p in model.parameters() if p.requires_grad)。若从全参数训练中途切换为冻结,已有 optimizer state 不会因为改了 requires_grad 就自动消失。
冻结参数与切断计算图是两种操作。 一个冻结模块若位于可训练模块之后,仍需把梯度传回上游。下面的 CPU 例子中,后层权重固定为 [1,2],前层仍得到梯度:
import torch

projector = torch.nn.Linear(2, 2, bias=False)
frozen_head = torch.nn.Linear(2, 1, bias=False)
with torch.no_grad():
    projector.weight.copy_(torch.eye(2))
    frozen_head.weight.copy_(torch.tensor([[1.0, 2.0]]))
frozen_head.requires_grad_(False)

features = projector(torch.tensor([[1.0, 1.0]]))
loss = frozen_head(features).sum()
loss.backward()
print(projector.weight.grad)  # tensor([[1., 1.], [2., 2.]])
print(frozen_head.weight.grad)  # None
若把 frozen_head(features) 包进 torch.no_grad(),就会切断传回 projector 的路径。model.eval() 只改变 Dropout/BatchNorm 等模块的行为,也不等于关闭梯度。PyTorch 梯度控制说明
4. DP 与 DDP
4.1 Data Parallel(DP)
经典数据并行的逻辑是:每个设备拿到不同 mini-batch 分片,运行相同模型,然后同步梯度。PyTorch nn.DataParallel 是单进程多线程实现,通常由主设备负责 scatter/gather,容易形成单进程和主 GPU 瓶颈;多 GPU 训练一般优先使用 DDP。
4.2 DistributedDataParallel(DDP)
DDP 通常是一张 GPU 对应一个进程和一个 Rank:
- 每个 Rank 保存完整参数、梯度和优化器状态。
- 显式配置 DistributedSampler 等采样方案,给各 Rank 分配数据。
- 各 Rank 独立前向、反向。
- 梯度 Bucket 就绪后执行 All-Reduce。
- 每个 Rank 用相同的同步梯度执行相同 optimizer step。
DDP 不会在每一步广播新参数;参数副本之所以保持一致,是因为初始参数一致、归约后的梯度一致、优化器更新也一致。DDP 本身不切分输入;缓冲区是否广播也应与参数同步区分。
# torchrun --standalone --nproc_per_node=8 train_ddp.py
import os
import torch
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel as DDP

local_rank = int(os.environ["LOCAL_RANK"])
torch.cuda.set_device(local_rank)
dist.init_process_group(backend="nccl")

model = MyModel().to(local_rank)  # 替换为实际模型
model = DDP(model, device_ids=[local_rank], gradient_as_bucket_view=True)
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)

from torch.utils.data import DataLoader, DistributedSampler

# dataset、criterion、epochs 由任务提供;显式丢弃尾部以保持 batch 大小一致。
sampler = DistributedSampler(dataset, shuffle=True, drop_last=True)
loader = DataLoader(dataset, batch_size=8, sampler=sampler, drop_last=True)
for epoch in range(epochs):
    sampler.set_epoch(epoch)
    for inputs, targets in loader:
        inputs, targets = inputs.to(local_rank), targets.to(local_rank)
        optimizer.zero_grad(set_to_none=True)
        loss = criterion(model(inputs), targets)
        loss.backward()   # DDP hook 按 bucket 触发梯度 All-Reduce
        optimizer.step()

dist.destroy_process_group()
全局 Batch Size 通常为:
其中 K 是第 2.1 节的 K_DP,N_accum 是梯度累积步数。改变 GPU 数量时,先检查 global batch 与总训练 token 数是否改变,再决定学习率和 Scheduler 是否需要调整。
4.3 梯度累积:同步边界与 Loss 分母一起检查
DDP 可在非最后一个 micro-step 使用 no_sync(),在累积边界同步。前向和反向都必须位于该上下文内;只包住 backward() 仍可能触发同步。PyTorch 2.8 DDP 文档
下面替换上例一个 epoch 内的循环。假设各 Rank 的 loader 长度相同,每个 micro-batch 包含相同数量的有效样本或有效 token;最后不足 accum_steps 的窗口也会执行更新:
from contextlib import nullcontext

accum_steps = 4
num_batches = len(loader)
optimizer.zero_grad(set_to_none=True)
for step, (inputs, targets) in enumerate(loader):
    window_start = (step // accum_steps) * accum_steps
    window_size = min(accum_steps, num_batches - window_start)
    sync_now = (step + 1 == window_start + window_size)
    context = nullcontext() if sync_now else model.no_sync()
    with context:
        inputs, targets = inputs.to(local_rank), targets.to(local_rank)
        loss = criterion(model(inputs), targets) / window_size
        loss.backward()
    if sync_now:
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
例如一轮有 10 个 micro-batch、累积 4 次,应按 4、4、2 分组,最后一组除以 2。若仍除以 4,该次更新的梯度会缩小一半。Scheduler 若按 optimizer step 推进,也应放在更新边界,而不是每个 micro-step 调用。
4.4 变长文本:平均局部均值未必等于全局 token 均值
若 Rank 0 有 100 个有效答案 token,Rank 1 有 300 个,分别计算本地 mean 再由 DDP 平均,会让两组各占一半权重;全局 token mean 应给它们 与 的权重。
设一个累积窗口中,第 个 Rank、第 个 micro-batch 的有效 token 数为 ,token loss 之和为 。目标是:
在默认 DDP 按 个数据并行 Rank 平均梯度的条件下,每次反向应使用 ,并在窗口末尾同步。分母必须提前从整个窗口的有效标签数汇总,排除 padding 与 ignore_index,且整个窗口的 ;此时不要再除以累积步数。这里由目标函数推导权重,使用自定义通信 hook 或其他 Loss 归约方式时需要重新推导。
这与 InternVL 的 Square averaging回答的是同一个问题:训练究竟希望每个 token 等权,还是每个样本按另一种规则加权?先确定目标,再决定分母。
4.5 验证集:补齐样本会改变指标分母
第 4.2 节为了展示等长训练循环,在 Sampler 和 DataLoader 都使用了 drop_last=True:前者丢弃不能均分到各 Rank 的尾部索引,后者丢弃各 Rank 上不满一个 batch 的尾部。验证集通常希望保留全部样本,不能直接照搬。
但仅把两处都改为 False 仍需留意:DistributedSampler 会补充索引,使各 Rank 样本数相同。下面只在 CPU 上查看分配结果,无需启动进程组:PyTorch 2.8 Sampler 规则
from torch.utils.data import DistributedSampler

dataset = list(range(5))
for rank in range(2):
    sampler = DistributedSampler(
        dataset, num_replicas=2, rank=rank,
        shuffle=False, drop_last=False,
    )
    print(rank, list(sampler))
# 0 [0, 2, 4]
# 1 [1, 3, 0]
原本 5 个样本变成 6 次评测,样本 0 出现两次。假设仅样本 4 预测错误,原始准确率是 4/5=80%,直接统计补齐结果却得到 5/6≈83.3%。
可按唯一样本 ID 汇总、去掉仅为补齐而产生的重复项,再计算指标;也可给补齐项设置指标 mask。对于可加性指标,先汇总有效分子与分母,再相除;F1、AUROC 等应按各自定义合并所需统计或预测,不能直接平均每卡得分。采用不补齐的验证切分时,各 Rank 循环长度可能不同,仍需保证 DDP 缓冲同步、FSDP 参数聚合等 Collective 的调用顺序一致。
5. NCCL 与集合通信
NCCL(NVIDIA Collective Communications Library)是面向 NVIDIA GPU 的集合通信库。它负责高效执行 All-Reduce、All-Gather、Reduce-Scatter、Broadcast 等原语;DDP/FSDP 是训练策略,NCCL 是它们常用的通信后端,不要把两者视作同一层组件。
5.1 All-Reduce:求和还是平均
All-Reduce 本身执行 SUM/MAX/MIN 等归约。DDP 的最终梯度语义通常是跨 Rank 平均,但“求和后除以 world size”的具体位置由框架实现处理。假设两张 GPU 的局部梯度分别为 g₀、g₁:
不要在 DDP 已经平均后再次手动除以 world_size。还要区分 loss 在本地 batch 上是 mean 还是 sum,否则很容易得到多除或少除的梯度尺度。
5.2 集合通信如何改变数据所有权
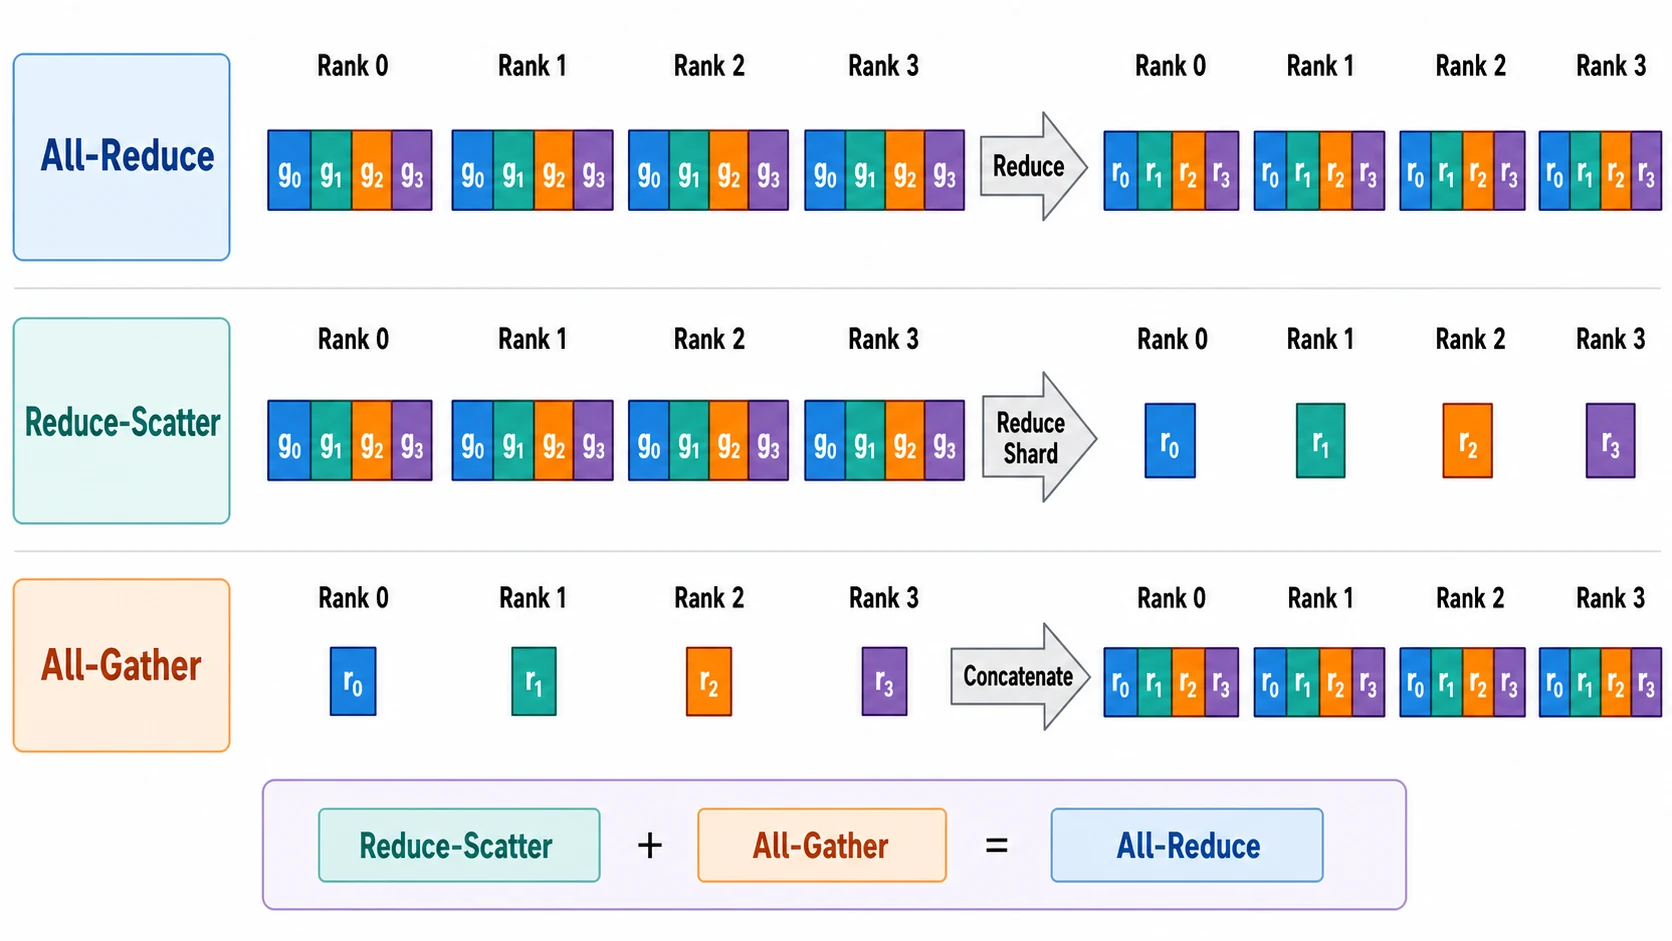
| 原语 | 每个 Rank 输入 | 每个 Rank 输出 | 典型用途 |
|---|---|---|---|
| All-Reduce | 完整张量 | 相同的完整归约张量 | DDP 梯度同步 |
| Reduce-Scatter | 完整张量 | 不同的归约分片 | ZeRO/FSDP 梯度归约并分片 |
| All-Gather | 不同分片 | 相同的完整拼接张量 | FSDP 计算前还原参数 |
| All-to-All | 发往各 Rank 的不同分块 | 来自各 Rank 的不同分块 | MoE Token 路由 |
Broadcast:一份数据复制给所有 Rank
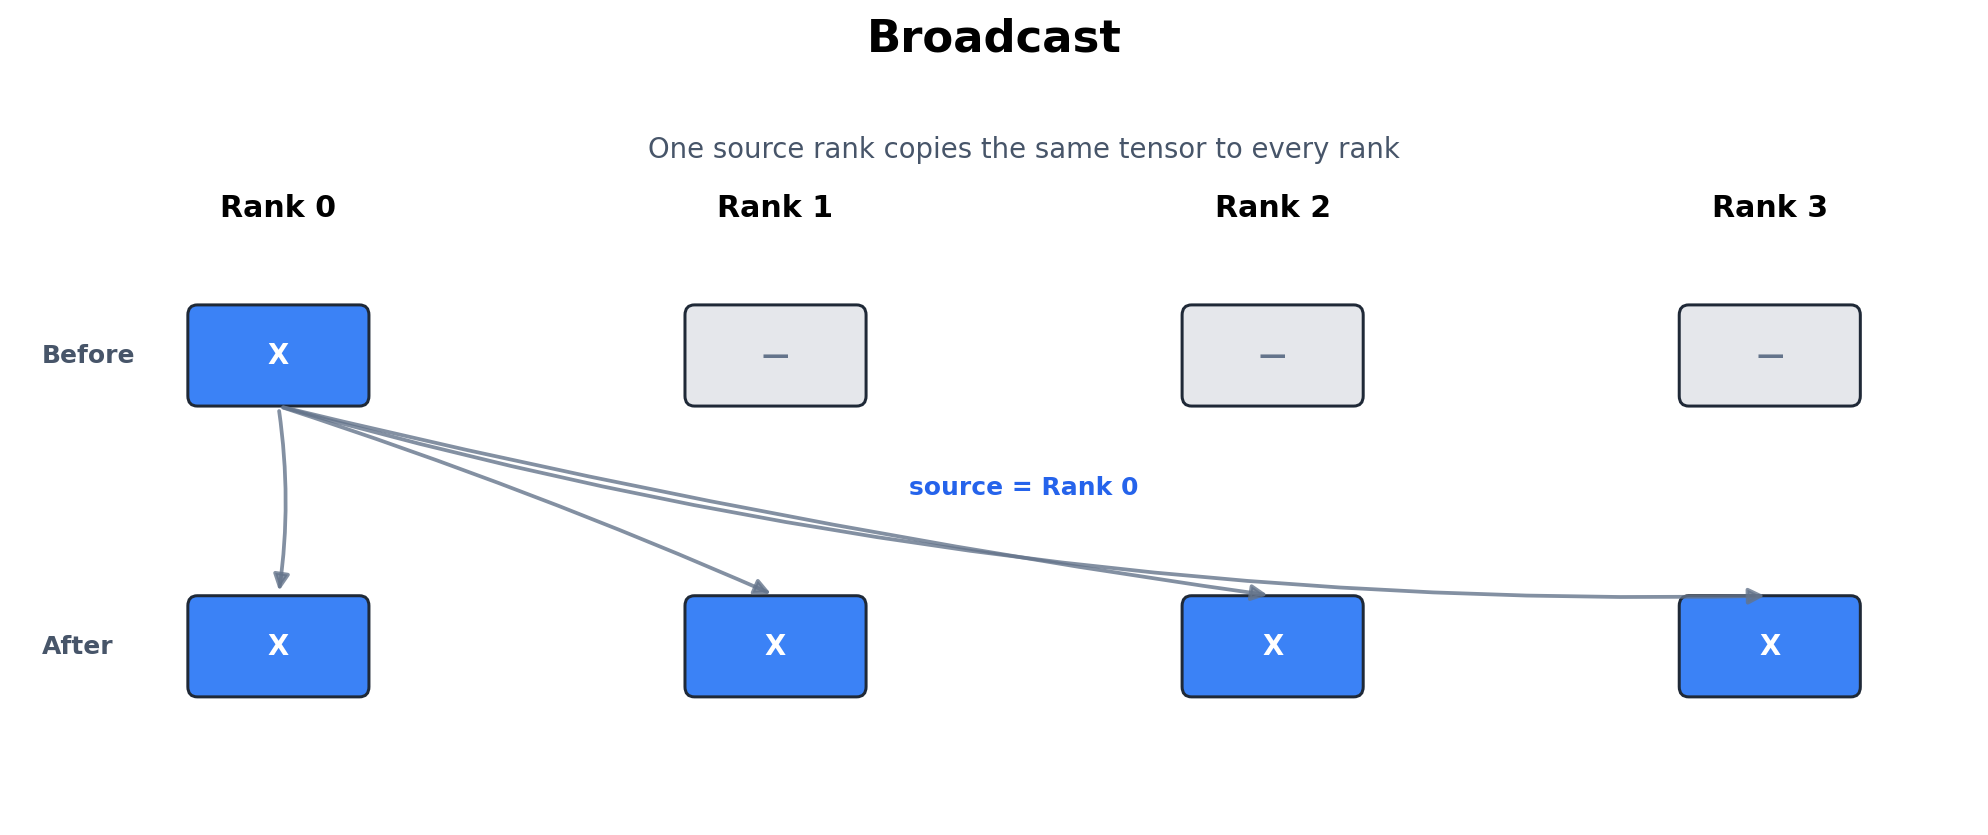
常用于同步初始化参数、配置或控制信息。在 PyTorch 中,src 使用的是全局 Rank,即使传入了子通信组;PyTorch 2.8 的 group_src 才表示组内 Rank,二者不能同时指定。例如子组由全局 Rank [4,5,6,7] 构成,要从该组第一个进程广播,可写 src=4 或 group_src=0。组成员参与广播;建组还需遵守全局一致的创建顺序。broadcast 的 Rank 语义
All-Gather:分片拼成完整张量
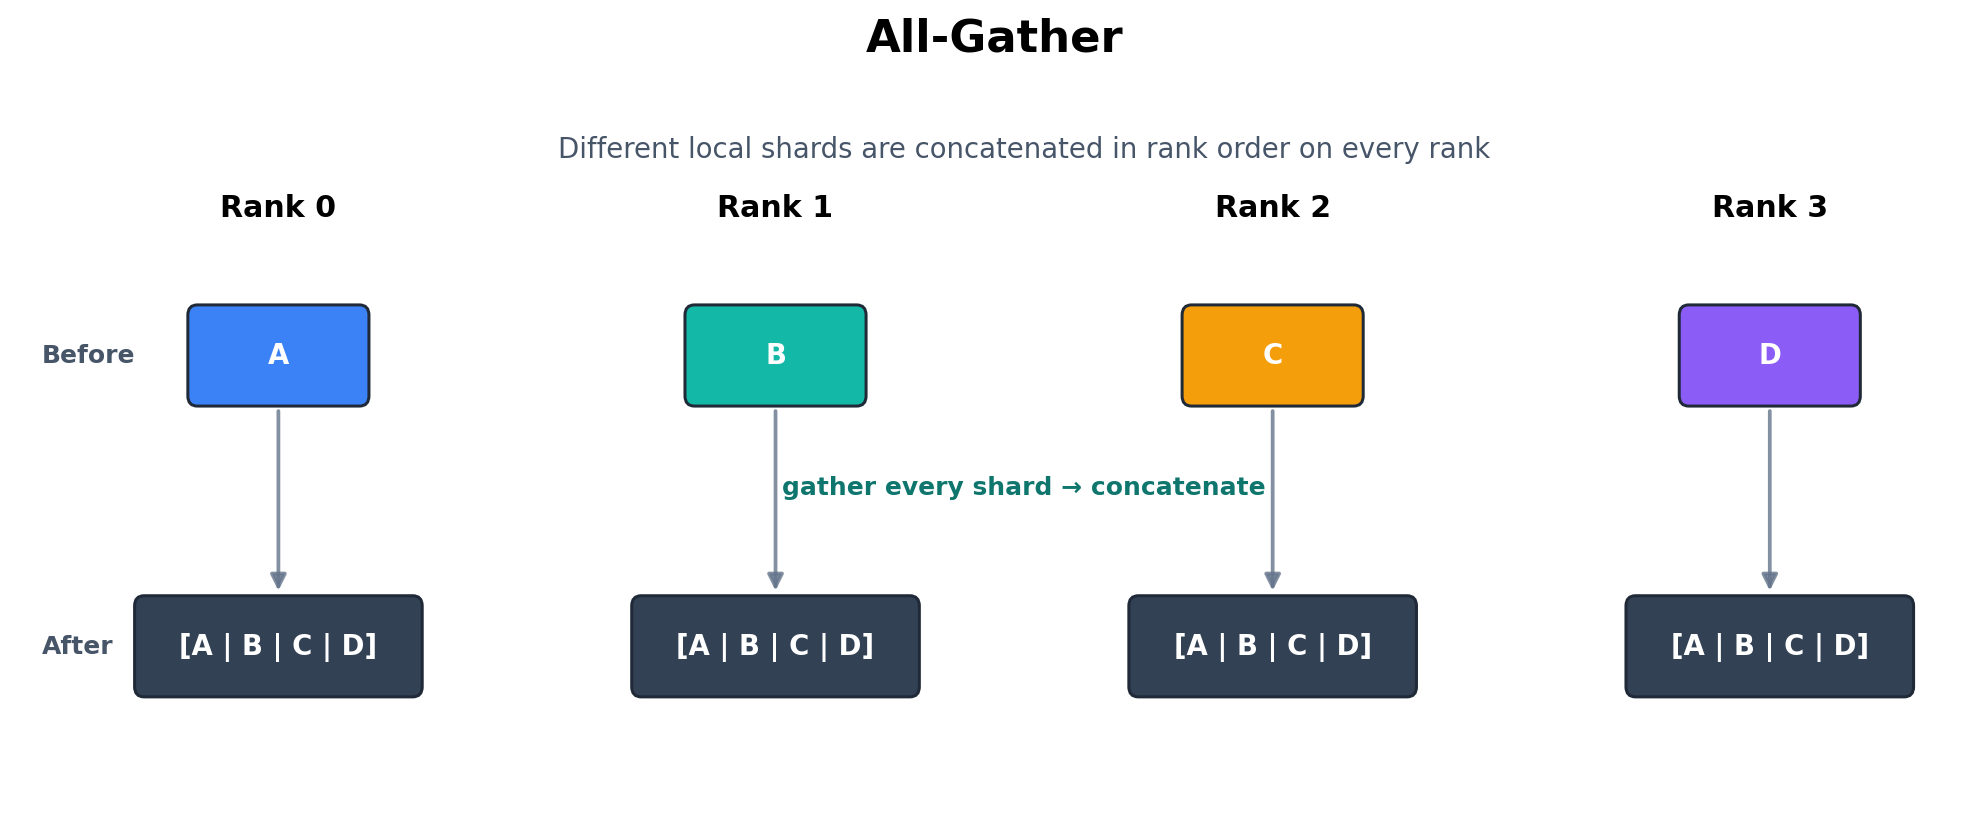
All-Gather 不做数值归约,只做收集和拼接。若每 Rank 输入 M/K,操作后每 Rank 输出约 M,因此会产生显著的瞬时完整参数峰值。
Reduce-Scatter:先归约,再分发结果分片
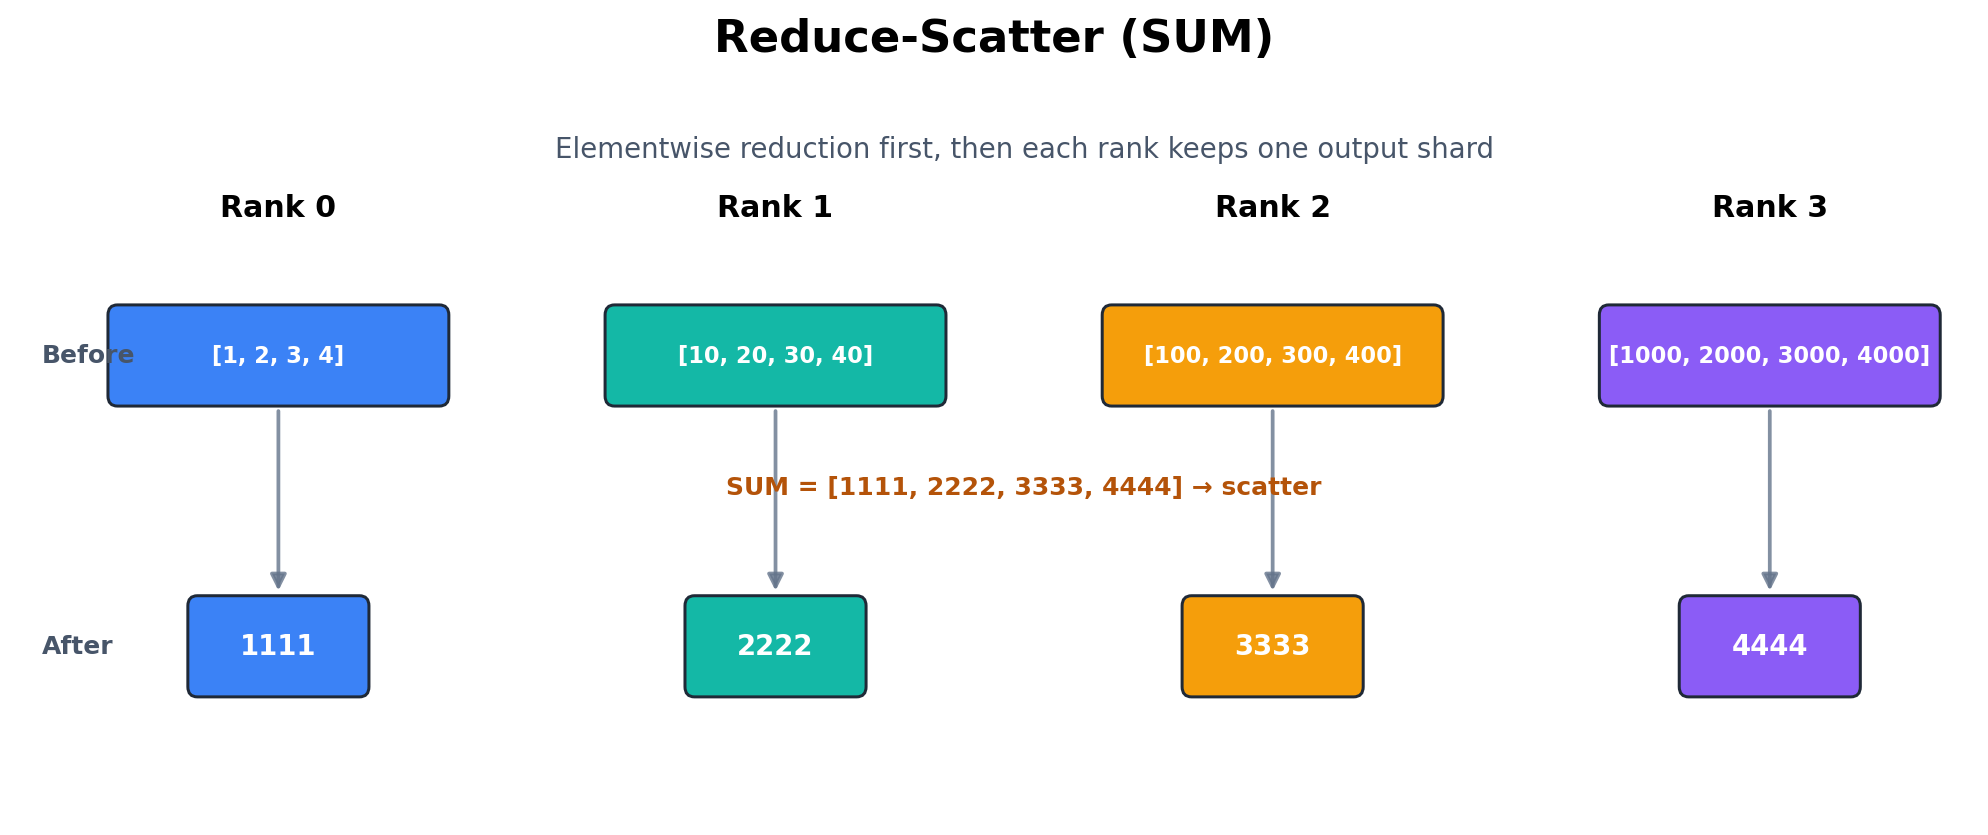
Reduce-Scatter 同时完成 Reduction 和 Sharding。它非常适合 FSDP/ZeRO 梯度:每个 Rank 不需要保留完整归约梯度,只保留与本地参数 shard 对应的部分。
All-Reduce:每个 Rank 都得到完整归约结果
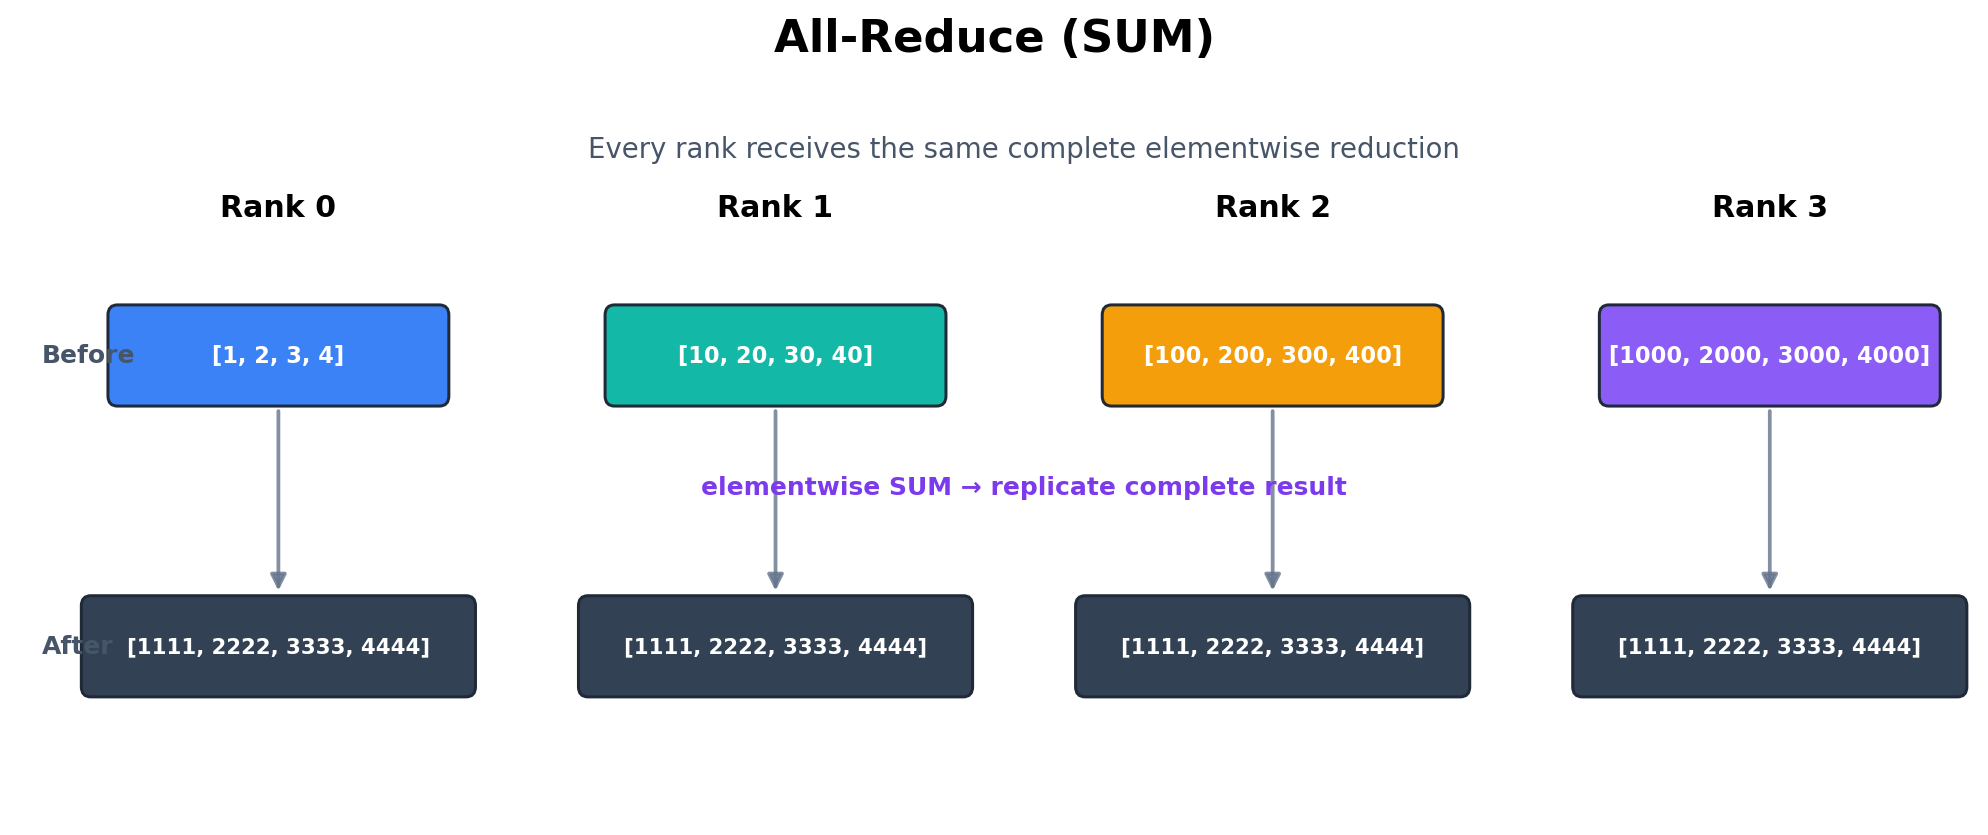
与 Reduce-Scatter 的区别不是“是否求和”,而是结果所有权:All-Reduce 在每个 Rank 保留完整结果,Reduce-Scatter 只在每个 Rank 保留不同结果分片。
5.3 PyTorch Collective 调用形状
import torch
import torch.distributed as dist

rank = dist.get_rank()
world = dist.get_world_size()
device = torch.device("cuda", torch.cuda.current_device())

# Broadcast:仅 src 的初始值会被保留
x = torch.tensor([42.0 if rank == 0 else 0.0], device=device)
dist.broadcast(x, src=0)

# All-Reduce SUM:原地把每个 Rank 的 local 相加
local = torch.tensor([float(rank + 1)], device=device)
dist.all_reduce(local, op=dist.ReduceOp.SUM)
average = local / world  # 需要平均语义时再显式除;DDP 内部会处理自身语义

# All-Gather:每 Rank 输入 [N],每 Rank 输出 [world*N]
shard = torch.full((2,), rank, dtype=torch.float32, device=device)
gathered = torch.empty(world * shard.numel(), device=device)
dist.all_gather_into_tensor(gathered, shard)

# Reduce-Scatter:每 Rank 输入 [world*N],每 Rank 输出 [N]
full = torch.arange(world * 2, dtype=torch.float32, device=device) + rank
reduced_shard = torch.empty(2, device=device)
dist.reduce_scatter_tensor(reduced_shard, full, op=dist.ReduceOp.SUM)
所有 Rank 必须以相同顺序进入 Collective,并满足 API 要求的 shape、dtype 和设备约束。async_op=True 只表示调用可异步返回;真正安全复用输出前仍要正确等待 Work,并确认计算流依赖。
在相同分块语义下,可以把 All-Reduce 理解为 Reduce-Scatter + All-Gather。Ring 算法下,每 Rank 的近似发送量分别为(接收量相同,不把双向字节数再叠加到同一个单向带宽分母):
这是用于直觉估算的 Ring 模型;真实 NCCL 会根据拓扑、消息大小和版本选择 Ring、Tree 等算法。
5.4 延迟—带宽模型
一次 Collective 的时间可以粗略理解为:
α 是每轮通信的启动延迟,V 是传输量,B_effective 是考虑拓扑和竞争后的有效带宽。小 Tensor 往往受延迟支配,因此需要 Bucket 合并;大 Tensor 更受带宽支配,继续合并不一定有益。跨节点通信还可能经过 PCIe、NIC、交换机,多层拓扑中最慢链路决定暴露时间。
判断瓶颈时应分别测量节点内与跨节点:若单机 8 卡扩展良好、多机骤降,优先检查 NIC 带宽、GPU Direct RDMA、Rank 到 NIC/GPU 的亲和性和跨机 Process Group,而不是先改模型算子。
5.5 用 1B 梯度估算通信下限
假设 1B 模型的梯度以 BF16 通信,完整梯度 M=2 GB,8 Rank Ring All-Reduce 每 Rank 近似传输:
若假设单向有效传输带宽为 25 GB/s,完全不重叠时的数据传输时间约为 3.5/25=0.14 s,另需考虑启动延迟与竞争。网卡标称 200 Gb/s 换算为 25 GB/s,但这是链路理论速率;协议与共享链路开销会降低实际可用带宽。
使用 nccl-tests 实测结果时,先确认读的是哪一列。对 All-Reduce,定义为:
algbw 按完整输入大小计,busbw 再乘集合通信修正系数;它不是直接读取某个网口的流量。NVIDIA 带宽定义
假设一次 8 Rank、2 GB All-Reduce 实测耗时 0.14 秒,则:
| 对应口径 | 带宽 | 反算耗时 |
|---|---|---|
algbw | 约 14.29 GB/s | 2/14.29≈0.14 s |
busbw | 25 GB/s | 3.5/25=0.14 s |
把 3.5 GB 除以 algbw 会重复计入 Ring 系数,错误得到约 0.245 秒。实测带宽已由完整操作耗时反推;用它还原同一次测量时,不要再额外加一次启动延迟。迁移到不同消息大小、Rank 数或拓扑时,应重新测量。
这只是单次梯度同步估算。ZeRO-3/FSDP 还要考虑逐模块参数 All-Gather;其总量、次数和暴露比例取决于 wrap、reshard 和 prefetch,而不是只由模型参数量决定。
6. ZeRO-1、ZeRO-2、ZeRO-3
ZeRO 的核心是消除数据并行 Rank 之间重复保存的模型状态:
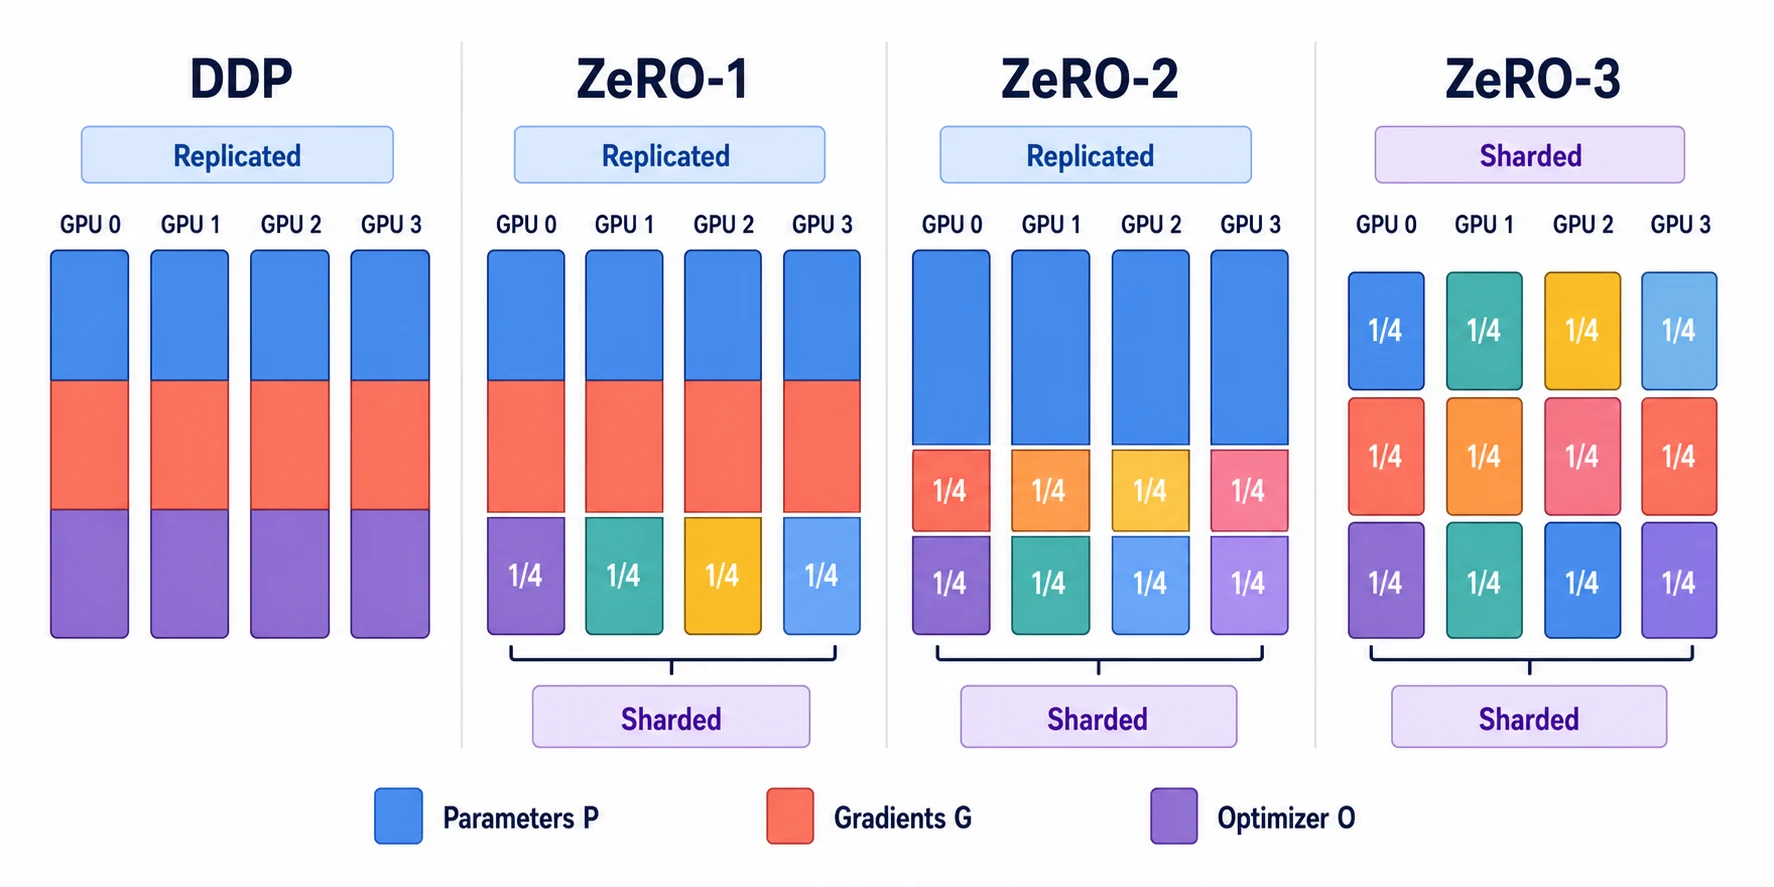
| 策略 | 参数 P | 梯度 G | 优化器 O | 主要新增通信/管理 |
|---|---|---|---|---|
| DDP / ZeRO-0 | 完整 | 完整 | 完整 | 梯度 All-Reduce |
| ZeRO-1 | 完整 | 完整 | 1/K | 更新后同步参数分片 |
| ZeRO-2 | 完整 | 1/K | 1/K | 梯度 Reduce-Scatter |
| ZeRO-3 | 1/K 常驻 | 1/K | 1/K | 计算前 All-Gather 参数,之后重新分片 |
6.1 Stage 3 的常见叫法
规范写法是 ZeRO Stage 3 或 ZeRO-3,而不是 “ZeRO state-3”。在资料和代码中还会看到这些相关名称:
| 名称 | 所属生态 | 与 ZeRO-3 的关系 |
|---|---|---|
| ZeRO Stage 3 / ZeRO-3 | DeepSpeed | 官方 Stage 名称;分片 P/G/O |
| Full Parameter Sharding | 通用描述 | 强调参数也被分片,不特指某个库 |
| Fully Sharded Data Parallel | 通用概念 / PyTorch | 数据并行 Rank 间完整分片模型状态 |
FULL_SHARD | PyTorch FSDP1 | 与 ZeRO-3 核心思想对应的策略名 |
fully_shard | PyTorch FSDP2 | Composable API;实现和状态表示与 FSDP1 不同 |
| ZeRO-Offload | DeepSpeed | 将部分状态或计算卸载到 CPU,不是 ZeRO-4 |
| ZeRO-Infinity | DeepSpeed | 将 CPU/NVMe 纳入异构内存层次,不是新 Stage |
可以说“FSDP Full Shard 与 ZeRO-3 属于同类全分片策略”,但不应说两者是同一个实现。它们的预取、reshard、状态字典、初始化方式和配置项不同。
6.2 如何选择 Stage
按显存账本中最大的可分片项选择 Stage:先判断优化器,再判断梯度,最后判断参数。更高 Stage 节省更多常驻状态,也引入额外的参数聚合与管理。完整选型表集中在第 12 节。
当全分片仍不足时,CPU/NVMe Offload 可以进一步减少 GPU 驻留状态,但要测量 PCIe、主存或存储带宽对 step 时间的影响。
6.3 DeepSpeed ZeRO-3 配置骨架
下面是结构完整的起点配置,不是适用于所有集群的最佳参数:
{
  "train_micro_batch_size_per_gpu": 2,
  "gradient_accumulation_steps": 8,
  "bf16": {"enabled": true},
  "optimizer": {
    "type": "AdamW",
    "params": {"lr": 0.0003, "betas": [0.9, 0.95]}
  },
  "zero_optimization": {
    "stage": 3,
    "overlap_comm": true,
    "contiguous_gradients": true,
    "reduce_bucket_size": 500000000,
    "stage3_prefetch_bucket_size": 50000000,
    "stage3_param_persistence_threshold": 100000
  }
}上面三个数值字段均按元素个数计:reduce_bucket_size 是归约桶大小,stage3_prefetch_bucket_size 是预取参数数量,stage3_param_persistence_threshold 是小参数保持不分片的阈值。500000000 个 BF16 元素的原始数据就有 1 GB,若按 FP32 归约则为 2 GB,且仍未计入并发副本。它不是“约 500 MB”的小桶。DeepSpeed 字段定义
更大的桶可能提高带宽利用率,也会增加峰值并推迟通信启动;overlap_comm=true 还可能同时保留多个缓冲区。先按可用显存缩小到能完成整步的配置,再根据 profiler 调整。
7. FSDP:如何在计算时临时还原参数
PyTorch FSDP 的 Full Shard 与 ZeRO-3 在核心思想上相近:常驻时参数、梯度、优化器状态都分片;某个模块计算前 All-Gather 其完整参数,计算后释放完整副本;反向得到完整局部梯度后用 Reduce-Scatter 归约并只保留本 Rank 分片。
常驻参数 shard
  → All-Gather 当前模块完整参数
  → Forward 当前模块
  → Reshard / 释放完整参数
  → Backward 前再次 All-Gather(取决于策略)
  → Backward 当前模块
  → Reduce-Scatter 梯度
  → 本 Rank optimizer 更新自己的 shard
7.1 FSDP2 最小结构
下面使用 PyTorch 2.8 的 FSDP2 fully_shard API;旧 FullyShardedDataParallel 类通常称为 FSDP1。示例假设完整模型能先放入单卡,以展示包装顺序;更大模型的初始化见第 7.4 节。
import os
import torch
import torch.distributed as dist
from torch.distributed.fsdp import fully_shard, MixedPrecisionPolicy

local_rank = int(os.environ["LOCAL_RANK"])
torch.cuda.set_device(local_rank)
dist.init_process_group("nccl")

model = Transformer(config).to(local_rank)
mp_policy = MixedPrecisionPolicy(
    param_dtype=torch.bfloat16,
    reduce_dtype=torch.float32,
)

# 先从叶子层向根模块应用,形成可预取、可重叠的通信组
for block in model.layers:
    fully_shard(block, mp_policy=mp_policy, reshard_after_forward=True)
fully_shard(model, mp_policy=mp_policy, reshard_after_forward=True)

optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)
实际项目还需要处理 meta-device 初始化、Checkpoint、共享参数、CPU Offload、梯度裁剪和 Hybrid Sharding。Wrap 粒度太大会形成巨型阻塞 All-Gather,太小则产生大量延迟敏感的小通信。
7.2 FSDP 与 ZeRO 的关系
| 概念 | DeepSpeed ZeRO | PyTorch FSDP |
|---|---|---|
| 只分优化器 | ZeRO-1 | 没有完全一一对应的常用 Full Shard 策略 |
| 分梯度和优化器 | ZeRO-2 | FSDP1 SHARD_GRAD_OP 有相似的通信/驻留权衡;FSDP2 需按参数生命周期比较 |
| 分参数、梯度、优化器 | ZeRO-3 | FULL_SHARD / FSDP2 fully_shard |
| Offload | ZeRO-Offload / Infinity | CPU Offload 策略 |
FSDP2 的 reshard_after_forward=False 表示前向后保留完整参数,省去反向前的一次 All-Gather;它并不表示参数从此永久复制在每张卡上。默认反向后仍会重新分片,因此不能将这个开关直接等同于 ZeRO-2。
本文显式设置 True,让流程图与示例一致。在 PyTorch 2.8 中,默认 None 会对根模块采用不在前向后分片的特殊处理,对其他模块采用分片;分析显存时应核对实际配置。FSDP2 参数生命周期
7.3 分布式 Checkpoint
Full Shard 下每个 Rank 只持有状态分片。保存时若先把完整模型和 Adam 状态聚合到 Rank 0,可能在训练已经能运行后反而于 Checkpoint 阶段 OOM,并形成单机内存和存储带宽瓶颈。
优先采用 Sharded State Dict 或 Distributed Checkpoint:各 Rank 并行写自己的分片,并保存模型配置、优化器、Scheduler、global step、随机数状态和数据游标。恢复时还要确认是否支持改变 world_size 重分片。完整权重通常只在导出或推理部署阶段离线合并。
Checkpoint 是 Collective 工作流的一部分:所有 Rank 必须以一致顺序参与。只让 Rank 0 进入一个内部包含 All-Gather 的保存函数,其他 Rank 跳过,可能导致永久等待。
7.4 初始化阶段也可能 OOM
即使稳态分片后能放下,若先在每张 GPU 构造完整模型、再调用 fully_shard,仍可能在包装前 OOM。大模型通常采用 meta device 或 deferred initialization:先创建不分配真实存储的参数结构,再按 Rank materialize 本地分片并加载 Sharded Checkpoint。
同样要警惕 optimizer state 的惰性初始化:Adam 的 m/v 常在第一次 optimizer.step() 才创建,所以仅成功完成 Forward/Backward 不能证明训练显存足够。容量测试至少要跑完若干个完整 step,并包含验证和 Checkpoint。
8. BF16、FP32 与混合精度
“LLM 一般 BF16、Vision 一般 FP32”过于绝对。现代 LLM 常用 BF16 计算是因为动态范围接近 FP32 且 Tensor Core 吞吐高;视觉模型也大量使用 FP16/BF16/TF32 混合精度,只是某些归一化、损失、归约或数值敏感算子可能保留 FP32。
8.1 前向 BF16,不代表梯度一定 FP32
需要分别指定:
| 对象 | 可能 dtype | 谁决定 |
|---|---|---|
| 参数存储/master 参数 | BF16 或 FP32 | 模型加载、优化器、分片框架 |
| Forward/Backward 计算参数 | BF16/FP16/FP32 | autocast 或 FSDP param_dtype |
| 激活 | 混合 | autocast 的算子规则 |
| 局部梯度 | 常跟计算/参数 dtype 相关 | Autograd 与参数配置 |
| 梯度通信 | BF16 或 FP32 | FSDP reduce_dtype;DDP 梯度桶 dtype 或通信 hook |
Optimizer m/v | 常见 FP32,也可低精度 | 优化器实现 |
例如 FSDP 可让 param_dtype=torch.bfloat16,同时令 reduce_dtype=torch.float32;也可以在 BF16 中归约以节省带宽。部分实现会在 optimizer step 前把低精度梯度转回 FP32,但这不是所有训练栈的固定规律。
8.2 模型配置里的 dtype 不等于完整训练策略
以 Qwen 等模型为例,配置中的 torch_dtype 常表示权重保存或默认加载 dtype。from_pretrained(..., torch_dtype=...)、autocast、FSDP MixedPrecision、优化器状态和硬件支持共同决定运行时 dtype。BF16 权重“能加载”不等于所有算子都会用 BF16,也不保证该训练配置数值稳定。
FP16 的指数范围较小,训练常需要 GradScaler;BF16 动态范围接近 FP32,通常不需要 Loss Scaling,但精度尾数更少。归一化、Softmax、Loss、梯度范数和某些 Reduction 使用 FP32 往往更稳。
8.3 不猜 dtype,直接检查
import torch

def print_training_dtypes(model, optimizer):
    parameter = next(p for p in model.parameters() if p.requires_grad)
    print("parameter dtype:", parameter.dtype)
    print("gradient dtype :", None if parameter.grad is None else parameter.grad.dtype)
    state = optimizer.state.get(parameter, {})
    for name, value in state.items():
        if isinstance(value, torch.Tensor):
            print(f"optimizer {name}: shape={tuple(value.shape)}, dtype={value.dtype}")


# 应在 loss.backward() 后查看 gradient;在 optimizer.step() 后查看惰性创建的 m/v
print_training_dtypes(model, optimizer)
还可在 Forward Hook 中打印关键激活 dtype,并用 profiler 查看算子实际 kernel。配置文件、Checkpoint dtype 和 Tensor Core 实际计算精度是三个不同层面。
9. Activation Checkpointing
Activation Checkpointing(也叫 Gradient Checkpointing)不保存选定区域的全部中间激活,反向时重新执行一次前向来恢复它们:
它主要降低 M_A,不会分片参数、梯度或优化器状态。对长序列 Transformer,激活常随 B × S × L × H 增长,Checkpointing 可能比 ZeRO-1 更直接;若模型状态本身放不下,则仍需要 ZeRO/FSDP。
朴素 Attention 若显式保留概率矩阵,还可能包含近似 B × heads × S² 的中间量;FlashAttention 类内核通过分块避免物化完整矩阵,降低这部分峰值。Checkpointing 和 FlashAttention 优化的是不同来源,可以同时使用。
from torch.utils.checkpoint import checkpoint

def forward(self, x):
    for block in self.layers:
        # use_reentrant=False 是现代 PyTorch 常用模式
        x = checkpoint(block, x, use_reentrant=False)
    return x
注意随机数状态、Dropout、自定义 Autograd、原地修改与包含非 Tensor 参数的函数。应以实际吞吐和峰值显存评估粒度,而不是盲目 checkpoint 每个小算子。
10. 让计算覆盖通信,而不是让 GPU 空等
训练优化目标不是简单要求“总计算时间一定大于总通信时间”,而是让每个通信 Bucket 尽早启动,并被之后仍在进行的计算覆盖:
若某个 Bucket 的通信时间小于其后可并行的计算窗口,它大部分可以被隐藏;最后一个 Bucket、过大的 Collective 或慢网络通常形成 exposed communication tail。
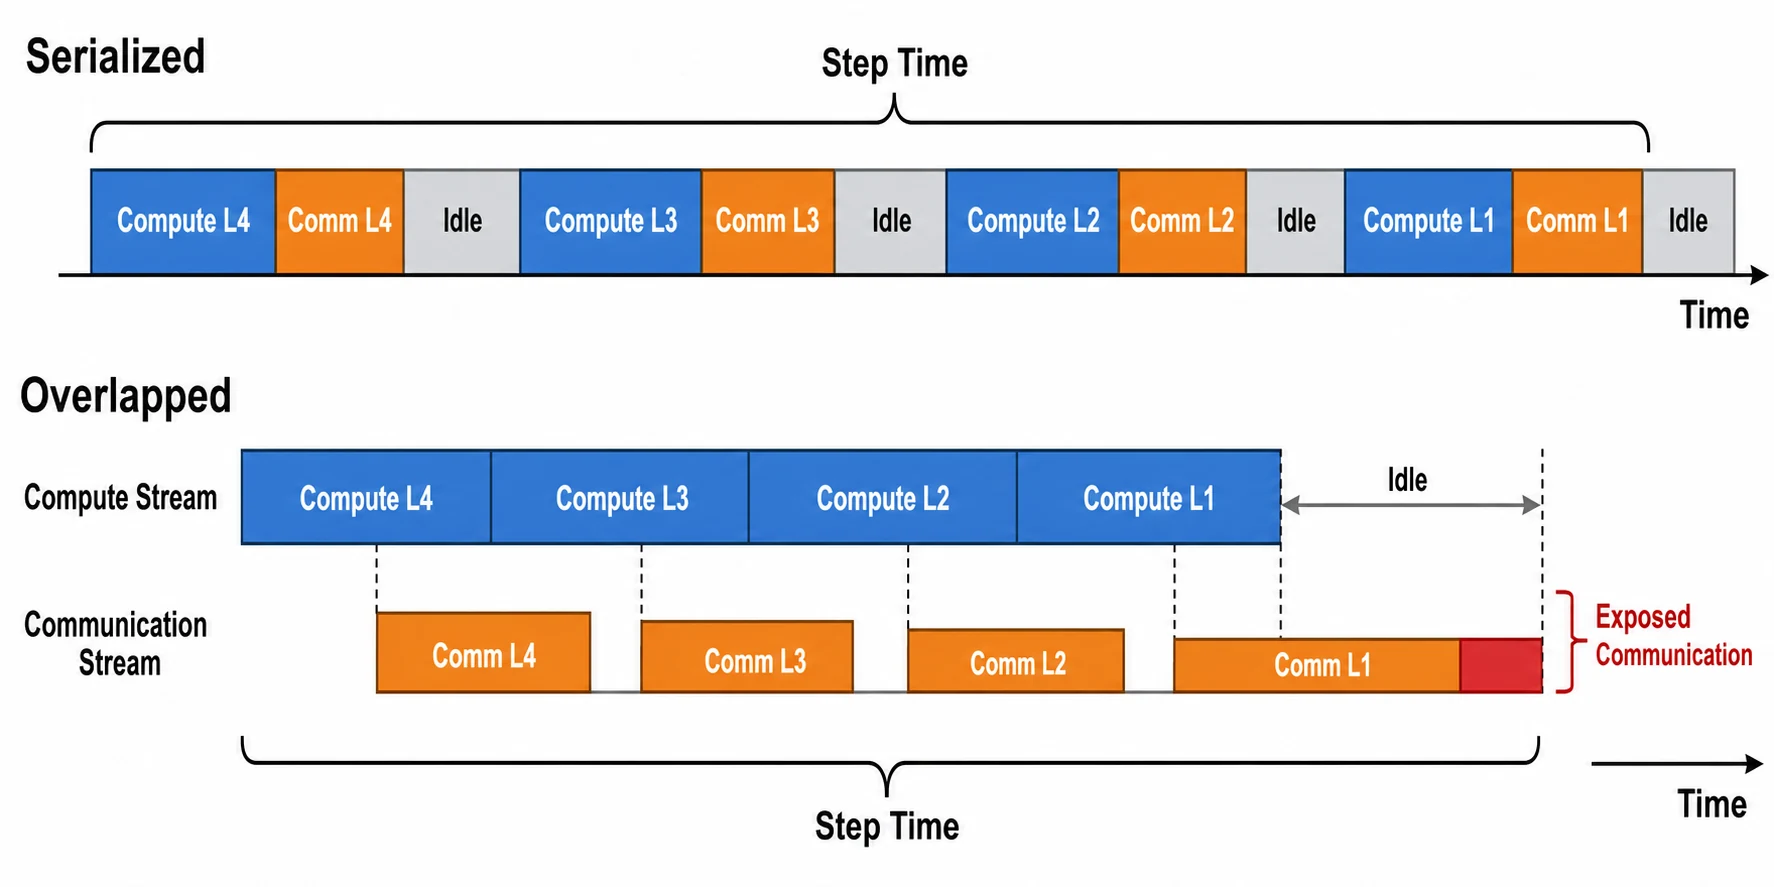
10.1 优先优化顺序
- 先保证计算够大:过小 micro-batch、短序列或大量小 kernel 会降低 GPU 利用率。
- 合理 Bucket/Wrap 粒度:太大则启动晚,太小则延迟和 launch 开销高。
- 避免隐式同步:训练热路径中的
.item()、频繁日志、CPU/GPU 往返会造成空等。 - 利用拓扑:节点内 NVLink/NVSwitch 与跨节点 InfiniBand 带宽差异巨大。
- 预取与重叠:FSDP All-Gather、Reduce-Scatter 与相邻模块计算重叠。
- 再考虑压缩/低精度通信:降低带宽但可能影响收敛或增加转换开销。
推荐用 PyTorch Profiler 或 Nsight Systems 查看 Compute、NCCL kernel 和空隙时间。只看 GPU Utilization 百分比无法判断是通信、数据加载还是 CPU launch 瓶颈。
10.2 吞吐与利用率指标
- Tokens/s 或 Samples/s:记录 Global Batch 和长度分布,并明确计数的是非 padding 输入 token、有效监督 token 还是图像 token;保持比较口径一致。
- Step Time:拆分数据等待、前向、反向、Collective、optimizer 和 checkpoint。
- MFU(Model FLOPs Utilization):模型理论 FLOPs 相对硬件峰值的比例;口径必须一致。
- Scaling Efficiency:若
K₀卡基线吞吐为Q₀,K卡吞吐为Q,则效率为(Q/Q₀)/(K/K₀)。模型放不进单卡时,可用最小可运行卡数组合作为基线。
显存利用率高不等于算力利用率高,GPU Utilization 高也不等于有效模型计算高。长时间运行的 NCCL kernel、数据搬运或低效小 kernel 都可能让监控显示“GPU 很忙”。
11. 显存分配器、碎片与排错
PyTorch CUDA caching allocator 会保留已经申请的显存以便复用:
memory_allocated():活跃 Tensor 真正占用的显存。memory_reserved():分配器向 CUDA 保留的显存,包含可复用空闲块。nvidia-smi:进程占用视角,通常更接近 reserved 而非 allocated。
在目标 GPU 上,先完成初始化及若干完整 warmup step,再测量一个固定窗口。下面的 train_step() 需包含清梯度、前向、反向和优化器更新,是需要替换的任务函数:
import torch

# 此前已完成 warmup;各 Rank 已选定自己的 CUDA device。
device = torch.cuda.current_device()
torch.cuda.synchronize(device)
torch.cuda.reset_peak_memory_stats(device)
for _ in range(3):
    train_step()
torch.cuda.synchronize(device)

allocated = torch.cuda.max_memory_allocated(device) / 2**30
reserved = torch.cuda.max_memory_reserved(device) / 2**30
print(f"peak allocated={allocated:.2f} GiB")
print(f"peak reserved ={reserved:.2f} GiB")
print(torch.cuda.memory_summary(device=device, abbreviated=True))
重置峰值统计只改变计数器,不释放显存。分别记录首次 step 与稳态窗口,才能同时看到 Adam 惰性初始化和日常峰值;验证、保存和恢复也应单独测量。上面两次同步用于限定测量窗口,避免把上一阶段的异步工作混进来。峰值统计 API
多卡容量取各 Rank 峰值中的最大值,并保留发生 OOM 的 Rank 与阶段。max_reserved-max_allocated 的两个峰值可能出现在不同时刻,不能把它当成某一时刻的碎片量;分析差值应在同一采样点读取 memory_reserved() 和 memory_allocated()。
reserved 显著大于 allocated 只说明保留池里有未被活跃 Tensor 使用的空间,正常缓存复用也会出现这一现象。结合 OOM、分配器后端及不可复用的 split blocks 等证据,才能判断碎片是否是主因。PyTorch CUDA 显存管理
处理顺序:
- 找到是否有 Tensor 被列表、闭包、日志或未 detach 的 Loss 意外持有。
- 稳定输入 shape,减少频繁变化的 Batch/Sequence Length。
- 使用
zero_grad(set_to_none=True),避免不必要的梯度清零写入和存储。 - 调整 FSDP 预取、All-Gather 并发和 wrap 粒度,降低瞬时峰值。
- 用
memory_snapshot()查看分配器当前快照;需要历史时,先启用 memory history 记录再导出 snapshot,并注意这些记录看不到所有 CUDA/NCCL 分配。 - 对动态 shape 工作负载评估
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True(本文 PyTorch 2.8 基线的变量名)。
torch.cuda.empty_cache() 只能释放缓存中的空闲块供其他进程使用,不能释放仍被 Tensor 引用的活跃显存,也通常不会让当前程序获得额外可用 Tensor 显存。
11.1 OOM 定位表
| 现象 | 优先检查 |
|---|---|
| Forward 立即 OOM | 参数副本、输入分辨率/序列长度、All-Gather 峰值 |
| Backward 中 OOM | 激活、梯度、Checkpointing、通信 Bucket |
| optimizer.step OOM | Adam 状态首次惰性初始化、FP32 master 参数 |
| 第二步开始增长 | 图被意外保留、Loss 未 .detach()、缓存列表 |
| 只有某个 Rank OOM | 数据长度不均、Rank 0 额外日志/验证/保存完整权重 |
| 多机挂起而非 OOM | Collective 次序/shape 不一致、某 Rank 提前异常、网络问题 |
调试挂起可启用 TORCH_DISTRIBUTED_DEBUG=DETAIL,并检查所有 Rank 是否以相同顺序进入 Collective,且 shape、dtype 符合该原语的约束。不同原语对输入/输出形状的要求并不相同。NCCL Collective 不是某个 Rank 可以随意跳过的普通函数。
12. 如何选择 DDP、ZeRO 和 FSDP
| 情况 | 首选起点 | 原因 |
|---|---|---|
| 完整训练状态轻松放入单卡 | DDP | 路径简单、吞吐通常最好 |
| Adam 状态是主要压力 | ZeRO-1 | 以较小改动分片最大状态项 |
| 参数能放下,梯度+优化器放不下 | ZeRO-2,或评估 FSDP 的驻留策略 | 减少状态冗余;FSDP 的参数生命周期见第 7.2 节 |
| 完整参数本身接近或超过单卡容量 | ZeRO-3 / FSDP Full Shard | 参数按模块临时 All-Gather |
| 节点内快、节点间慢 | Hybrid Shard | 节点内分片、节点间复制以控制跨机通信 |
| 激活远大于模型状态 | Checkpointing、FlashAttention、序列并行 | 仅分片 P/G/O 不解决主要矛盾 |
| 单层参数本身过大 | Tensor Parallel + DP/FSDP | FSDP 临时完整层也可能 OOM |
12.1 一份可比较的实验记录
对每次配置改变,至少保留以下信息;初始化、训练、验证和保存应分别记录峰值:
| 类别 | 应记录的字段 | 用来排除什么误判 |
|---|---|---|
| 模型状态 | 总量、可训练量、各项 dtype、分片组大小 | 把冻结参数或全部 GPU 数代入错误公式 |
| 工作负载 | micro-batch、累积步数、有效 token 数、长度分布 | 减少实际训练数据后误称吞吐提升 |
| 数值正确性 | Loss 归约、梯度范数、optimizer step、学习率 | 扩卡后梯度缩放或 Scheduler 语义改变 |
| 资源与时间 | 每 Rank 峰值、step 时间、有效 tokens/s、暴露通信 | 只看 Rank 0 或 GPU Utilization |
| 恢复能力 | Checkpoint 路径、恢复步数、优化器与采样状态 | 权重能加载却无法接续训练 |
扩卡对照还需说明保持的是 global batch 还是每卡 batch:前者接近固定工作量的强扩展,后者增加了每步总工作量。两类实验的 step 时间不能直接解释成同一种扩展效率。
12.2 当数据并行分片仍然不够
ZeRO/FSDP 属于数据并行维度的状态分片。更大的模型通常把多种并行方式组成二维或三维 Device Mesh:
| 并行维度 | 切分对象 | 主要通信 | 解决的问题 |
|---|---|---|---|
| Tensor Parallel(TP) | 单层矩阵/Head | All-Reduce、Reduce-Scatter、All-Gather | 单层参数或计算无法放入单卡 |
| Pipeline Parallel(PP) | 连续层/Stage | 点对点发送激活与梯度 | 模型深度与参数容量 |
| Context/Sequence Parallel(CP/SP) | 序列维或激活 | Ring/P2P/Collective | 超长序列激活和 Attention |
| Expert Parallel(EP) | MoE Experts | All-to-All | 专家参数与稀疏路由 |
| Data Parallel / FSDP | 数据与模型状态 | AR 或 RS+AG | 提升吞吐并减少副本状态 |
例如可以在节点内做 TP、节点间做 FSDP/DP。并行维度越多,通信组、Checkpoint 和性能调优越复杂;只有确认单一策略的容量或吞吐瓶颈后再叠加下一维。
12.3 从单卡扩到多机的推荐顺序
- 单 GPU 正确性:固定 Seed,小数据过拟合,保存基准 Loss、梯度范数和吞吐。
- 单机 DDP:保持 Global Batch 等价,验证参数更新与单卡数值接近。
- 单机分片:只改变 ZeRO/FSDP 策略,确认峰值显存下降且 Checkpoint 可恢复。
- 多机小规模:先跑短任务,检查所有 Rank step 数、NCCL 错误和扩展效率。
- 加入混合精度与 Checkpointing:每次只改变一个变量,记录数值与性能。
- 最后调 Bucket/Prefetch/Offload:用时间线证据优化 exposed communication。
各阶段沿用第 12.1 节的记录表,并固定一个小规模恢复样本。这样能把收敛变化、容量变化和吞吐变化分别归因到具体配置。
13. 关键结论速查
DDP:     P + G + O 全复制;梯度 All-Reduce
ZeRO-1:  P、G 全复制;O 分片
ZeRO-2:  P 全复制;G、O 分片
ZeRO-3:  P、G、O 分片;计算前按模块 All-Gather P
FSDP:    Full Shard 与 ZeRO-3 核心思想相近;梯度 Reduce-Scatter
AC/GC:   主要减少激活,代价是反向时重算前向
NCCL: 通信后端,不是训练并行策略最稳妥的优化原则是:先测量显存由谁占用,再选择分片对象;先定位暴露通信,再谈重叠;先保证正确性,再追求利用率。
14. 官方参考资料
- PyTorch DistributedDataParallel
- PyTorch 2.8 FSDP2 API
- PyTorch FSDP2 Tutorial
- PyTorch 2.8 FSDP1 API
- NVIDIA NCCL Collective Operations
- DeepSpeed ZeRO Documentation
- PyTorch CUDA Memory Management
阅读自测与验收
- 按实际 dtype 分别列出参数、梯度、优化器状态和激活;把估算与同一训练阶段的峰值测量比较,不混用 GB 与 GiB。
- 保存并恢复一次小规模训练,检查步数、优化器状态及各 Rank 的一致性;只恢复权重不能证明训练可续跑。
展开核对:显存与累积算例
- 1B、8 卡、每参数 16 Byte 的全参数训练账本:DDP 16 GB,ZeRO-1 5.5 GB,ZeRO-2 3.75 GB,ZeRO-3 理论下限 2 GB/卡。
- 总量 1B、其中 10M 可训练,按第 3.4 节的 dtype 假设,未分片持久状态为 2.14 GB;冻结后层仍能把梯度传回可训练前层。
- 10 个等权 micro-batch、累积 4 次,对应
4、4、2三个窗口,最后一个窗口除以 2。 - 100 与 300 个有效 token 的两个 Rank,应按
1/4、3/4贡献全局 token mean;直接平均两个本地 mean 会改变目标权重。